Numpy和Pandas,Matplotlib(或 Scikit-learn)并称为数据分析中主要的三个核心库。它提供了大量方法,能够快速地求得某些统计值,以及实现对不同向量、矩阵的计算。
Numpy的安装
- 通过Python的pip命令安装
pip install --upgrade pip #先升级pip
pip install numpy #安装最新版本的numpy
或
pip install numpy==version #指定版本号,version为要安装的版本号- 安装Anaconda
Anaconda集成了大量Python常用库,如Numpy,Pandas等。如果要安装特定版本的库,只需要在Anaconda Navigator中搜索即可,如图所示。
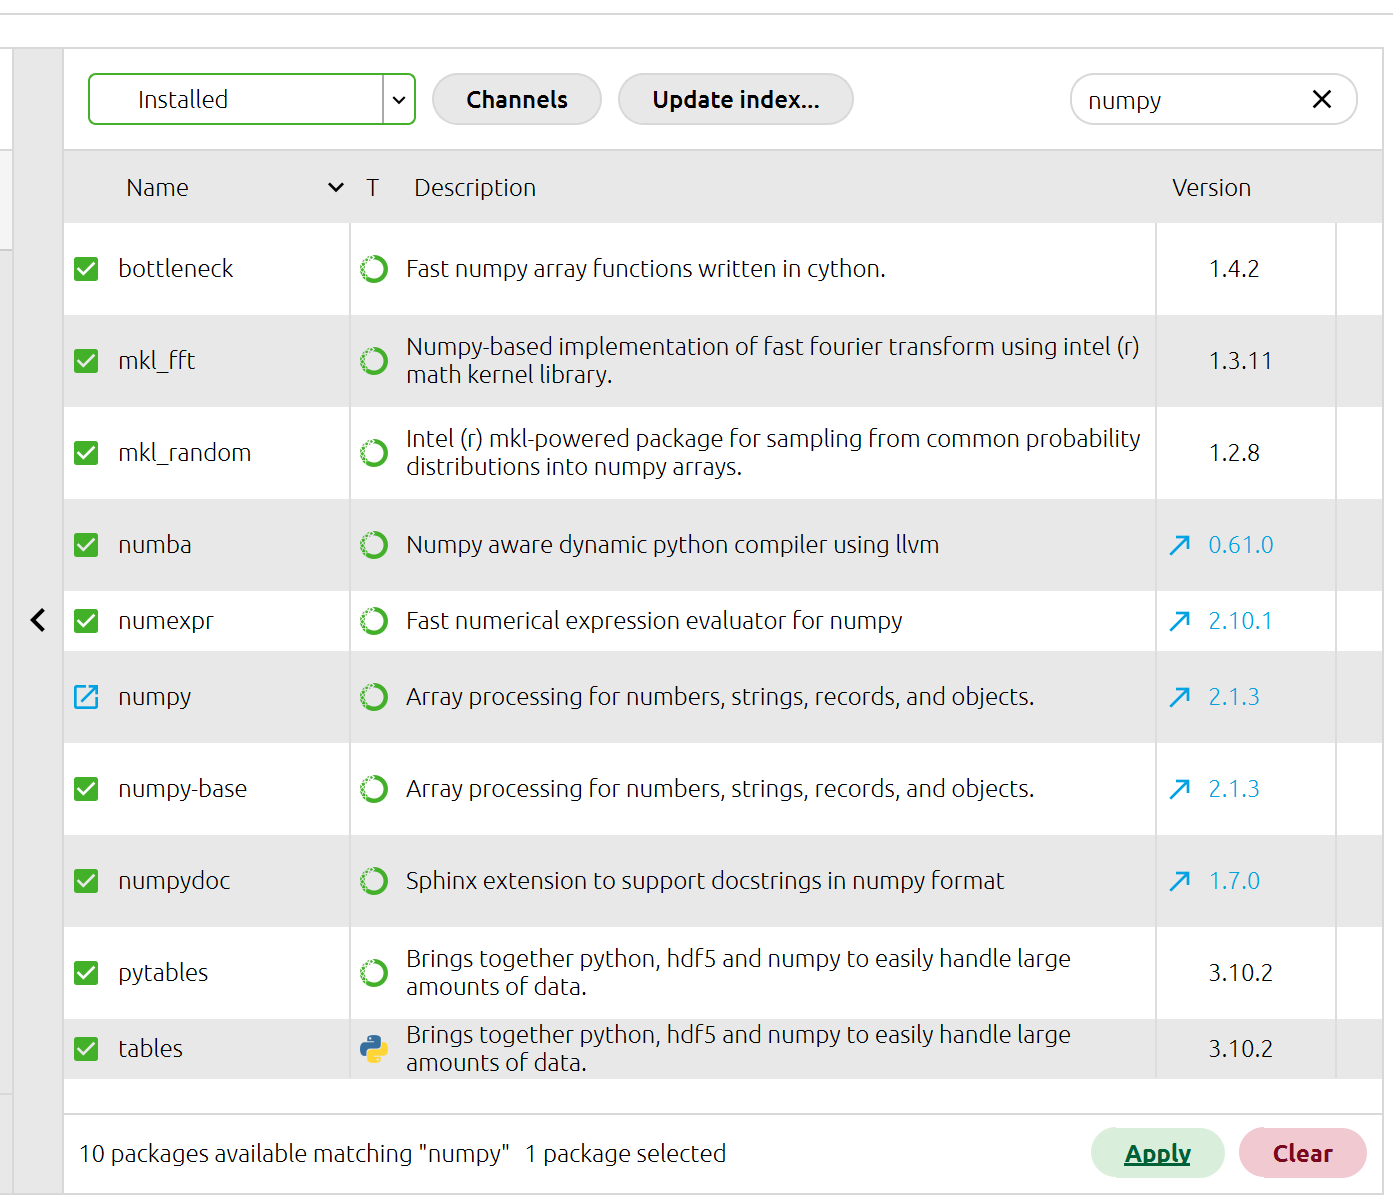
方法一可以只安装需要的Numpy库,对电脑的存储空间要求较小,但是操作相对来说更繁琐一些。方法二安装Anaconda,由于集成了大量库,故对存储空间的要求相对高得多,但是操作较为便捷。使用者可以根据自己的实际情况选择安装方法。
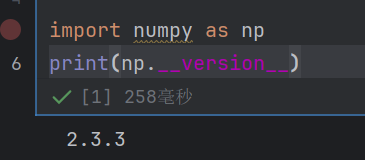
安装后,可通过下列命令判断是否安装成功:
import numpy as np
print(np.__version__)
若安装成功,将会输出所安装的版本号,如图所示:
Numpy的使用
下文大部分代码均是在导入了numpy库的前提下才能使用的,在成功安装numpy后,导入代码如下:
import numpy as np1.ndarray
ndarray是通过Numpy创造出来的数组,它具有多维性、同质性、高效性的特点。ndarray最基本的生成命令为:
#零维(标量)
arr0 = np.array(nums)
#一维(向量)
arr1 = np.array([nums1,nums2,nums3])
#二维(矩阵)
arr2 = np.array([[nums1,nums2,nums3],[nums4,nums5,nums6]])
下文将介绍更多种类型的命令。
ndarray三个特性的具体含义如下。
① 多维性
指的是ndarray支持多种维度,如0维(一个数)、1维(一个向量)、2维(矩阵)或更高维。
对于上文生成的三个数组,获取其维度,结果如下:
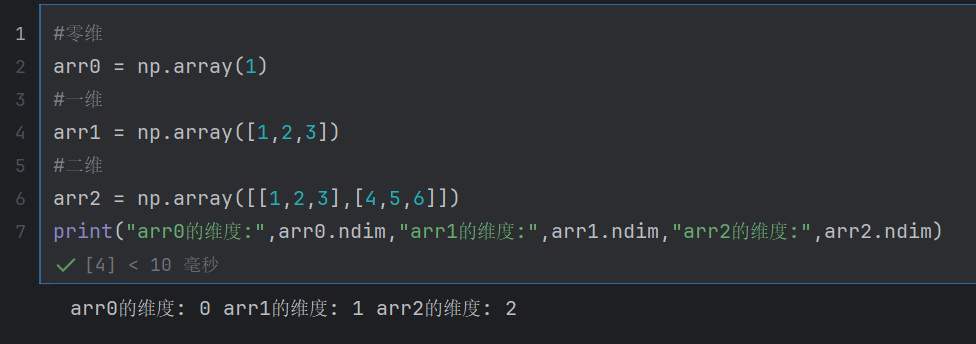
② 同质性
指的是ndarray当中所有元素的类型都是一样的,不像Python的原生列表,列表中的元素可以涵盖从整型到字符串的多种元素。
将元素1,和其它不同类型的元素组成列表,并生成一个ndarray,可以看到三个均包含元素1的ndarray的类型如图所示:
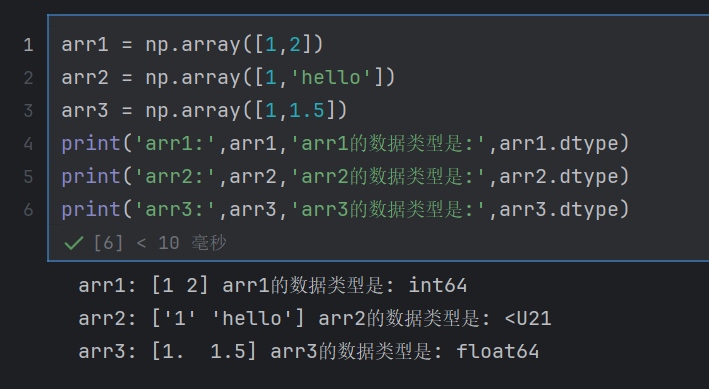
ndarray自动将元素的类型进行了转换。
③ 高效性
ndarray基于连续的内存块存储,支持矩阵的乘法,矩阵的快速切片等。
2.ndarray的创建
通过Numpy的不同方法可以创建各种各样的ndarray,具体如下所示:
① 最基本的创建方法
如第一部分ndarray所示,通过array方法可以自定义创建不同维度的ndarray。
arr0 = np.array(1) #0维标量
arr1 = np.array([1,2]) #1维向量
arr2 = np.array([[1,2],[3,4]]) #2维矩阵在有了一个ndarray后,若想复制这个ndarray的值,可以使用copy( )方法,如下所示:
arr3 = np.copy(arr2)copy方法只复制ndarray的值,不复制地址。也就是说两者之间自身的改动并不影响对方的值。
② 预定义数组的形状
a) 创建一个全0,全1的数组
arr_0 = np.zeros(shape=(3,4),dtype=int) #shape可省略
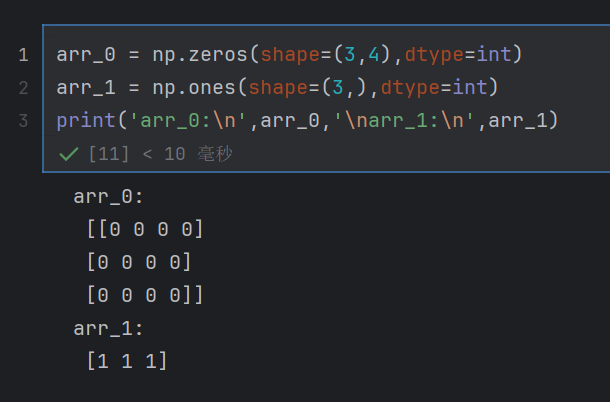
arr_1 = np.ones(shape=(3,),dtype=int) #shape可省略通过zeros( )和ones( )方法创建全 0 和全 1 的数组。方法的 shape 参数决定了数组的形状,dtype参数决定了数组的元素类型,默认为浮点型。对于参数shape,shape=3和shape=(3 , )的写法在实现效果上完全一样,均代表创建一个一维行向量,且这个行向量的长度为3,但是带括号能使得写法更为统一。
输出arr_0和arr_1的结果如下图所示:
b) 创建一个未初始的数组
有时候只需要创建一个未初始化的数组,而无需定义具体的值,可以使用empty( )方法。
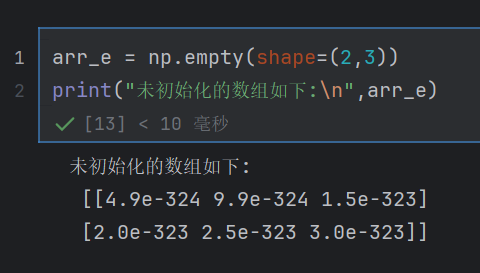
arr_e = np.empty(shape=(2,3)) #shape可省略同样通过shape参数决定数组的形状,但由于元素未初始化,所以每次运行时,数组内元素的结果将是随机的,如下图所示:
c) 创建一个全为固定值的数组
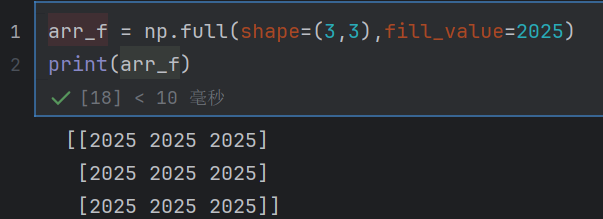
如果希望数组内的填充元素既非0又非1,可以通过full( )方法来指定需要创建的数组规模以及填充的元素。
arr_f = np.full(shape=(3,3),fill_value=2025) #shape和fill_value可省略shape参数指定数组形状,fill_value指定需要填充的值。运行结果如下图所示:
d) 根据已知数组创造同型全0数组
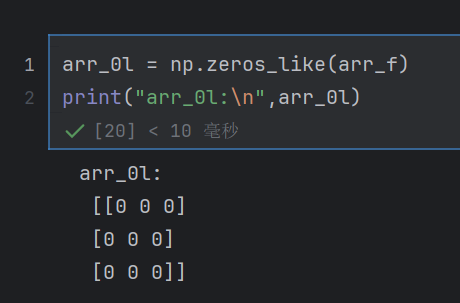
如果想要创造一个全零数组,且该全零数组的形状和某个已有数组的形状一样,可以使用zeros_like( )方法。如创造一个如arr_f一样的3*3全零数组:
arr_0l = np.zeros_like(arr_f)输出arr_0l结果如下图所示:
③ 创建特殊的等间距数组
a) 已知步长,创建元素为等差数列的数组
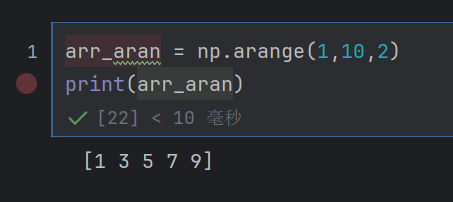
使用arange(start,end,step)方法,创建出来的数组元素的范围为[start,end),左闭右开。start为数组的开始元素,end - 1为数组的结尾元素,step为该等差数列的步长。
arr_aran = np.arange(1,10,2)上述代码创建了一个元素为等差数列的数组。数组元素从1开始,到9结束,公差为2。打印数组结果如下图所示:
b) 知道所需元素的首尾和个数,创建元素间隔相同的数组
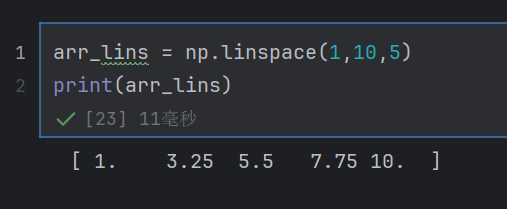
使用linspace(start,end,num)方法,创建出来的数组元素范围为[start,end],左闭右闭。start为数组的开始元素,end为数组的结尾元素,num为数组的元素个数。
arr_lins = np.linspace(1,10,5)上述代码创建了一个长度为5,以1开头,以10结尾的等间隔数组。打印数组结果如下图所示:
如果在此基础上,需要继续求底数base的各个元素次方,可以使用logspace(start,end,num,base)方法,该方法先和linspace( )方法一样,创建出等间隔数组,再将base的每个数组元素次方作为结果存入数组中。打印数组结果如下图所示:
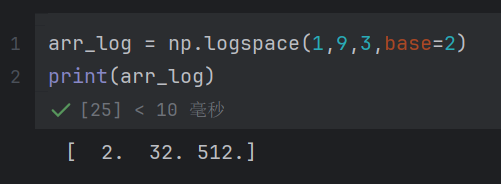
④ 创建特殊矩阵
a) 创建n维单位矩阵
arr_e = np.eye(3)eye( )方法创建了一个3维的单位矩阵,打印矩阵结果如下图所示:
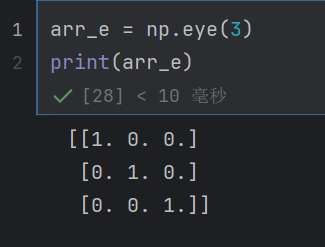
b) 自定义创建对角矩阵
arr_d = np.diag([5,1,2,3])对角矩阵为除了主对角线以外,其余元素均为0的矩阵。diag( )方法通过接收对角线元素列表,创建一个维数等于对角线元素列表长度的对角矩阵。打印矩阵结果如下图所示:
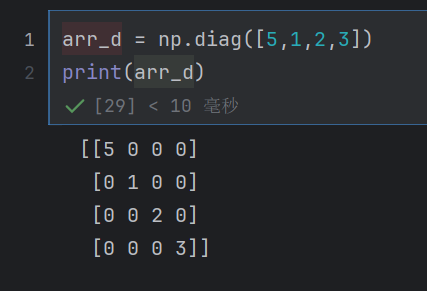
⑤ 创建随机数组
a) 生成[0,1)之间的指定形状的浮点型数组
arr_01f = np.random.rand(2,3)使用random.rand( row,column)方法,参数row代表要生成的行数,参数column代表要生成的列数。打印数组结果如下图所示:
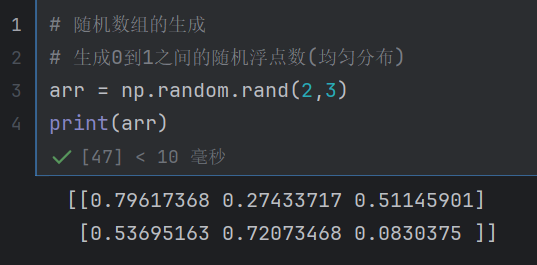
数组中的元素符合[0,1)之间的均匀分布。
b) 生成指定区间的指定形状的浮点型数组
arr_u = np.random.uniform(3,4,(2,3))使用random.uniform(start,end,shape)方法。上面这行代码将生成大小为2*3,元素为[3,4)之间的浮点数的数组。打印数组结果如下图所示:
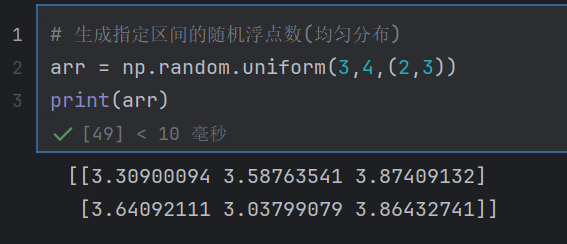
数组中的元素符合[3,4)之间的均匀分布。
c) 生成指定区间的指定形状的整型数组
arr_i = np.random.randint(1,10,(3,3))使用random.randint(start,end,shape)方法。上面这行代码将生成大小3*3,元素为[1,10)之间的整型的数组。打印数组结果如下图所示:
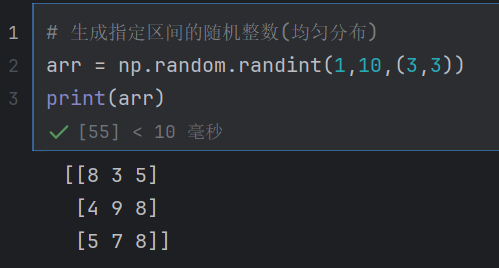
数组中的元素符合[1,10)之间的均匀分布。
d) 生成服从正态分布的数组
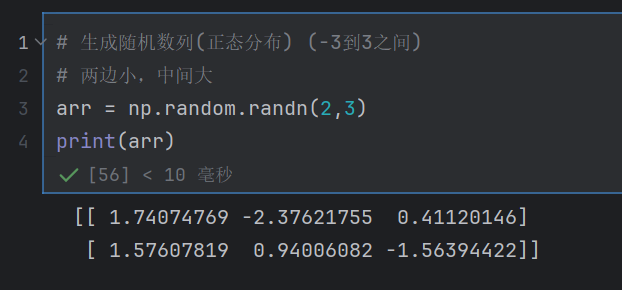
arr_nd = np.random.randn(3,3)使用random.randn(shape)方法。上面这行代码将生成大小3*3,元素服从均值为0,标准差为1的标准正态分布的数组。打印数组结果如下图所示:
e) 固定随机生成的数组
有时候若想一直使用某个随机生成的数组,那么可以在使用上述random.方法之前,给numpy设置一个种子。
np.random.seed(1)设置了种子之后,无论执行多少次random.方法,最后生成的数组结果都是一样的。
3.ndarray的属性
在使用Numpy创建了ndarray后,可以通过数组名.属性的方法获取对应的属性。
假设有一个ndarray,数组名为arr,则它具有下列几个主要的属性:
| 属性名 | 调用方式 | 效果 |
|---|---|---|
| 维度 | arr.ndim | 获得当前数组的维度 |
| 类型 | arr.dtype | 获得当前数组的元素类型 |
| 形状 | arr.shape | 获得当前数组的形状 如(3,4)代表三行四列 |
| 大小 | arr.size | 获得当前数组中的元素个数 |
| 转置 | arr.T | 将当前数组转置(需要数组为矩阵) |
| 元素字节大小 | arr.itemsize | 获得当前数组的元素字节大小 |
4.ndarray的数据类型
| 类型 | 表达式 |
|---|---|
| 布尔 | bool |
| 整型 | int(有符号整型) unit(无符号整型) |
| 浮点 | float |
| 复数 | complex |
每种数据类型根据定义的位数不同,所能表示的范围也有所不同。
5.ndarray的索引和切片
ndarray可以同时对行,列向量进行切片,同python的原生列表一样,使用[:]对数组进行切片。
一维ndarray的索引和普通数组并无区别,下标从0开始,到len(ndarray)结束。
对于一个一维的ndarray,数组名为arr1,长度大于8。假设要获得其第5到第8个元素,使用下列方式进行切片:
arr_c = arr1[4:8]切片arr1[start:end],取到的是下标为[start,end - 1]的子数组。故该代码可取到下标为[4:7]的子数组,正好对应第5到第8个元素。将arr_c打印,结果如下图所示:
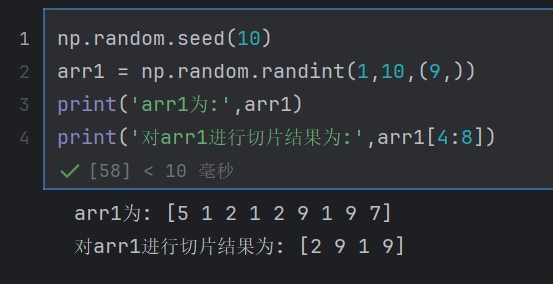
ndarray切片返回的值为其视图,也就是修改切片,ndarray也会一起被修改。
对于ndarray来说,切片的内容可以通过布尔索引进行自定义。
假设我需要找出一个名称为arr1的ndarray中的所有值大于5的元素,则可以通过:
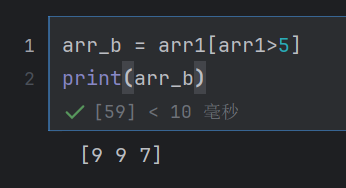
arr_b = arr1[arr1>5]这种方式叫做布尔索引。形式如arr[一个和arr规模一样的Bool类型数组]。在使用布尔索引的过程中,数组的每一个元素都对应一个布尔值,只有该值为True,对应的元素才会被保留。
对于该代码,arr1>5首先生成了一个和arr1规模一样的bool类型数组,只有元素的值大于5,对应位置的bool值才为Ture。这个数组作为布尔索引的布尔矩阵,并保留符合条件的值并赋给arr_b。输出结果如下图所示:
布尔索引返回的值为其副本,也就是修改得到的数组,ndarray不会一起被修改。
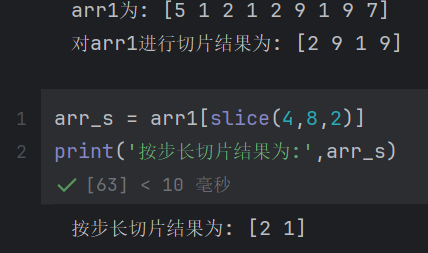
如果切片的对象不是连续值,而是某一个区间内索引长度固定的离散值,可以使用arr[slice(start,end,step)]方法:
arr_s = arr1[slice(4,8,2)] 该方法将相隔两个元素输出arr1下标为[4:7]的元素,输出结果如下图所示:
二维ndarray的索引方式为ndarray[1,3]。这表示直接获得该数组的第二行第四个元素。使用ndarray[1][3]虽然也可以获得相应的元素,但这种方法的实现逻辑是先生成ndarrat[1]这个中间数组,再从这个中间数组中找到第4个元素,效率较低。
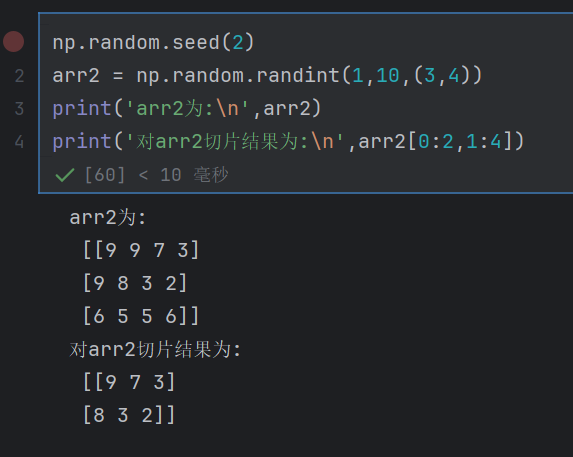
ndarray也支持对二维数组的快速切片,假设有一个规模为3*4的二维数组arr2。要对其第一行到第二行、第二列到第四列切片。具体的方法如下:
arr_a = arr2[0:2,1:4]行列的下标输入方法和一维切片完全一致,通过形如arr2[起始行下标:结尾行下标 + 1,起始列下标:起始列下标 + 1]的方式,实现对二维数组的行列同时切片。二维数组切片结果如下图所示:
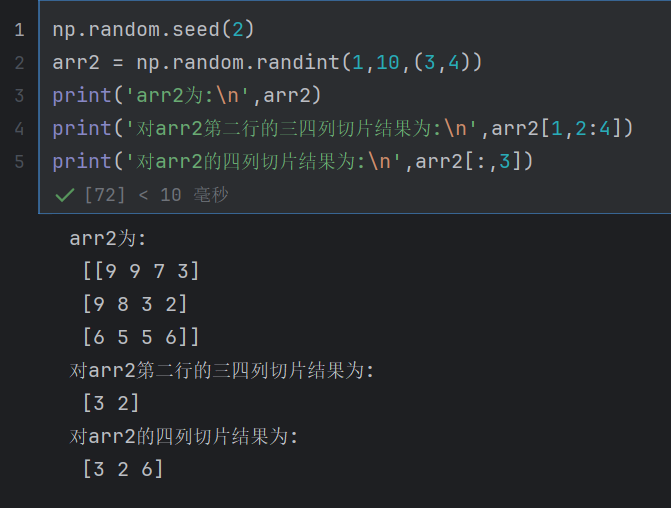
二维ndarray也可以只对行或者列切片,具体的方法如下:
#对某一行的特定列切片
arr2[1,2:4]
#对某一列切片
arr2[:,2]
对行或列切片结果如图所示:
6.ndarray的计算
假设有两个同型二维数组arr1和arr2,以这两个数组为例说明ndarray的计算。
| 计算方式 | 表达式 | 结果 |
|---|---|---|
| 求和 | arr1 + arr2 | 两矩阵对应元素相加 |
| 做差 | arr1 - arr2 | 两矩阵对应元素相减 |
| 乘法 | arr1 * arr2 | 两矩阵对应元素相乘 |
| 除法 | arr1 / arr2 | 两矩阵对应元素相除 |
| 矩阵乘法 | arr1 @ arr2 | 两矩阵做矩阵乘法 |
对矩阵乘法的补充:对于规模为a * b的矩阵A和规模为c * d的矩阵B,只有当b = c时,才能有A * B = C,且C的规模为a * d。
C矩阵的第(i,j)项由,A矩阵的第i行(i <= a)和B矩阵的第j列(j <= d)逐项相乘再相加得到。
对于不同型的二维数组arr3和arr4,假设arr3的规模为m*n,arr4的规模为a*b。两个二维数组要想做对应运算需要满足下列条件之一:
m = a 且 n = b
m != a 但 m 和 a 当中有一个为1,n = b
m = a,n != b 但 n 和 b 当中有一个为1
m != a 但 m 和 a 当中有一个为1,n != b 但 n 和 b 当中有一个为1
这种机制叫做广播。当判断两个二维数组不同型,但是又满足上述条件之一,ndarray会自动将其扩充成同型数组。
假设arr3的规模是3 * 4,arr4的规模是1 * 4。这符合上述第二种情况,arr4会被扩充为规模为3 * 4的数组,并做对应运算,以加法为例,运算结果如下图所示:
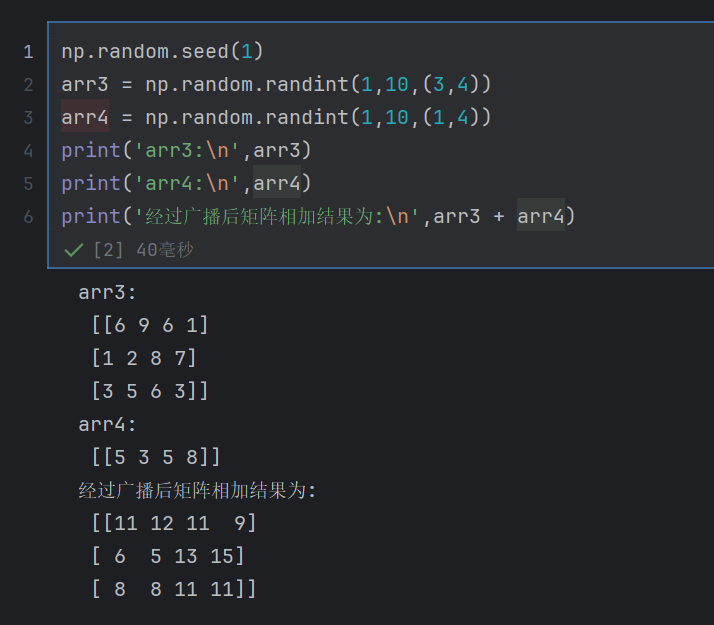
可以看到运算结果是arr3和arr4经过广播后得到的一个规模为3 * 4,且每一行均为[5,3,5,8]的矩阵相加得来的。
再假设arr3的规模是1* 4,arr4的规模是4 * 1。这符合上述第四种情况,arr3和arr4均会被扩充为规模为4 * 4的数组,并做对应运算,以加法为例,运算结果如下图所示:
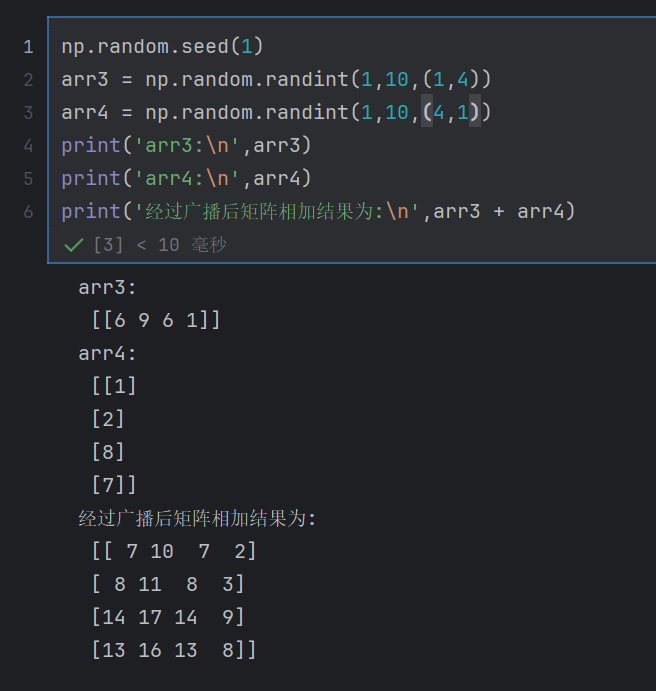
可以看到运算结果是由一个每一行均为[6,9,6,1]的4 * 4矩阵和一个每一列均为[1,2,8,7]的4 * 4矩阵相加得来的。这两个矩阵分别由arr3和arr4广播得到。
7.Numpy常用的数学方法
Numpy常用的数学方法如下表所示:
| 方法名 | 方法效果 | 使用方式 | 输出结果 |
|---|---|---|---|
| sqrt(x) | 对一个数或数组开方 | np.sqrt(9) np.sqrt([1,4,9,16]) |
3 [1,2,3,4] |
| exp(x) | 计算e的x次方 | np.exp(2) | e² |
| log(x) | 计算lnx | np.log(2) | ln2 |
| sin(x)/cos(x) | 计算正弦值/余弦值 | np.sin(1)/np.cos(1) | sin1/cos1 |
| abs(x) | 计算一个数或数组的绝对值 | np.abs(-1) np.abs([-2,-3,-4,-5]) |
1 [2,3,4,5] |
| power(a,b) | 计算a的b次方 | np.power(2,3) | 8 |
| round(x) | 四舍五入(采用银行家四舍五入法) | np.round([3.2,4.5,8.1,9.6]) | [3,4,8,10] |
| ceil(x) | 对x向上取整 | np.ceil(9.1) np.ceil([1.2,4.1,7.2]) |
10 [2,5,7] |
| floor(x) | 对向下取整 | np.floor(9.1) np.floor([1.2,4.1,7.2] |
9 [1,4,7] |
| isnan(array) | 判断一个数是否缺失值,返回一个bool值 检测数组中是否有缺失值,输出一个bool数组 |
np.isnan([1,2,np.nan,3]) | [False,False,TRUE,False] |
isnan(array)方法的使用场景:在读取大量数据元素时,数据难免会有缺失值,Numpy会用np.nan填充这些缺失值,此时可以使用isnan(array)方法加布尔索引的方式快速找出非空元素。
8.Numpy常用的统计方法
Numpy常用的统计方法如下表所示:
| 方法名 | 方法效果 | 使用方式 | 输出结果 |
|---|---|---|---|
| sum(array) | 求和 | np.sum([1,4,9,16]) | 30 |
| mean(array) | 计算平均值 | np.mean([1,4,16]) | 7 |
| median(array) | 计算中位数 | np.mean([1,4,5,6]) | 4.5 |
| var(array) | 计算方差 | np.var([1,2,3,4]) | 1.25 |
| std(array) | 计算标准差 | np.std([1,2,3,4]) | 1.11 |
| max(array) | 计算最大值 | np.max([1,3,4,1]) | 4 |
| argmax(array) | 计算第一个最大值的索引 | np.argmax([1,3,4,1]) | 2 |
| min(array) | 计算最小值 | np.min[1,3,4,1]) | 1 |
| argmin(array) | 计算第一个最小值的索引 | np.argmin([1,3,4,1]) | 0 |
| percentile(array,n) | 计算arr的分位数 | np.percentile([1,2,3,4],25) | 1.75 |
| cumsum(array) | 计算数组的累积和 | np.cumsum([1,2,3,4]) | [1,3,6,10] |
| cumprod(array) | 计算数组的累积积 | np.cumprod([1,2,3,4]) | [1,2,6,24] |
上述统计方法大部分都带有一个axis参数,通过指定axis = 0,可以只统计每一列的数学值、通过指定axis = 1,可以只统计每一行的数学值。如要求一个2 * 3的二维数组的每一行的最大值:
np.random.seed(10)
arr_m = np.random.randint(1,10,(2,3))
arr_mr = np.max(arr_m,axis=1)
打印数组结果如下图所示:
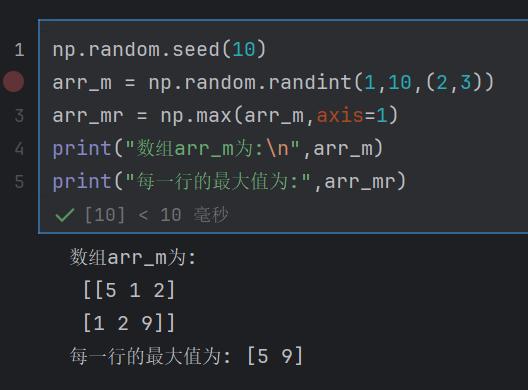
这种方式依然适用于其它统计方法。
分位数指的是对于给定数组,找到一个数,使得至少有n%的数小于它,至少有(100- n)%的数大于它。Numpy的percentile(array,n)方法分为两个步骤:
将数组排序
计算(len(array) - 1)* (n / 100),n为输入的数。
若结果恰为整数a,返回array[a]
若结果不为整数,为一个浮点数b,且i < b < j,设b = i + f,i为b的整数部分,f为b的小数部分。则返回array[i] + (arr[j] - arr[i]) * f
9.Numpy的比较方法
Numpy的比较方法通常返回一个bool数组,常用的比较方法如下表所示:
| 方法名 | 方法效果 | 使用方式 | 输出结果 |
|---|---|---|---|
| great(array,num) | 判断array中的每个元素是否大于num | np.greater([3,4,5],4) | [False False True] |
| less(array,num) | 判断array中的每个元素是否小于num | np.less([3,3,5],4) | [ True True False] |
| equal(array,num) | 判断array中的每个元素是否等于num | np.equal([3,4,5],4) | [False False True] |
| logical_and(arr1,arr2) | arr1和arr2中的对应元素进行逻辑与 | np.logical_and([1,0],[1,1]) | [True,False] |
| logical_or(arr1,arr2) | arr1和arr2中的对应元素进行逻辑或 | np.logical_or([1,0],[1,1]) | [True,True] |
| logical_not(array) | 对array中的每个元素真值取反 | np.logical_not([1,0]) | [False,True] |
| any(array) | 判断array中有没有一个元素为真 | np.any([0,0,0,1]) | True |
| all(array) | 判断array中是否所有元素为真 | np.all([1,1,1,0] | False |
对于每一个比较方法,作为参数的两个数组依然具有广播机制。即,哪怕两数组不同型,但只要符合上文四点之一,就可以进行比较。
10.Numpy的其它方法
Numpy的一些其它常用方法如下表所示:
| 方法名 | 方法效果 | 使用方式 | 输出结果 |
|---|---|---|---|
| where(condition, x, y) | 见下文 | 见下文 | 见下文 |
| select(condlist, choicelist, default=0) | 见下文 | 见下文 | 见下文 |
| sort(arr) | 排序(不改变数组本身,只是返回副本) | np.sort([3,5,1,6]) | [1,3,5,6] |
| argsort(arr) | 返回有序数组对应的原数组元素索引 | np.argsort([3,5,1,6]) | [2,0,1,3] |
| unique(arr) | 排序并去重 | np.unique([1,2,1,3,2]) | [1,2,3] |
| concatenate((arr,arr1)) | 将arr和arr1拼接 | np.concatenate((arr,arr1)) | [arr,arr1] |
| reshape(arr,(n,m)) | 将arr重塑成n * m的形状 | np.reshape([1,2,3,4],(2,2)) | [[1,2],[3,4]] |
| column_stack(arr_1,arr_2) | 按列堆叠数组 | np.column_stack([1,2,3],[4,5,6]) | [[1,4],[2,5],[3,6]] |
| save(‘sa.npy’,data) | 保存数组到文件 | np.save(‘sa.npy’,data) | 工作目录生成sa.npy |
| load(‘sa.npy’) | 读取数组文件 | np.load(‘sa.npy’) | 读取sa.npy中的数组 |
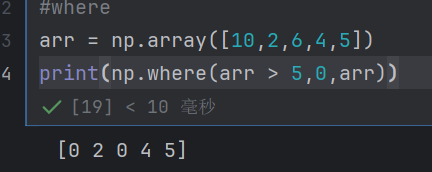
where(condition, x, y)的condition参数是一个bool类型的数组(或可以转换为bool类型数组的表达式)。它将数组中为True的值替换成x,将数组中为False的值替换为y,并在最后返回一个和condition同型的数组,常用于将数组中的某些值全部替换成另一种值。比如要把某个数组arr中大于5的元素全部替换成0,代码如下:
np.where(arr>5,0,arr)运行结果如下图所示:
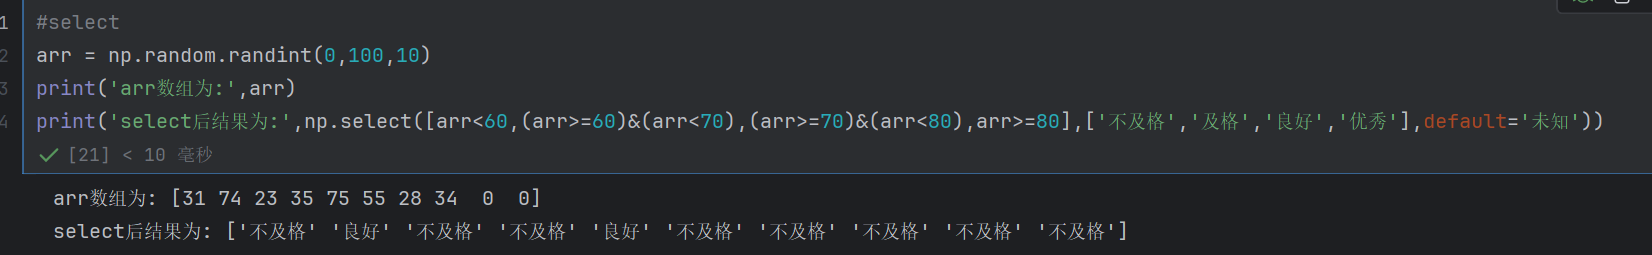
select(condlist, choicelist, default=0)适用于需要根据多个条件从不同数组中选择元素的场景。给出一个条件列表,一个选择列表,一个默认值(类似于switch - case),数组中元素依次判断是否符合condlist中的条件,若符合下标为a的条件,就将该元素替换成choicelist中下标为a的元素,若所有条件都不符合则替换成default。假设给定一个成绩列表,要对不同分数段给出评级,代码如下:
arr = np.random.randint(0,100,10)
np.select([arr<60,(arr>=60)&(arr<70),(arr>=70)&(arr<80),arr>=80],['不及格','及格','良好','优秀'],default='未知')
运行结果如下图所示:
column_stack(arr_1,arr_2)不支持广播,使用的条件是arr_1和arr_2的行数相同。若arr_1和arr_2是两个一维行向量,则会先转置为一维列向量再堆叠。
Numpy练习题
题目一:温度数据分析
某城市一周的最高气温(°c)为[28,30,29,31,32,30,29]
- 计算平均气温、最高气温和最低气温
- 找出气温超过30°c的天数
解题代码如下:
temp = np.array([28,30,29,31,32,30,29])
#平均气温
print('平均气温:','%.3f'%np.mean(temp))
#最高气温
print('最高气温:',np.max(temp))
#最低气温
print('最低气温:',np.min(temp))
#气温超过三十度的天数
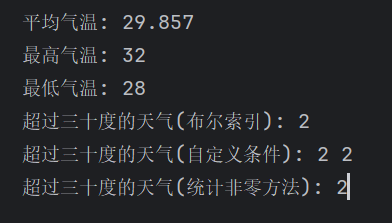
print('超过三十度的天气(布尔索引):',temp[temp > 30].size)
print('超过三十度的天气(自定义条件):',np.sum(np.where(temp>30,1,0)),np.cumsum(np.where(temp>30,1,0))[-1])
print('超过三十度的天气(统计非零方法):',np.count_nonzero(np.where(temp>30,temp,0)))
输出结果如下:
题目二:学生成绩统计
某班级5名同学的数学成绩为[85,90,78,92,88]
- 计算成绩的平均分、中位数、标准差
- 将成绩转换为十分制(假设满分为10分)
解题代码如下:
score = np.array([85,90,78,92,88])
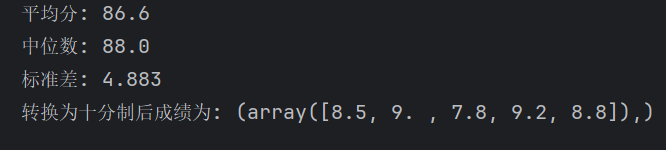
print("平均分:",np.mean(score))
print("中位数:",np.median(score))
print("标准差:",'%.3f'%np.std(score))

print('转换为十分制后成绩为:',(score / 10))
输出结果如下:
题目三:矩阵运算
给定矩阵A = [[1,2],[3,4]] 和B = [[5,6],[7,8]]
- 计算A + B和A * B(逐元素乘法)
- 计算 A 和 B 的矩阵乘法(点积)
解题代码如下:
A = np.array([[1,2],[3,4]])
B = np.array([[5,6],[7,8]])
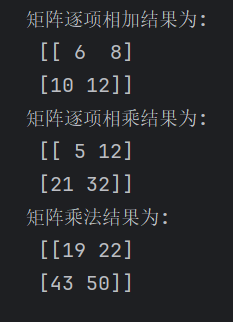
print("矩阵逐项相加结果为:\n",A + B)
print("矩阵逐项相乘结果为:\n",A * B)
print("矩阵乘法结果为:\n",A @ B)
输出结果如下:
题目四:随机数据生成
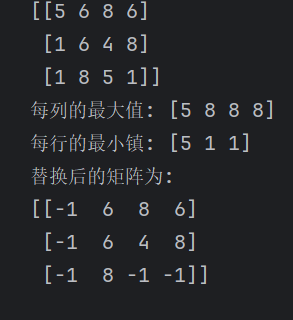
生成一个(3,4)的随机整数数组,范围[0,10) - 计算每列的最大值和每行的最小值 - 将数组中的所有奇数替换为 -1
解题代码如下:
np.random.seed(9)
arr = np.random.randint(0,10,(3,4)) #左开右闭
print(arr)
print('每列的最大值:',np.max(arr,axis=0)) #axis = 0代表列,axis = 1代表行
print('每行的最小镇:',np.min(arr,axis=1))
print('替换后的矩阵为:')
print(np.where(arr % 2 == 0,arr,-1))
输出结果如下:
题目五:数组变形
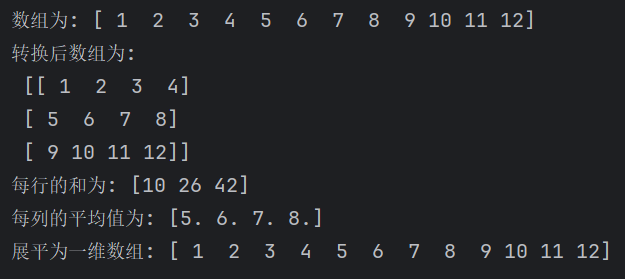
创建一个 1 到 12 的一维数组,并转换为(3,4)的二维数组。 - 计算每行的和与每列的平均值 - 将数组展平为一维数组
解题代码如下:
arr = np.arange(1,13)
print('数组为:',arr)
arr = np.reshape(arr,(3,4))
print('转换后数组为:\n',arr)
print('每行的和为:',np.sum(arr,axis=1))
print('每列的平均值为:',np.mean(arr,axis=0))
print('展平为一维数组:',np.reshape(arr,(12)))
输出结果如下:
题目六:布尔索引
生成一个 (5,5) 的随机数组,范围 [0,20) - 找出数组中大于 10 的元素 - 将所有大于 10 的元素替换为 0
解题代码如下:
np.random.seed(0)
arr = np.random.randint(5,20,(5,5))
print("生成的随机数组为:",arr)
print("所有大于10的元素为:",arr[arr>10])
arr[arr > 10] = 0
print("替换后的结果为:\n",arr)
print("替换后结果为:\n",np.where(arr>10,0,arr))
输出结果如下:

题目七:统计函数应用
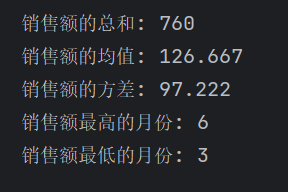
某公司 6 个月的销售额(万元) 为 [120,135,110,125,130,140]
- 计算销售额的总和、均值和方差
- 找出销售额最高的的月份和最低的月份
解题代码如下:
arr = np.array([120,135,110,125,130,140])
print("销售额的总和:",np.sum(arr))
print("销售额的均值:",'%.3f'%np.mean(arr))
print("销售额的方差:",'%.3f'%np.var(arr))
print("销售额最高的月份:",np.argmax(arr) + 1)
print("销售额最低的月份:",np.argmin(arr) + 1)
输出结果如下:
题目八:数组拼接
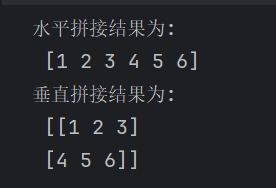
给定A = [1,2,3] 和B = [4,5,6] - 将 A 和 B 水平拼接为一个新数组 - 将 A 和 B 垂直拼接为一个新数组
解题代码如下:
A = np.array([1,2,3])
B = np.array([4,5,6])
print("水平拼接结果为:\n",np.concatenate((A,B)))
print("垂直拼接结果为:\n",np.reshape(np.concatenate([A,B]),(2,3)))
输出结果如下:
题目九:唯一值与排序
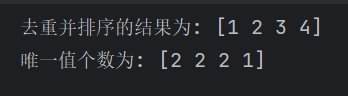
给定数组[2,1,2,3,1,4,3] - 找出数组中的唯一值并排序 - 计算每个唯一值出现的次数
解题代码如下:
arr = np.array([2,1,2,3,1,4,3])
u_arr,counts = np.unique(arr,return_counts=True)
print("去重并排序的结果为:",u_arr)
print("唯一值个数为:",counts)
输出结果如下:
题目十:缺失值处理
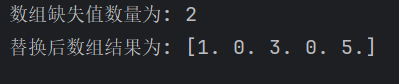
给定数组[1,np.nan,3,np.nan,5] - 计算数组中缺失值的数量 - 将缺失值替换为0
解题代码如下:
arr = np.array([1,np.nan,3,np.nan,5])
print("数组缺失值数量为:",np.size(arr[np.isnan(arr)]))
print('替换后数组结果为:',np.where(np.isnan(arr),0,arr))
输出结果如下:
题目十一:三角函数计算
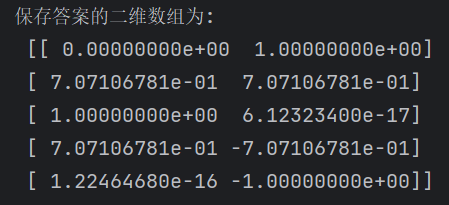
生成一个包含 0 到 Π 的等间隔数组(包含五个数) - 计算数组中每个数的正弦值和余弦值 - 将结果保存为一个二位数组,第一列为正弦值,第二列为余弦值
解题代码如下:
import math
arr = np.linspace(0,math.pi,5)
s_arr = np.sin(arr)
c_arr = np.cos(arr)
print('保存答案的二维数组为:\n',np.column_stack((s_arr,c_arr)))
输出结果如下:
总结
Numpy是一个极其强大的库,合理运用上文中的方法,可以极大提高数据运算与统计的效率。