- 论文全称:Know-Evolve: Deep Temporal Reasoning for Dynamic Knowledge Graphs
- 论文作者:Rakshit Trivedi、Hanjun Dai、Yichen Wang、Le Song(均来自佐治亚理工学院)
- 发表信息:2017 年第 34 届国际机器学习顶会 ICML 2017(Proceedings of the 34th International Conference on Machine Learning),收录于 PMLR 第 70 卷,页码 3462–3471
- 领域定位:时序动态知识图谱(Temporal Knowledge Graph, TKG)链接预测领域的经典开创性工作
- 代码仓库:仓库链接
论文背景
传统的知识图谱是静态、固定的,在做预测任务中忽略了时间对其的影响。如果两国之间在之前是交好的,但由于种种原因使得其现在处于非友好状态,静态的知识图谱无法很好的捕捉到这类随着时间的变化,故引入时序知识图谱(Temporal Knowledge graph)。
传统的知识图谱由(实体1,关系,实体2)这样的三元组构成,而时序知识图谱由(实体1,关系,实体2,关系发生的时间)这样的四元组构成。时序知识图谱的每一条边上都有一个与该事件关联的时间信息,如下图所示:
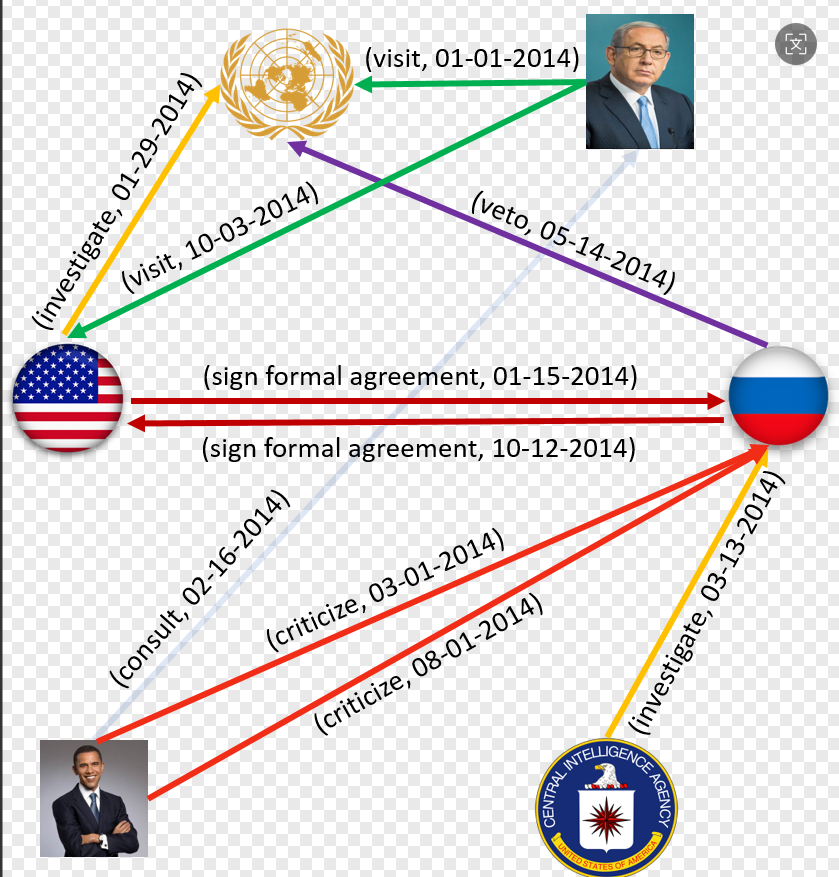
对于传统的预测模型,如TransE、TransR、ER-NLP等等,在训练完成后,模型的参数和知识图谱中对应的实体嵌入将不再更改,这同样会忽略时间带来的影响,这有违真实世界的规律。基于此,提出一种新的模型Know-Evolve用于补全时序知识图谱。
论文主要有如下几个贡献:
- 该工作提出了事件驱动的连续时间动态实体嵌入更新机制,当有新事件发生时,事件中的主客体嵌入将被更新。
- 该架构可以同时预测缺失的事件以及事件发生的时间,这在之前的所有模型中都是做不到的。
- 由于实体的动态嵌入,该模型能够预测真实世界中将要发生的事情。
- 大规模的实验证明,该模型的性能远超不依赖于时序信息的静态模型。
论文方法
知识网络演化
实体的动态嵌入由以下三个组件完成:
- 采用时序点过程这一强大的数学工具对发生的事件建模
- 一种捕捉并调节实体间多关系交互的双线关系得分器
- 一种基于实体随着时间在多关系空间之中的交互而来的新型深度循环网络
时序点过程
时序点过程的原生定义,就是专门用来建模连续时间轴上离散事件发生规律的数学模型,它的核心输出就是「事件在未来某个时间点发生的条件强度」,天然就能推导并预测事件最可能发生的时间点 / 时间区间。
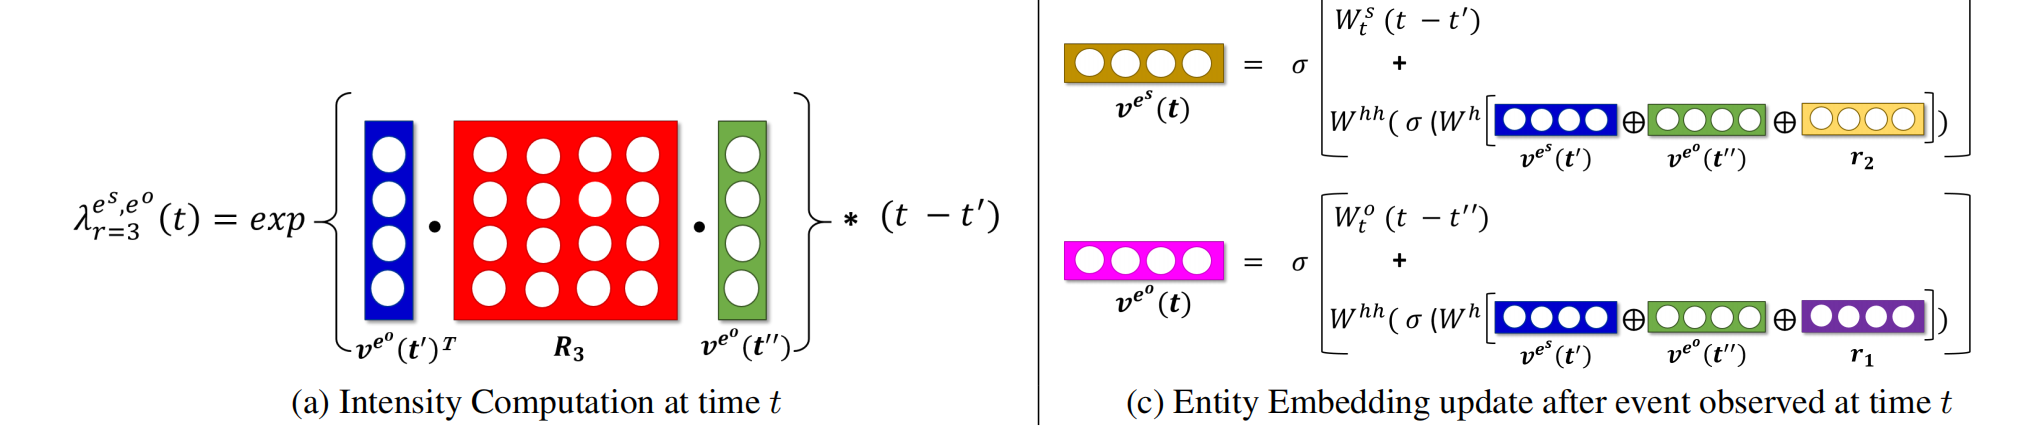
在该篇论文中,时序点过程的建模专门针对除发生时间不同以外,其余(主体、客体、关系)均相同的事件。比如对于下列四元组:(张三,合作,李四,2022年6月)、(张三,合作,李四,2023年7月)、(张三,合作,李四,2024年8月),它们会被当作本篇论文当中时序点过程的输入,专门针对(张三,合作,李四)这个事件。时序点过程的条件强度函数如下: \[ \lambda^{e^s,e^o}_{r}(t|\overline{t})=f(g^{e^s,e^o}_{r}(\overline{t}))*(t-\overline{t}) \] 其中\(e^s,e^o,r\)分别代表一个三元组中的主体实体,客体实体和关系 。\(t\)代表要预测的事件,\(\overline{t}\)代表当前三元组中的两个实体,最近一次参加事件的时间。\(g^{e^s,e^o}_{r}(\overline{t})\)是第二个组件中的双线关系得分器,具体的公式在之后给出。\(f(.)\)是指数函数,具体表达式为\(exp(.)\)。
对公式的理解:\(\lambda\)代表的是时序点过程,它输出的是某个事件在未来某个时间点发生的条件强度。乘积的第一项是两个实体之间的匹配程度,分别由实体的嵌入,两个实体之间关系的嵌入得到。其中,实体的嵌入随着时间变化,故该项得到的是实体在当下的匹配程度,\(f(.)\)确保其不为负。第二项指的是当前时间到实体上一次参与事件的时间差大小。综合来看,如果两个实体在当下的匹配度越高,且两个实体越久没有参与过事件,则认为该事件在\(t\)发生的可能性越高。
生存分析理论
生存分析是对事件发生的规律进行研究的一套理论,通过风险函数(Hazard Function)和生存函数(Survival Function)刻画事件发生的瞬时风险和生存概率随时间的动态变化。生存分析理论主要有以下四个公式: \[ S(t) = P(T>t) \] \(S(t)\)是生存函数,指的是到\(t\)时刻为止,事件还没有发生的概率,这随着时间的增大而减小。具体可以理解为,如果一个事件刚刚发生,那么它在接下来一段时间内将不太可能发生,对应的\(S(t)\)值大。随着时间的增大,该事件越来越有可能发生,故对应\(S(t)\)减小。 \[ f(t)=-\frac{dS(t)}{dt} \] 该公式是事件在t时刻刚好发生的瞬时概率密度,也是用来预测的关键公式。 \[ h(t)=\frac{f(t)}{S(t)} \] \(h(t)\)是风险函数,核心定义为,事件在之前一直没发生的前提下,在此刻发生的瞬时风险\强度。这和时序点过程的强度函数一致,故在本文中\(h(t)=\lambda^{e^s,e^o}_r(t|\overline t)\)。 \[ \land(t)=\int_0^th(\tau)d\tau \] \(\land(t)\)是累积风险函数,用来计算在一段时间内事件的累积发生风险。生存函数\(S(t)=exp(-\land(t))\),累积风险越大,\(\land(t)\)越大,计算得到的\(S(t)\)越小,事件不发生的可能性也越小。对于这篇论文,累积风险函数的积分下界为某事件上一次发生的时间\(\overline t\),具体的积分形式如下: \[ \land(t)=\int_{\overline t}^t\lambda(\tau)d\tau \] 由该小节式3易得,\(f(t)=h(t)·S(t)=\lambda^{e^o,e^s}_r(t)·S^{e^o,e^s}_r(t)\),其中,\(\lambda^{e^o,e^s}_r(t)\)为事件\((e^s,r,e^o)\)在\(t\)时刻发生的瞬时强度,\(S^{e^o,e^s}_r(t)\)为事件(s,r,o)在\(t\)时刻的生存函数。记\(f(t)=d(t),d(t)\)则为论文中对事件在\(t\)时刻发生的瞬时概率密度的定义。
双线关系得分器
双线关系得分器用来计算两个实体在\(t\)时刻的匹配程度,具体公式如下: \[ g^{e^s,e^0}_{r}(t)=v^{e^s}(t-)^T·R_r·v^{e^o}(t-) \] 其中\(R_r\)代表关系的嵌入,关系的嵌入不随时间改变。\(v^{e^s}(t-)\)代表主体实体在\(t\)时刻的最新表示,\(v^{e^o}(t-)\)同理。它可以从历史中影响实体嵌入的时间当中学习到累积知识。
动态演化实体表示
对于一个事件\(m,m\)的定义如下: \[ m=(e^s,r,e^o,t)_m∈D \] \(m\)发生在时间\(t\),假设对于主体实体\(e^s,m\)是其发生的第\(p\)个事件。对于客体实体\(e^o,m\)是其发生的第\(q\)个事件。由于每个实体参与事件的异质性,\(p=q\)的概率较小,但并非没有可能。基于此,实体的嵌入更新定义为下列式子:
主体实体 \[ v^{e^s}(t_p)=\sigma(W^s_t(t_p-t_{p-1})+W^{hh}·h^{e^s}(t_p-)) \]
\[ h^{e^s}(t_p-)=\sigma(W^h·[v^{e^s}(t_{p-1})\oplus v^{e^o}(t_p-)\oplus r^{e^o}_{p-1}]) \]
客体实体 \[ v^{e^o}(t_q)=\sigma(W^o_t(t_q-t_{q-1})+W^{hh}·h^{e^o}(t_q-)) \]
\[ h^{e^o}(t_q-)=\sigma(W^h·[v^{e^o}(t_{q-1})\oplus v^{e^s}(t_q-)\oplus r^{e^o}_{q-1}]) \]
实体嵌入的更新是由事件驱动的,只有当新事件发生,参与事件的实体嵌入才会被更新。以主体实体为例,假设\(m\)是其参与的第\(p\)个事件,\(t_p\)代表该事件发生的事件。对于第一项\(v^{e^s}(t_p)\),\(t_p-t_{p-1}\)代表两次事件发生的时间差,用一个\(d×1\)维的学习数组\(W^s_t\)将其转换成一个向量。其中,\(d\)是实体嵌入的维度。对于第二项\(h^{e^s}(t_p-)\),\(v^{e^s}(t_{p-1})\)代表主体实体上一次参与事件后更新得到的实体嵌入,\(v^{e^o}(t_q-)\)代表客体实体在参与当前事件前最新的实体表示,\(r^{e^s}_{p-1}\)代表主体实体上一次事件中关系的表示。将三个嵌入拼接,乘上\(l×(2d+c)\)维度的共享待学习投影矩阵\(W^h\),该矩阵用于评估实体在其先前关系中的兼容性,经过激活函数\(\sigma(·)\)后得到该项。将其带回第一项,乘上\(d×l\)维度的共享矩阵\(W^{hh}\),经过激活函数\(\sigma(·)\)后得到实体的最新表示。
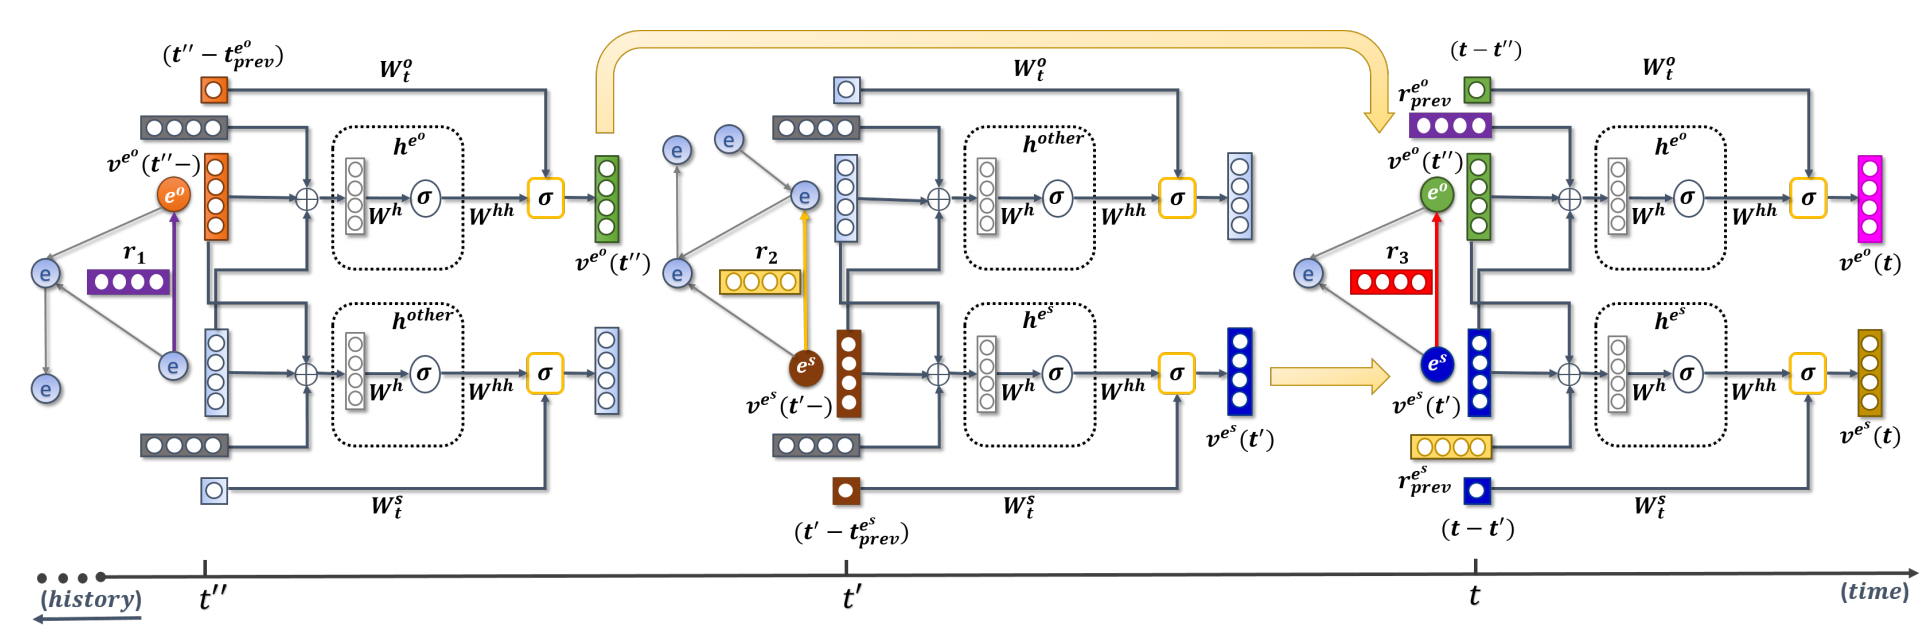
上图为实体嵌入更新示意图,时间戳上的\(t\)为当前时刻,事件(\(e^s,r_3,e^o,t\))发生时,模型会在时间戳上找到两个实体最新的表示以及当前实体参与的上一个事件的关系表示,并按照上述公式更新。\(t\)时刻事件发生的强度以及实体更新可视化公式如下图所示:
训练模型
给定从(0,T]的时序窗口以及在这个时序窗口内发生的所有事件,定义损失函数如下: \[ L = -\sum^N_{p=1}log(\lambda^{e^s,e^o}_r(t_p|\overline t_p))+\sum_{r=1}^{n_r}\sum_{e^s=1}^{n_e}\sum_{e^o=1}^{n_e}\int_0^{T}\lambda^{e^s,e^o}_r(\tau|\overline\tau)d\tau \] 模型优化的目标是使得损失函数尽可能的小。对于第一项,所有在时间戳上已发生的真实事件将会被计算,并给出一个较大的\(\lambda\)值,经过对数、求和、取负的操作后,它将对损失函数起到一个减小的作用。对于第二项,它会遍历所有可能的实体 - 关系组合,对每一个组合,计算其在两次事件之间没有发生的空白时间段内的强度积分,并将所有积分累加作为惩罚项。
对于第二项,由于在没有事件发生的期间,实体的嵌入均不变,故可以将第二项简化为如下形式: \[ \int_{T_0}^T\lambda^{e^s,e^o}_r(\tau|\overline\tau)d\tau =\sum_{p=1}^{P_{(e^s,e^o)}-1}\int_{t_p}^{t_{p+1}}\lambda^{e^s,e^o}_r(\tau|\overline\tau)d\tau \]
\[ =\sum_{p=1}^{P_{(e^s,e^o)}-1}(t_{p+1}^2-t_p^2)·exp(V^{e^s}(t_p)^T·R_r·v^{e^o}(t_p)) \]
上述公式为损失函数的最终形式。由于一段时间内所有的事件组合数量过多,故采用小批次的生存损失近似代表全局生存损失,具体的算法如下:
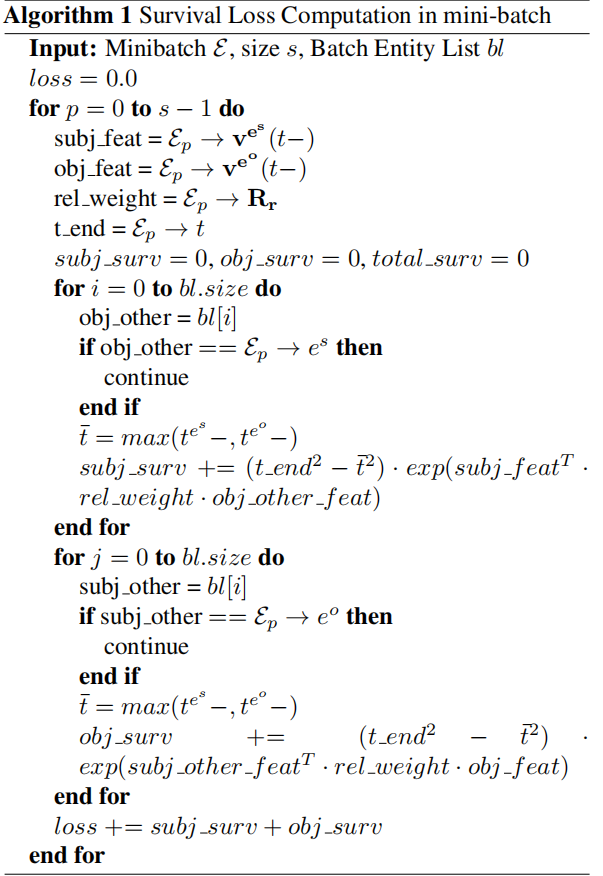
对于该算法的解释如下:
- 输入小分支事件\(\varepsilon\)、事件的规模\(s\)、分支实体列表\(bl\)、总损失\(loss\)
- 开始遍历每个事件,找到每个事件对应的主体实体表示、客体实体表示、关系表示、事件结束的事件并记录
- 遍历每个候选列表实体,首先将每个实体当作客体实体,如果当前客体实体正好是记录的客体实体,则跳过;否则可以判断,当前客体实体与记录的主体实体在该时刻并无此关系,并将该关系的损失加入\(subj\_surv\),遍历完所有实体后结束此次遍历
- 继续遍历每个候选列表实体,将每个实体当作主体实体,如果当前主体实体正好是记录的主体实体,则跳过;否则可以判断,当前主体实体与记录的客体实体在该时刻并无此关系,并将该关系的损失加入\(obj\_surv\),遍历完所有实体后结束此次遍历
- 完成对主体和客体实体的遍历后,记录\(loss=subj\_surv+obj\_surv,loss\)为损失函数第二项的近似损失,完成此次对事件的循环
- 计算总\(loss\),得到小分支的损失,并用其代替总的生存损失
对于以往的时间反向传播算法,时间序列会被拆分成相互独立的序列,并基于这些序列进行小批次传播,但是在本篇论文中,时序数据之间具有关联,故采用设计的BPTT算法进行模型训练,算法伪代码如下:
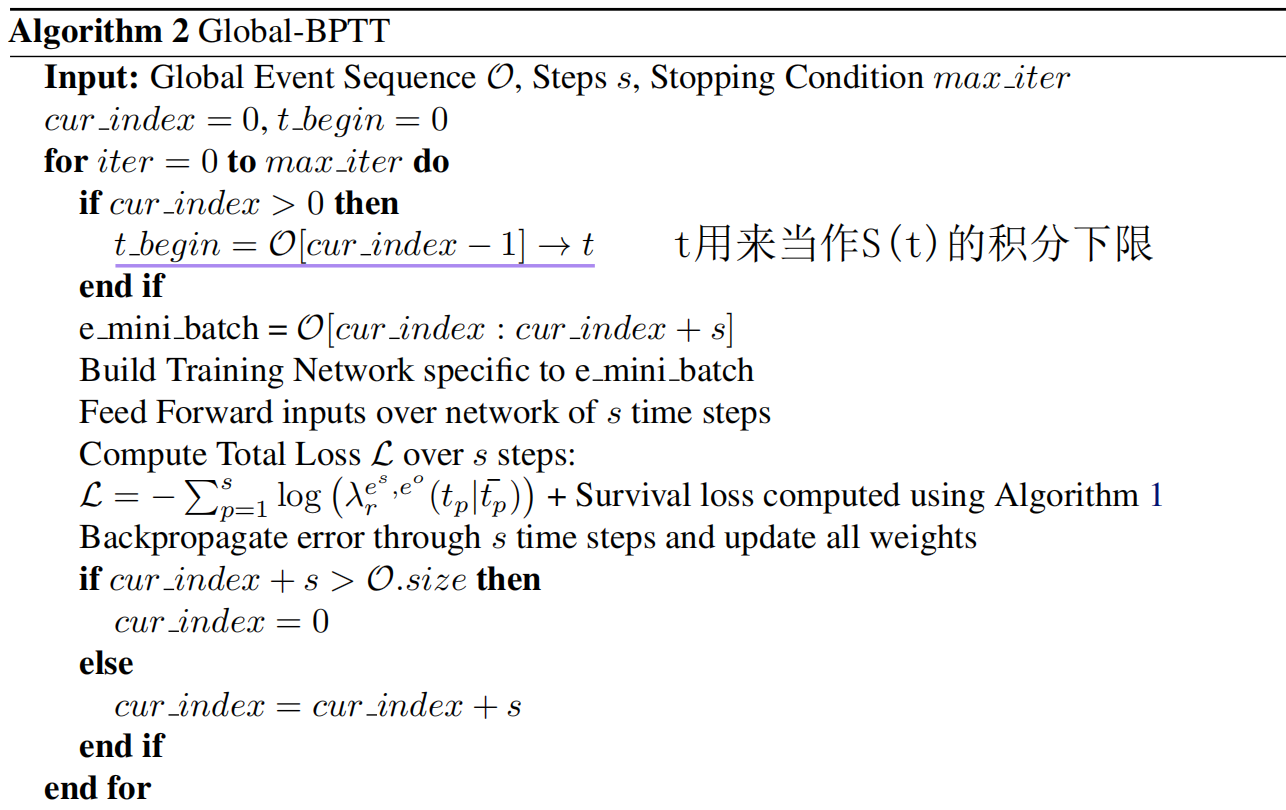
对于该算法的解释如下:
- 输入全局事件序列\(O\),窗口大小\(s\),迭代次数\(max\_iter\),当前事件索引\(cur\_index\),当前事件发生时间\(t\_begin\)
- 进入循环,如果当前事件索引大于0,则记录当前索引的上一个事件对应的事件,当作上一个窗口的末尾时间
- 通过当前窗口的小分支计算损失
- 移动到下一个窗口,如果当前索引加上窗口大小超出了事件序列长度,那么将索引重置为0
- 结束循环
论文实验
首先对数据集进行预处理,去除重复四元组、单主体事件、自环事件。论文在四个数据集上进行实验,分别是Global Database of Events, Language,and Tone (GDELT)和Integrated Crisis Early Warning System (ICEWS) ,以及两个数据集对应的过滤数据集。数据集的统计信息如下图所示:
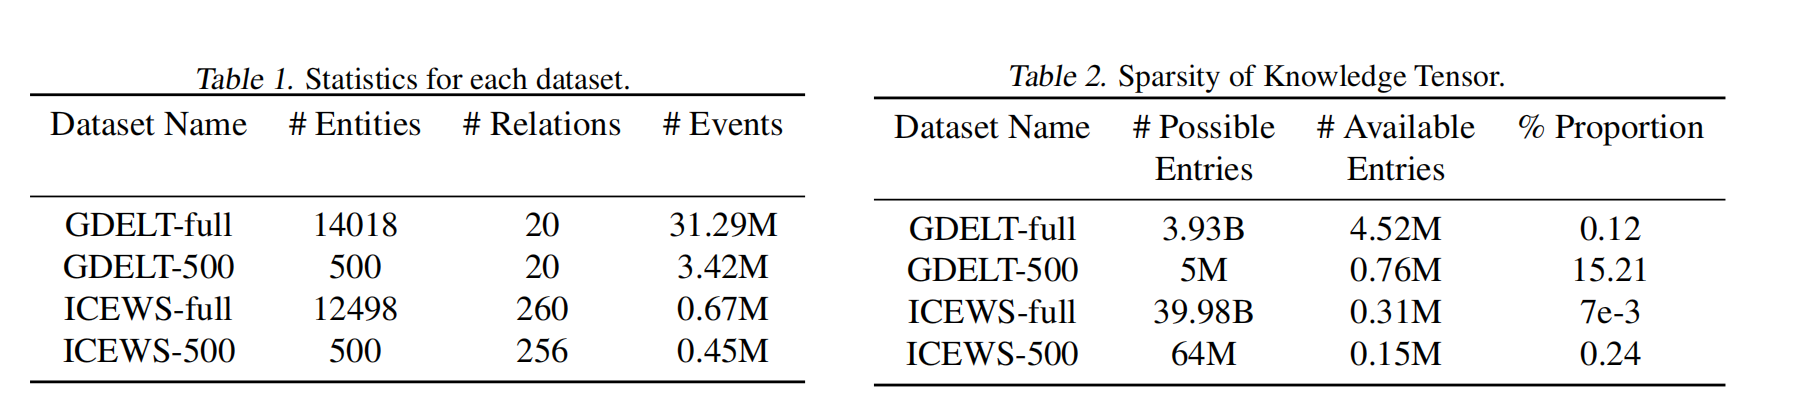
Possible Entries代表所有可能的事件组合,Avaliable Entires代表可能在现实世界中发生的事件组合。
对于链接预测,采用传统知识图谱补全的方法进行实验。由于没有方法能对事实发生的时间预测,故设计如下两种基线方法:
- Multi-dimensional Hawkes process (MHP):收集每一对实体之间参与的事件及其发生时间,形成一个时间轴,在该时间轴上对事实发生的事件学习
- Recurrent Temporal Point Process (RTPP):把三元组的静态实体、关系嵌入拼接,加上当前的时序特征,得到输入向量,作为全局RNN的输入,得到对应的隐状态\(h_t\),用\(h_t\)计算三元组在不通过时间的强度\(\lambda(t)\),找到强度最大的时刻
链路预测
由于研究具有时序性,为了说明模型的能力不会随着时间衰退,故将测试集分成长度为2weeks的窗口进行测试,判断模型在不同时间段的能力。对于一个四元组\((e^s,r,e^o,t)\),将客体实体替换成其它实体,根据事件在\(t\)时刻发生的瞬时概率密度公式\(d(t)=\lambda^{e^o,e^s}_r(t)·S^{e^o,e^s}_r(t)\),将不同四元组的组合得分进行降序排序。同时过滤替换实体后仍然出现在训练集中的三元组,以MAR,STDEV,HITS_10作为评价指标,具体实验结果如下:
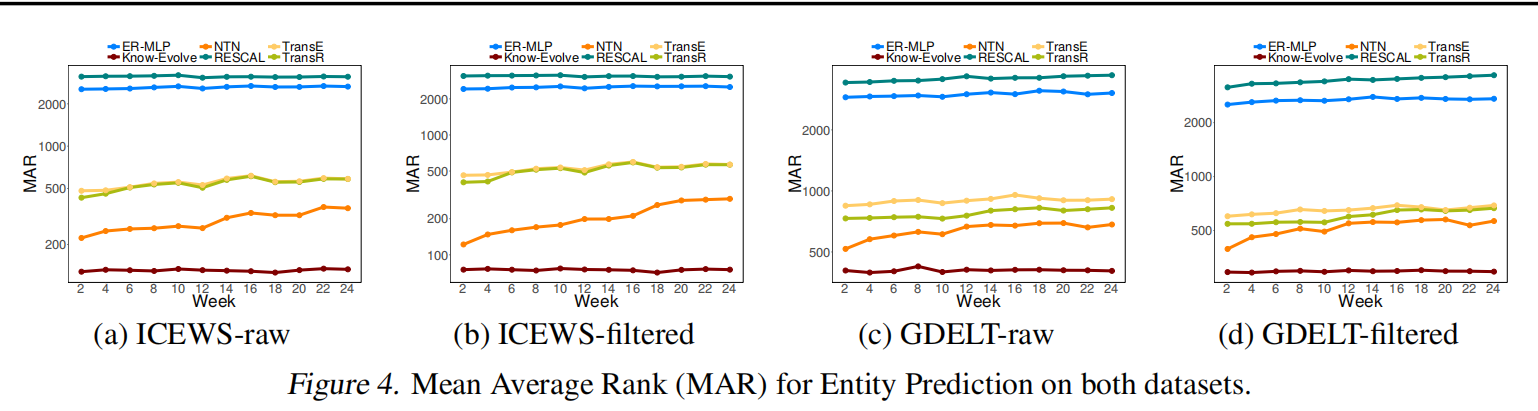
MAR是模型的主要平均排名。由正确四元组在预测序列中的排名得到。正确三元组在预测中的排名越靠前,MAR越低。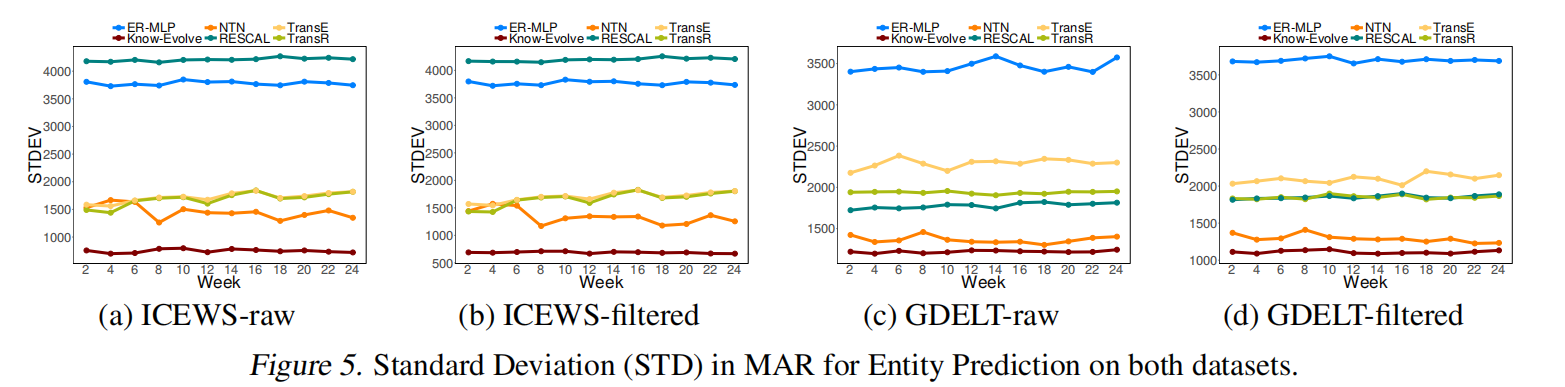
STDEV是模型的标准差,用来判断模型预测能力的稳定程度,其数值越低,说明模型预测的越稳定。
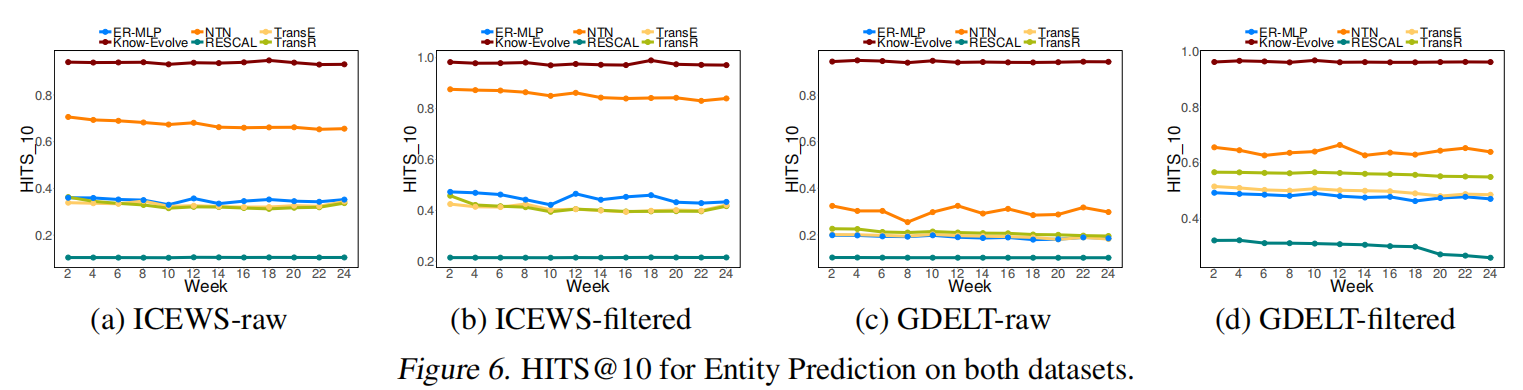
Hits_@10指标由正确四元组在模型给出预测序列中前10的概率得到,数值越高,代表模型越能准确预测四元组。
时间预测
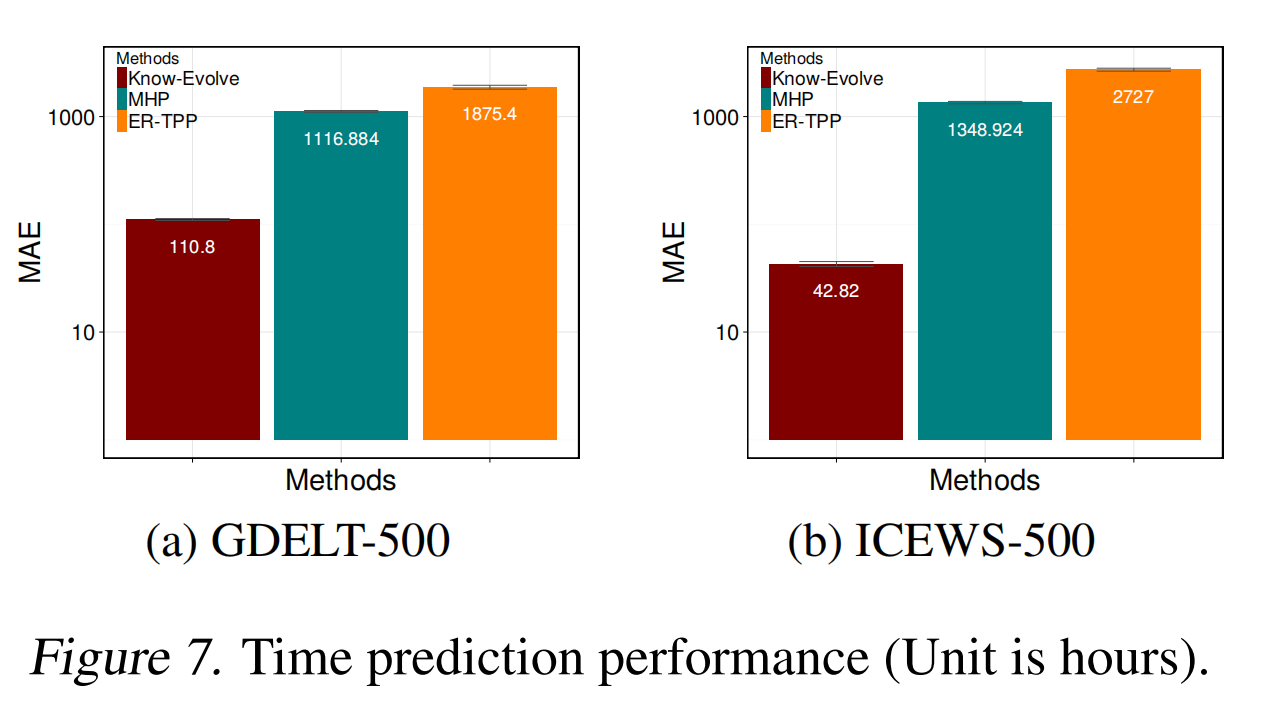
给定一个测试三元组\((e^s,r,e^o)\),根据下列式子预测该事件的下一次发生时间: \[ E_r^{e^s,e^o}(t)=\sqrt{\frac{\pi}{2exp(g^{e^s,e^o}_r(t))}} \] 其中\(g^{e^s,e^0}_{r}(t)=v^{e^s}(t-)^T·R_r·v^{e^o}(t-)\),实验使用Mean Average Error(MAE)作为评价指标。该指标揭露了预测的发生时间和真实发生时间之间的平均误差,实验结果图如下:
滑动窗口实验
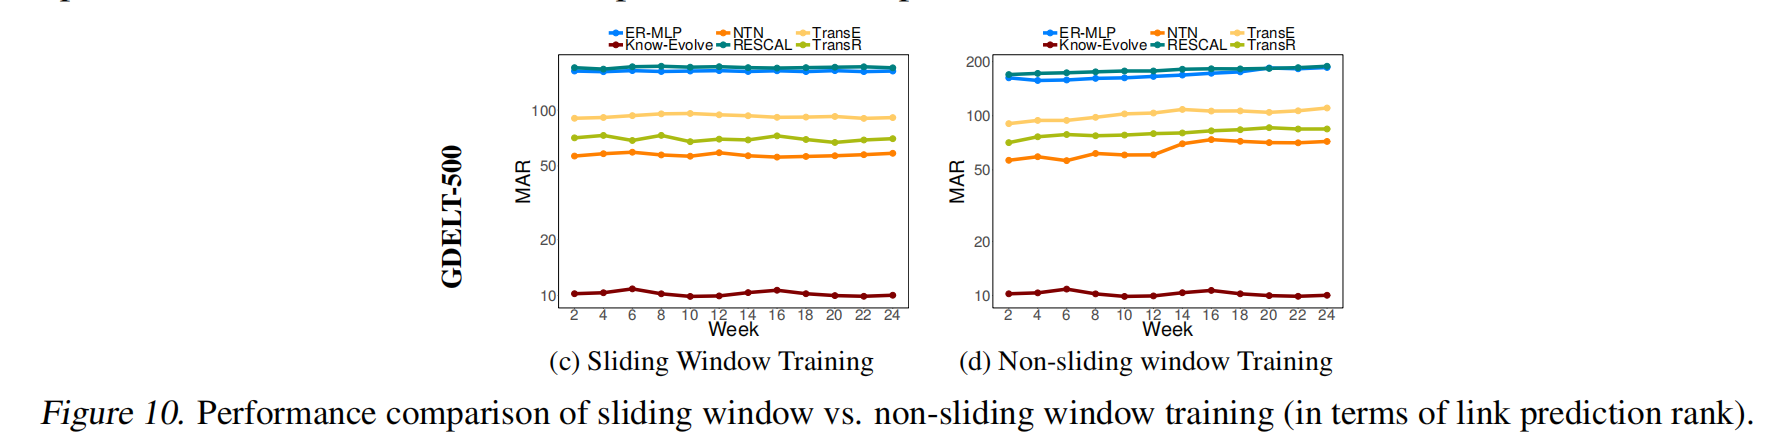
由于本论文提出的模型的实体嵌入随着时间一直在改变,为了保证实验公平,对于传统的基线模型,首先给定其一个包含六个月事件训练集,训练出初始嵌入。由于时间轴被分成了大小为两周的12个切片,在之后的测试里,为了使基线模型的嵌入也能随时间更新,在一个切片结束后,测试集的数据会被加入训练集,同时,训练集会删除最开始两周的数据,用此方法使基线模型的嵌入也能随时间变化,实验结果如图所示:
新旧事实实验
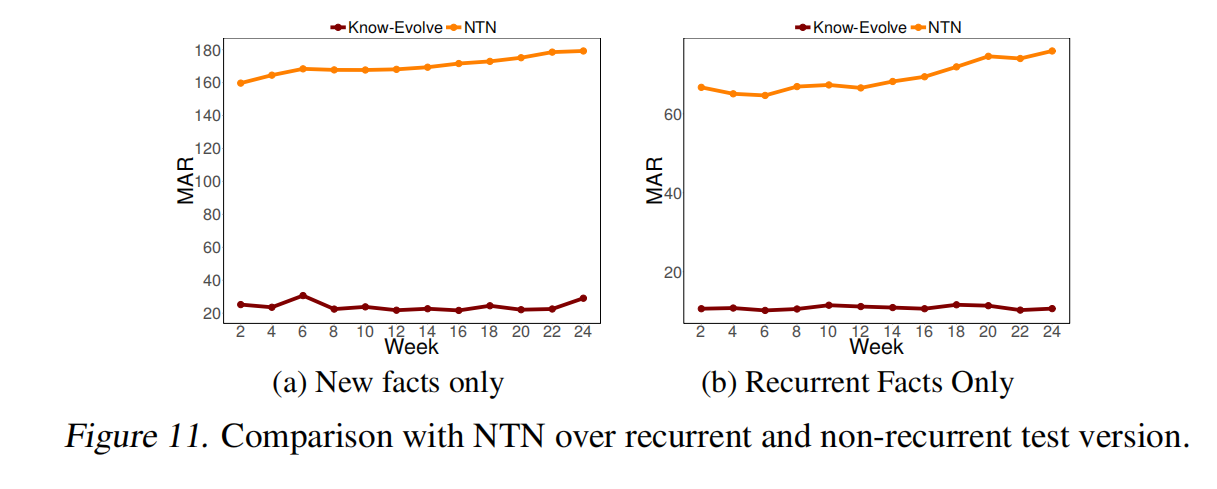
为了判断模型能否正确判断新发生的事实,设置对比实验。
- 组一的测试集仅仅包含训练集中未出现过的事实
- 组二的测试集仅仅包含训练集中出现过的事实
实验结果如下图所示;
论文结论
- 提出了一种新型的知识演化网络,可以在多关系模型中高效的学习实体随时间的演化
- 可以根据事件的发生动态地对实体的嵌入进行更新
- 事件的发生由时序点过程建模,它通过事实掌握时序依赖
- 方法在真实事件的高效表现充分证明了时序分析的重要性
论文总结
作为第一篇时序知识图谱补全方向的论文,收获如下:
- 了解了生存分析理论的强度函数\(h(t)\),生存函数\(S(t)\),事件发生的条件概率密度\(f(t)\),且\(f(t)=h(t)S(t)\)
- 本论文的强度函数为时间点过程的表示函数,它们具有相同的意义,均指在时间\(t\)事件发生的瞬时强度
- 对概率密度的定义及相关含义有了更深刻的认识,概率密度指的是事件在某个点发生的密集程度,越密集,则该点附近的概率密度越高
- 创新点为1)用时序点过程建模时序事件 2)用类似RNN的框架更新实体嵌入 3)提出算法2,该算法利用滑动窗口,降低了训练的时间复杂度 4)设计了 时间间隔驱动的强度函数