Pandas介绍
Pandas和Numpy,Matplotlib(或 Scikit-learn)并称为数据分析中主要的三个核心库。Pandas提供了高效、灵活的数据结构和数据分析工具,广泛用于数据清洗、转换、分析等场景。
Pandas的核心数据结构有两种:
- Series:带标签的一维数组,类似于Python当中的字典,但比字典更强大。Series中的每个元素都由index(索引)和value(值)组成。Series的值可以以各种不同的类型存在,不像ndarray具有同质性。Series的索引可以是任意类型,且可以重复。
- DataFrame:二维表格结构,由多个Series组成,既有行索引也有列索引,是Pandas中最常用的数据结构。
如果用一张Excel表格来类比Series和DataFrame两种数据结构:
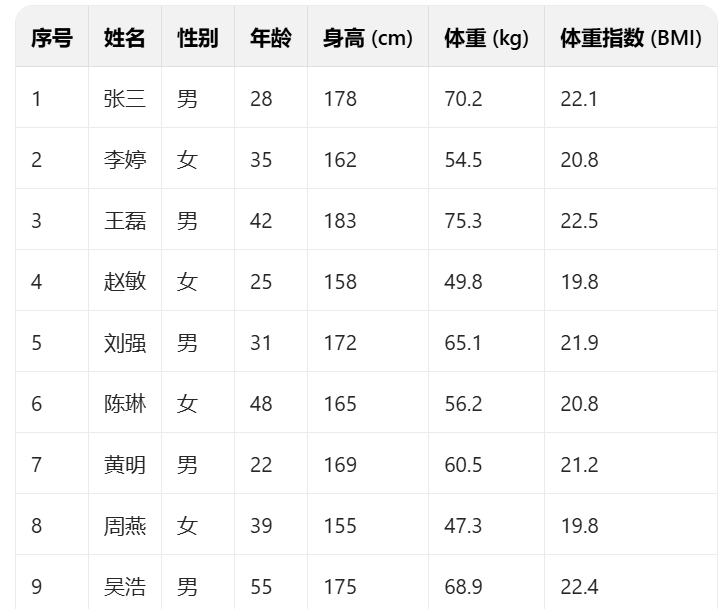
Series就像是其中的每一列数据,如姓名列、性别列、年龄列等。通过索引(在此表中是序号,实际上可以自定义)就可以找到需要的值。而DataFrame则是整张表,要想找到一个具体的元素,既需要知道该元素的行索引,也需要知道该元素的列索引。
Pandas主要功能包括:
- 支持csv、xls、sql等二十多种数据源的数据读取和写出。
- 支持数据清洗,处理重复、缺失的数据,并对数据进行类型转换。
- 支持快速筛选需要的数据,以及快速获得指定位置的数据。
- 支持数据的分组与聚合,方便进行数据的统计与分析。
- 支持数据的合并与连接,可以像数据库一样进行表的连接和合并。
- 提供强大的日期时间处理功能,适合时间序列数据分析。
Pandas的安装
通过python的pip命令安装:
pip install --upgrade pip #先升级pip pip install pandas #安装最新版本的pandas #指定安装版本 pip install pandas==version #version为需要安装的版本号安装Anaconda:
见“数据分析库-Numpy的使用”——>Numpy的安装——>安装Anaconda部分。
Pandas的使用
执行下文中的代码需要先成功安装pandas,并下行python语句导入:
import pandas as pd一、Series的使用
① Series的创建
Series一般通过pandas的Series()方法创建。Series()方法又一般有以下几个参数:
- data:指定Series的数据,可以是list、ndarray、Series、字典等类型。
- index:为数据指定索引,可为空或者任意类型的数据,当为空时数据采用默认索引。
- name:顾名思义,给Series起名,类似于Excel的列名称。
- dtype:指定Series的数据类型。如:当指定dtype为int时,输入Series的数据在符合数据转换规则的前提下,类型都将为int。
- copy:是否要复制data,参数为bool类型。如:当copy=false时,若data为一个ndarray,修改Series的值同时会修改ndarray的值。反之亦然。
以下表当中几个创建Series的方法说明各参数的作用:
| 序号 | 创建方法 | 说明 |
|---|---|---|
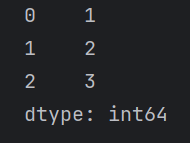
| 1 | s1 = pd.Series([1,2,3]) | 只定义Series的数据,不指定索引 |
| 2 | s2 = pd.Series([1,2,3],index=[‘a’,‘b’,‘c’]) | 定义Series的数据并指定索引 |
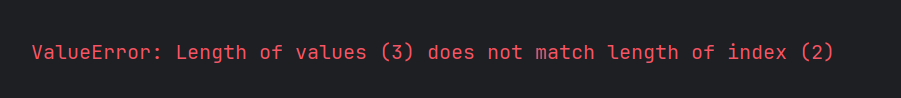
| 3 | s3 = pd.Series([1,2,3],index=[‘a’,‘b’]) | 索引和数据个数不匹配 |
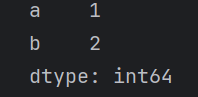
| 4 | s4 = pd.Series(s2,index=[‘a’,‘b’]) | 为已有索引的Series创建索引 |
| 5 | s5 = pd.Series([1,2],index=[‘a’,‘b’],name=‘test’) | 定义Series的数据,指定索引,并设置名字 |
| 6 | s6 = pd.Series(np.array([1,2,3]),copy=False) | 不复制data,直接修改s6 |
| 7 | s7 = pd.Series([‘a’,‘b’,‘c’],dtype=int) | 将输入Series的字符类型数据转换成整型数据 |
Series将以索引列和数据列的方式打印出来。
对于第一种创建方法,由于没有指定索引,故Series中的各数据将有一个类似于数组下标的默认索引。打印s1结果如下图所示:
如果按照方法二给每个数据指定索引,打印s2结果如下图所示:
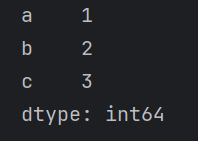
可以看到每个数据和索引一一对应。如果为Series自定义索引,索引个数和数据个数必须一致,否则将会报错。按照第三种方式创建一个Series,结果如下图所示:
如前文所述,Series的data参数可以是Series、字典等本就带有索引的数据结构。如果创建时继续指定索引,那么新的Series将只会包含指定索引对应的数据。按照方法四创建s4,结果如下图所示:
对于创建的合法Series,由于没有为其指定name,故name默认为none。打印结果如下图所示:
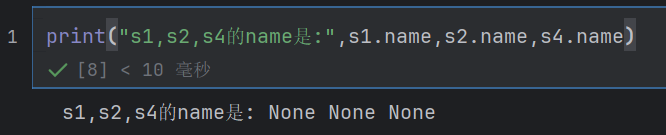
按照方法五,在创建Series时指定参数name为test。打印s5结果如下图所示:
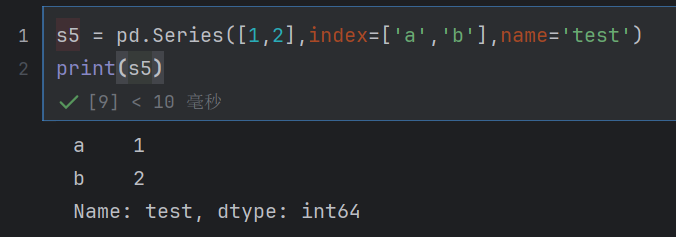
可以看到s5的name属性也被一并打印出来。
若将一个ndarray当作data参数的值,并将copy参数设置为False,创建一个Series并对其进行修改,两个数据结构之间的关系如下图所示:
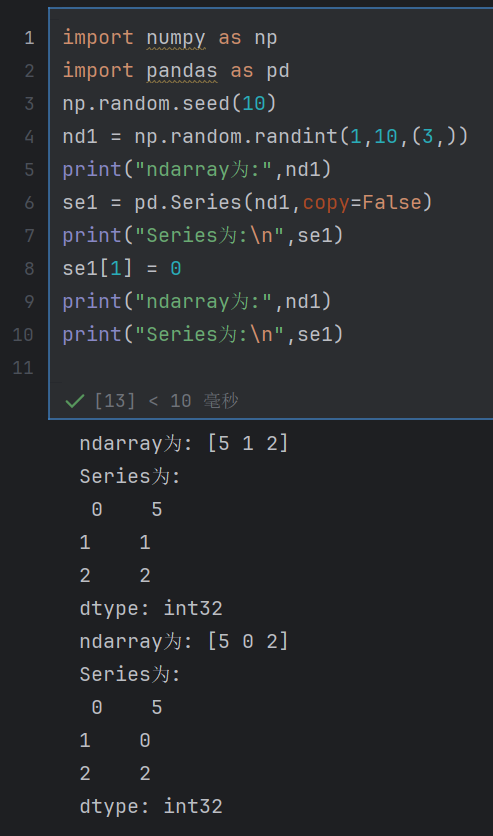
可以看到修改series的同时,ndarray也被修改了。若将copy的值设置为Ture,再对Series修改,结果如下图所示:
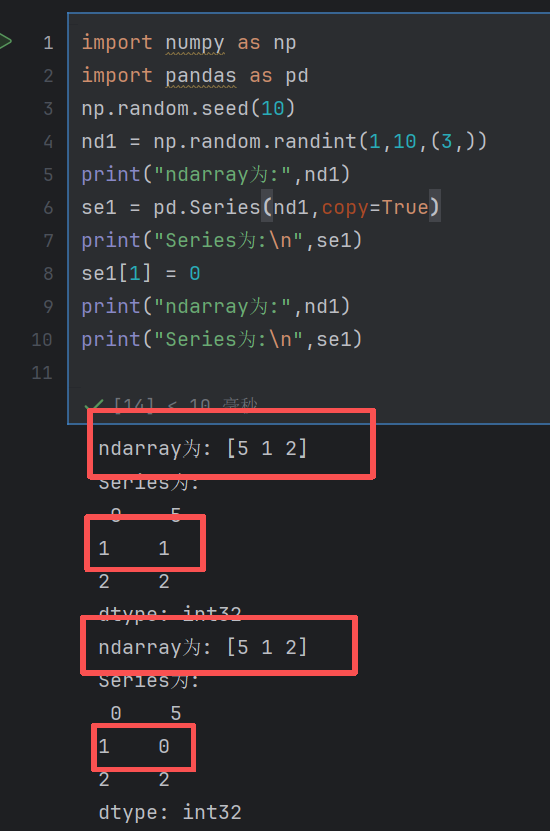
可以看到修改Series并不影响ndarray的值。
若给创建的Series指定类型,且输入的数据可以转换为指定类型的话,那么该Series的数据类型将变成指定的数据类型。按照方法七创建Series,结果如下图所示:
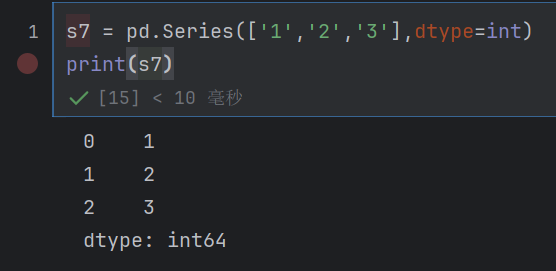
可以看到输入的数据虽然是字符串类型,但最后打印出来该Series的类型为指定的int类型。但如果输入的数据类型不能转换为指定的数据类型(如pandas不支持截断浮点数类型为整型),创建时将会报错。尝试将输入的字符型数据转换为整型数据,结果下图所示:

② Series的属性和访问器
以一个名为se的Series为例,它有下列几个常用的属性:
| 属性名 | 调用方法 | 调用效果 |
|---|---|---|
| 维度 | se.ndim | 输出Series的维度,但Series都是一维的 |
| 形状 | se.shape | 输出Series的形状,为(len(Series), ) |
| 大小 | se.size | 输出Series的元素个数 |
| 索引 | se.index | 输出Series的所有索引 |
| 值 | se.values | 输出Series的所有值 |
| 名称 | se.name | 输出Series的名称 |
以一个名为se的Series为例,它有以下几种访问方式:
| 访问器 | 调用方法 | 调用效果 |
|---|---|---|
| 显式索引 | se.loc[index] | 输出给定索引对应的元素(支持切片) |
| 隐式索引 | se.iloc[index] | 输出隐式索引对应的元素,隐式索引类似于数组的下标,从0开始(支持切片) |
| 显式单元素索引 | se.at[index] | 输出给定索引对应的单个元素 |
| 隐式单元素索引 | se.iat[index] | 输出隐式索引对应的单个元素,隐式索引类似于数组的下标,从0开始 |
对于Series来说,若只是访问单个元素,loc和at,iloc和iat的输出效果是一样的,但是这两对属性存在如下区别:
- loc、iloc:在Series中表示访问的是这个位置对应的元素,但是在DataFrame中若不指定行或列,则访问的是一整行或一整列的元素。loc、iloc支持多个元素的访问,如切片、布尔索引等。
- at、iat:访问的是单个元素,在DataFrame中必须指定行和列,且不支持切片、布尔索引。
在存在大量元素且需要单个访问某元素时,at和iat的效率将远远高于loc和iloc。
下文介绍loc和iloc访问多个元素的方法。
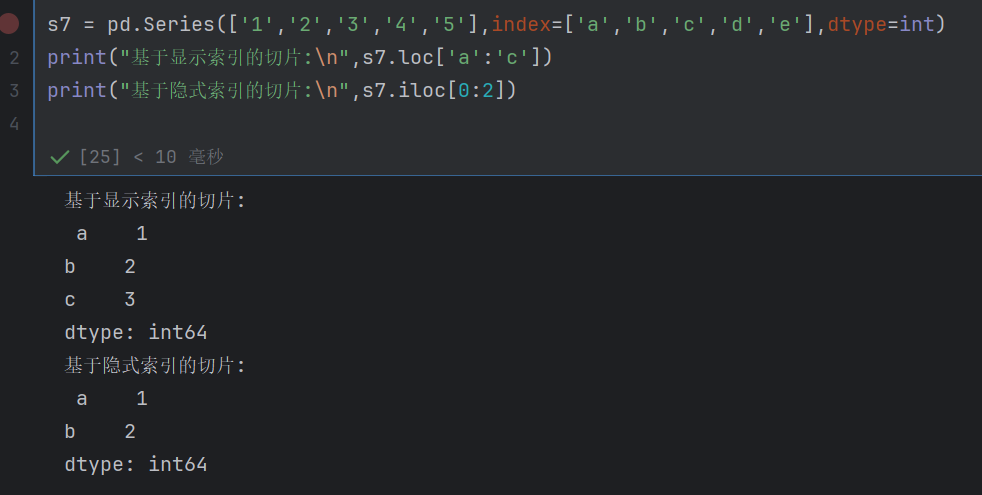
a) loc和iloc的切片
- iloc的切片方式和ndarray以及list一样。iloc[0:4]将会输出隐式下标为[0,4)的四个元素,只包含左端点不包含右端点。
- loc的切片方式为loc[‘a’:‘c’]。将会输出显式索引为[a,c]的元素,包含两个端点。用显示索引的方式切片必须确保切片两端的索引唯一,否则会报错。
两种访问方式的切片结果如下图所示:
b) loc和iloc访问多个元素
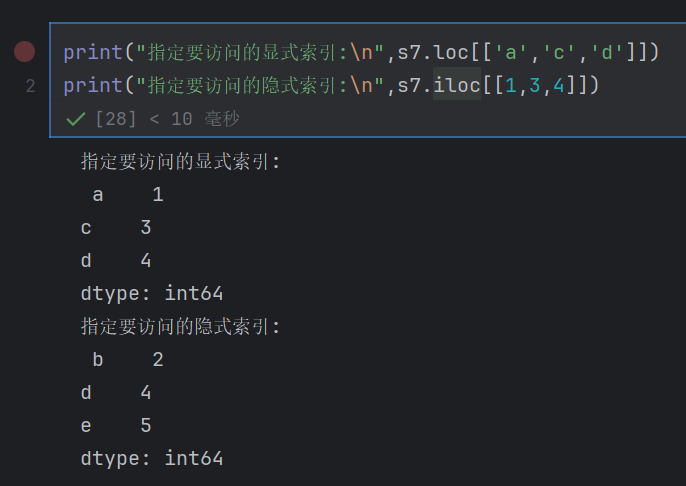
将需要访问元素的**显示索引*定义到一个列表当中,作为loc和iloc的参数。如下图所示:
c) loc +布尔索引访问多个元素
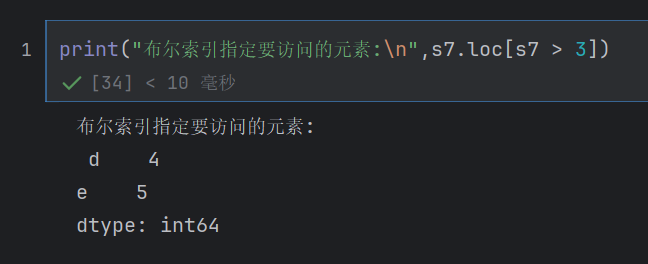
iloc不支持布尔索引,只有loc支持
和Numpy的布尔索引一样,用一个和Series大小、形状相同的布尔数组或者能变成布尔数组的表达式作为参数,最后返回对应位置为True的值。使用布尔索引找到满足条件的值,如下图所示:
③ Series的常用方法
a) 数据查看与统计方法
这类方法可以用来快速了解数据的基本特征。
以下方法的输出示例基于:
s7 = pd.Series([1,2,1,5,5,6,7],index=['a','b','c','d','e','f','g'],name='methods',dtype=int)有下列常用方法:
| 方法名 | 功能说明 | 语法格式 | 示例(基于 s7) |
|---|---|---|---|
head(n) |
返回前n个元素,默认n=5,适合快速预览数据 |
s7.head(n=5) |
s7.head(3) → 输出a:1, b:2, c:1 |
tail(n) |
返回后n个元素,默认n=5,适合查看数据末尾 |
s7.tail(n=5) |
s7.tail(2) → 输出f:6, g:7 |
describe() |
返回数值型数据的核心统计信息(计数、均值、标准差、最值、四分位数) | s7.describe() |
输出:count=7.0, mean=3.857, std=2.390, min=1, 25%=1, 50%=5, 75%=6, max=7 |
var() |
返回数据的方差(离散程度指标),仅对数值型有效;字符型需可转数值(否则报错) | s7.var() |
s7.var() → 约5.714 |
std() |
返回数据的标准差(方差的平方根,更易理解的离散程度指标),仅对数值型有效 | s7.std() |
s7.std() → 约2.390 |
mean() |
返回数据的平均值(集中趋势指标),仅对数值型有效 | s7.mean() |
s7.mean() → 约3.857 |
median() |
返回数据的中位数(抗极端值的集中趋势指标),仅对数值型有效 | s7.median() |
s7.median() → 5 |
quantile(q) |
返回数据的分位数,支持传入列表(如q=[0.25,0.5,0.75])批量计算 |
s7.quantile(q)(0≤q≤1) |
s7.quantile([0.25,0.5,0.75]) → 输出0.25:1, 0.5:5, 0.75:6 |
mode() |
返回数据的众数(出现次数最多的元素),可返回多个(若存在多个众数) | s7.mode() |
s7.mode() → 输出1,5(均出现 2 次) |
sum() |
返回数据的总和,仅对数值型有效 | s7.sum() |
s7.sum() → 27 |
max() |
返回数据的最大值,仅对数值型有效 | s7.max() |
s7.max() → 7 |
min() |
返回数据的最小值,仅对数值型有效 | s7.min() |
s7.min() → 1 |
value_counts() |
统计元素出现次数 / 占比,normalize=True返回占比,ascending=True升序,dropna=False统计NaN |
s7.value_counts (normalize=False, ascending=False, dropna=True) |
s7.value_counts(normalize=True) → 输出1:0.286,5:0.286,2:0.143,6:0.143,7:0.143 |
unique() |
返回不重复的元素(数组形式),无排序(按首次出现顺序) | s7.unique() |
s7.unique() → array([1,2,5,6,7], dtype=int64) |
nunique() |
返回不重复的元素个数(忽略NaN) |
s7.nunique() |
s7.nunique() → 5 |
diff() |
返回每个元素和前一个元素的差 | s7.diff() |
s7.diff() → 输出1:nan,2:1,1:-1,5:4,5:0,6:1,7:1 |
pct_change() |
返回每日收益率(收益率=当前收盘价/前日收盘价 - 1) | s7.pct_change() |
s7.pct_change()→ 输出a:Nan,b:1.000000,c: 0.500000,d:0.333333,e:0.250000 |
idxmax() |
返回值最大的元素对应的第一个索引 | s7.idxmax() |
s7.idxmax()→ 输出‘g’ |
idxmin() |
返回值最小的元素对应的第一个索引 | s7.idxmin() |
s7.idxmin()→ 输出‘a’ |
b) 数据清洗方法
这类方法可以高效地处理数据的缺失值。
以下方法的输出示例基于:
s_miss = pd.Series([1, np.nan, 3, np.nan, 5], index=['a','b','c','d','e']))(1) 缺失值处理方法
有下列常用方法:
| 方法名 | 功能说明 | 语法格式 | 示例(基于 s_miss) |
|---|---|---|---|
isna()/isnull() |
检测缺失值,返回布尔 Series(NaN对应True,非缺失值对应False) |
se.isna() |
s_miss.isna() → 索引b、d对应True,其余为False |
notna()/notnull() |
与isna()相反,非缺失值对应True,缺失值对应False |
se.notna() |
s_miss.notna() → 索引a、c、e对应True,其余为False |
dropna() |
删除包含缺失值的行;inplace=True时直接修改原 Series(不返回新对象) |
se.dropna(inplace=False) |
s_miss.dropna() → 返回删除b、d后的 Series:a:1, c:3, e:5 |
fillna() |
用指定值填充缺失值(value可为常数、均值、中位数等) |
se.fillna(value, inplace=False) |
s_miss.fillna(s_miss.mean()) → 用均值3填充NaN,结果:a:1, b:3, c:3, d:3, e:5 |
(2) 重复值处理方法
以下方法的输出示例基于:
s_dup = pd.Series([1,2,2,3,3,3], index=['a','b','c','d','e','f'])有下列常用方法:
| 方法名 | 功能说明 | 语法格式 | 示例(基于 s_miss) |
|---|---|---|---|
duplicated() |
se.duplicated(keep='first') |
检测重复值,返回布尔 Series:keep='first'(默认):仅标记重复的后续值为True;keep='last':仅标记重复的前序值为True;keep=False:所有重复值均标记为True |
s_dup.duplicated() → 索引c、e、f对应True(仅标记后续重复值)s_dup.duplicated(keep='last') → 索引b、d、e对应True(仅标记前序重复值) |
drop_duplicates() |
se.drop_duplicates(keep='first', inplace=False) |
删除重复值(返回删除重复值后的Series副本,原本的Series不会发生改变),保留规则与duplicated()一致 |
s_dup.drop_duplicates() → 返回去重后的 Series:a:1, b:2, d:3 |
c) 数据转换方法
这类方法可以高效实现各种不同类型的数据转换。
以下方法的输出示例基于:
s7 = pd.Series([1,2,3,4,5], dtype=int)有下列常用方法:
| 方法名 | 语法格式 | 功能说明 | 示例 |
|---|---|---|---|
astype(dtype) |
se.astype(dtype) |
转换 Series 的数据类型(需确保转换合法,否则报错) | s7.astype(float) → 所有元素转为浮点型:1.0,2.0,...5.0 |
apply(func) |
se.apply(func) |
对每个元素应用自定义函数func,灵活性极高 |
若func = lambda x: x*2,则s7.apply(func) → 2,4,6,8,10 |
map(func/dict) |
se.map(func/dict) |
对每个元素映射(类似apply,但更适合简单映射):- 传函数:同apply;- 传字典:按 “键 - 值” 替换元素,未被指定要替换的元素将变成缺失值 |
s7.map({1:'一',2:'二',3:'三',4:'四',5:'五'}) → 元素转为中文数字 |
| 算术方法 | se.add(n)/se.sub(n) se.mul(n)/se.div(n) | 对所有元素进行加减乘除运算(n为常数) |
s7.add(10) → 所有元素加 10:11,12,13,14,15 |
d) 排序与索引方法
这类方法可以高效地对Series按索引或值排序。
以下方法的输出示例基于:
s_sort = pd.Series([3,1,4,2,5], index=['c','a','d','b','e'])有下列常用方法:
| 方法名 | 语法格式 | 功能说明 | 示例 |
|---|---|---|---|
sort_values(ascending=True) |
se.sort_values(ascending=True) |
按元素值排序:ascending=True(默认)升序,ascending=False降序 |
s_sort.sort_values()→ 按值升序:a:1, b:2, c:3, d:4, e:5 |
sort_index(ascending=True) |
se.sort_index(ascending=True) |
按索引排序:规则同sort_values,适合自定义索引的 Series |
s_sort.sort_index() → 按索引字母升序:a:1, b:2, c:3, d:4, e:5 |
reset_index(drop=False) |
se.reset_index(drop=False) |
重置索引为默认整数索引(0,1,2…):drop=False(默认):原索引转为新列;drop=True:原索引直接删除 |
s_sort.reset_index (drop=True) → 索引变为0-4,值为[3,1,4,2,5] |
e) 时间类方法
Pandas支持对时间序列的操作,这类方法可以高效地实现时间方面的需求。
有下列常用方法:
| 方法名 | 语法格式 | 功能说明 |
|---|---|---|
date_range() |
pd.date_range('starttime', periods=, freq=) |
生成一个时间序列,起始时间为Starttime,periods为序列的个数,freq为频率(如按小时,日,月,年生成) |
between_time() |
se.between_time('starttime', 'endtime') |
返回从starttime到endtime之间的数据 |
resample() |
se.resample('Rule').method() |
按照Rule参数给定值将数据重新分组(如将按月份给出的数据重新按季度划分),并统计每一组需要统计的值 |
二、Series案例
首先导入numpy和pandas库:
import numpy as np
import pandas as pd
案例一:成绩统计分析
现有学生成绩数学成绩表如下:
| 姓名 | 成绩 |
|---|---|
| 小明 | 85 |
| 小红 | 92 |
| 小刚 | 78 |
| 小丽 | 92 |
| 小强 | 88 |
| 小芳 | 75 |
| 小美 | 92 |
请以姓名作为索引,成绩作为值,生成一个名为数学成绩的Series并完成以下操作:
快速预览顺序为前 3 名学生的成绩。
查看顺序为最后 2 名学生的成绩。
获取成绩的基本统计信息。
计算成绩的方差和标准差。
统计每个分数出现的次数。
获取不重复的分数以及不重复分数的个数。
按照成绩降序排序
找出大于90分的成绩
具体代码如下:
scores = pd.Series([85,92,78,92,88,75,92],index=['小明','小红','小刚','小丽','小强','小芳','小美'],name='数学成绩')
print("前三名学生成绩为:\n",scores.head(3))
print("最后两名学生的成绩为:\n",scores.tail(2))
print("成绩的基本统计信息为:\n",scores.describe())
print("成绩的标准差和方差为:",scores.std(),scores.var())
print("每个成绩出现的次数:\n",scores.value_counts())
print("不重复的分数:",scores.unique(),"不重复的分数个数:",scores.nunique())
print("降序排序结果为:\n",scores.sort_values(ascending=False))
print("成绩高于90分的有:\n",scores.loc[scores>90])
案例二:温度数据分析
给定某城市一周每天的最高温度:
temperatures = pd.Series([28,31,29,32,30,27,33],index=['周一','周二','周三','周四','周五','周六','周日'])完成以下任务:
- 找出温度超过三十度的天数
- 计算平均温度
- 将温度从高到低排序
- 找出和前一天的温差
具体代码如下:
print("温度超过三十度的天数:",temperatures.loc[temperatures>30].size)
print("平均温度:",temperatures.mean())
print("温度从高到低排序:\n",temperatures.sort_values(ascending=False))
print("和前一天的温差:\n",temperatures.diff())
案例三:股票价格分析
给定某股票连续10个交易日的收盘价Series:
prices = pd.Series([102.3,103.5,105.1,104.8,106.2,107.0,106.0,108.1,109.3,110.2],index=pd.date_range("2025-09-28",periods=10))完成以下任务:
- 计算每日收益率(当前收盘价/前日收盘价 - 1)
- 找出收益率最高和最低的日期
- 计算波动率(收益率的标准差)
具体代码如下:
rate = pd.Series(prices.pct_change(),index=pd.date_range("2025-09-28",periods=10))
print("每日的收益率:\n",rate)
print("收益率最高的日期:",rate.idxmax())
print("收益率最低的日期:",rate.idxmin())
print("波动率:\n",rate.std())
案例四:销售数据分析
给定某产品过去12个月的销售量Series:
sales = pd.Series([120,135,145,160,155,170,180,175,190,200,210,220],index=pd.date_range("2025-09-29",periods=12,freq='M'))完成以下任务:
- 计算季度平均销量(每三个月为一个季度)
- 找出销量最高月份
- 计算月环比增长率
- 找出连续增长超过2个月的月份
具体代码如下:
print(sales.resample('QS').mean()) #重新采样
print("销售量最大的月份:",sales.idxmax())
rates = sales.pct_change()
#先判断各月份是否增长
increase = rates > 0
print("月环比增长率:\n",rates)
print("连续增长超过两个月的月份:\n",increase[increase.rolling(3).sum()==3].index.tolist())
方法补充:
resample()主要用于改变时间序列的频率,例如将高频数据(如按小时记录)转换为低频数据(如按天、周、月汇总),或者反之(升采样)。它本质上是对时间序列进行分组聚合操作。如:此题中将给出的一个年份的数据重新按季度分组成三个数据。
rolling(滚动窗口)用于在滑动的固定大小窗口内计算统计量,窗口会随着时间索引滑动,对每个窗口内的数据应用聚合函数。如:此题要找到连续增长超过两个月的月份,实际上就是找一个大小为3的窗口,看该窗口内元素是否均为True,对应窗口和为1。统计完毕后,每个窗口的结果将会对应在窗口的最后一个元素上。
案例五:每小时销售数据分析
某商店每小时销售额Series:
np.random.seed(42)
hourly_sales = pd.Series(np.random.randint(0,100,24),index=pd.date_range('2025-01-01',periods=24,freq='H'))
完成以下任务:
- 按天重采样计算每日总销售额
- 计算每天营业时间和非营业时间的销售额比例
- 找出销售额最高的三个销售
具体代码如下:
print("按天重采样:",hourly_sales.resample('D').sum())
worktime_sales = hourly_sales.between_time('8:00','22:00').sum()
print("8点到22点的营业额占比:",(hourly_sales.sum() - worktime_sales)/hourly_sales.sum())
print("销售额最高的三个时间段:\n",hourly_sales.sort_values(ascending=False).iloc[0:3].index.tolist())
三、DataFrame的使用
DataFrame类似于一整张Excel表,它既有行索引,又有列索引。要想精确地访问其中的某一个元素,必须知道其行索引和列索引。
下文代码在使用前首先确保导入numpy和pandas库。
import numpy as np
import pandas as pd
① DataFrame的创建
DataFrame的创建创建离不开pandas的DataFrame({key1:data1,key2:data2…},index=,columns=})方法,根据参数类型的不同,可以有如下创建方式。
方法一:通过Series创建
DataFrame是由一列列Series组成的表,故可以直接通过Series创建DataFrame。具体代码如下:
Series1 = pd.Series([1,2,3,4,5])
Series2 = pd.Series([6,7,8,9,10])
df = pd.DataFrame({'第一列':Series1,'第二列':Series2})
打印df结果如下图所示:
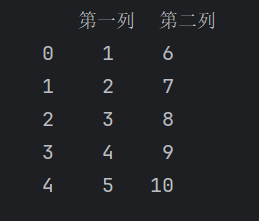
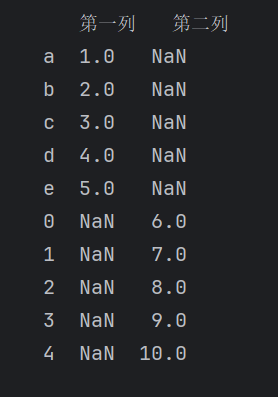
DataFrame会将所有Series索引的并集当作自己的索引。假设有两个size = 5的Series的索引完全不同,那么用它们当作DataFrame的参数时,会出现十个索引,共有十行元素。对于不存在该索引的Series来说,对应位置将会被标记为缺失值,用NaN(缺失值)填充。具体代码如下:
Series1 = pd.Series([1,2,3,4,5],index=['a','b','c','d','e'])
Series2 = pd.Series([6,7,8,9,10])
df_na = pd.DataFrame({'第一列':Series1,'第二列':Series2})
打印df_na结果如下图所示:
方法二:通过自定义的字典创建
可以通过自定义字典创建DataFrame,字典的每一项的key就相当于列名,value相当于该列数据。创建示例代码如下:
df_d = pd.DataFrame({
    '姓名':['jay','JJ','david','khalil'],
    '代表作':['龙卷风','曹操','爱很简单','好不容易'],
    '演唱会':['2004无与伦比','无','2003SoulPower','2011 15']
},index=[1,2,3,4],columns=['演唱会','姓名','代表作'])
打印df_d结果如下图所示:
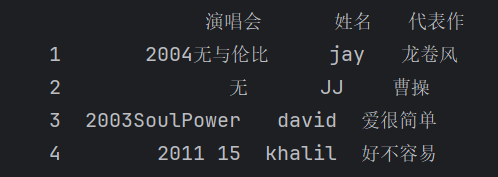
其中columns参数可以自定义列的顺序。如图所示,df_d按照columns的顺序打印出了每一列。
方法三:通过列表创建,且列表内的元素是字典
这种方式将列表内的每个字典当作是DataFrame的一行元素,字典内的每个key相当于是列名。创建示例代码如下:
df_a = pd.DataFrame([
    {'姓名':'jack','性别':'男','年龄':'19'},
    {'姓名':'david','性别':'男','年龄':'56'},
    {'姓名':'khalil','性别':'男','年龄':'41'},
],index=[1,2,3],columns=['性别','年龄','姓名'])
打印df_a结果如下图所示:
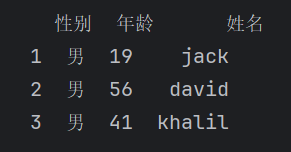
可以看到输入列表中的每一个字典均对应最后元素的一行,输出的结果用columns参数调整了顺序。
对columns参数的补充:
不管在columns中输入什么内容,这些内容在最后都将作为DataFrame的列名输出。
- 如果前面的data中包含这些列名对应的列:那么这些列将按照columns的顺序输出。
- 如果前面的data中不含这些列名对应的列:那么该列的所有值将用NaN填充。
方法四:读入文件创建DataFrame
读取不同格式的文件的方法如下:
# 读取CSV文件(需提前准备文件路径)
df_csv = pd.read_csv('data.csv')

# 读取Excel文件(需安装openpyxl库)
df_excel = pd.read_excel('data.xlsx', sheet_name='Sheet1')

# 读取JSON文件
df_json = pd.read_json('data.json')
② DataFrame的属性
DataFrame有下列常用属性:
| 属性 | 描述 |
|---|---|
shape |
返回元组 (行数, 列数),表示 DataFrame 的维度。 |
size |
返回元素总个数(行数 × 列数)。 |
ndim |
返回维度数(固定为 2,因 DataFrame 是二维结构)。 |
index |
返回行索引(Index 对象),可查看或修改行标签。 |
columns |
返回列索引(Index 对象),可查看或修改列名。 |
values |
以 NumPy 二维数组(ndarray)形式返回数据(不含索引和列名)。 |
dtypes |
返回每列的数据类型(Series 对象,索引为列名)。 |
empty |
返回布尔值,判断 DataFrame 是否为空(无数据行或列)。 |
T |
返回转置后的 DataFrame(行和列互换),等同于 df.transpose()。 |
axes |
返回列表 [index, columns],包含行索引和列索引 |
以df_a为例,逐个测试DataFrame的属性,测试代码如下:
print("DF的形状:",df_a.shape)
print("DF的维度:",df_a.ndim)
print("DF的元素个数:",df_a.size)
print("DF的行索引:",df_a.index.tolist())
print("DF的列索引:",df_a.columns.tolist())
print("DF的值(返回二维ndarray):\n",df_a.values)
print("DF每一列的元素类型:\n",df_a.dtypes)
print("DF的转置:\n",df_a.T)
print("判断DF是否为空:",df_a.empty)
print("返回DF的行索引、列索引列表:\n",df_a.axes)
代码的输出结果如下:
DF的形状: (3, 3)
DF的维度: 2
DF的元素个数: 9
DF的行索引: [1, 2, 3]
DF的列索引: ['性别', '年龄', '姓名']
DF的值(返回二维ndarray):
 [['男' '19' 'jack']
 ['男' '56' 'david']
 ['男' '41' 'khalil']]
DF每一列的元素类型:
 性别    object
年龄    object
姓名    object
dtype: object
DF的转置:
        1      2       3
性别     男      男       男
年龄    19     56      41
姓名  jack  david  khalil
判断DF是否为空: False
返回DF的行索引、列索引列表:
 [Index([1, 2, 3], dtype='int64'), Index(['性别', '年龄', '姓名'], dtype='object')]
矩阵的转置指的是a[i,j]和a[j,i] (i < j)上的元素互换。一个i行j列的矩阵经过转置后会变成j行i列的矩阵
③ 访问DataFrame数据的方法
访问DataFrame一般需要访问其中的某一列、某一行或某个元素,获取数据的方法如下(以df_a为例):
方法一:直接通过列名访问列数据
如果已知列名,访问代码如下:
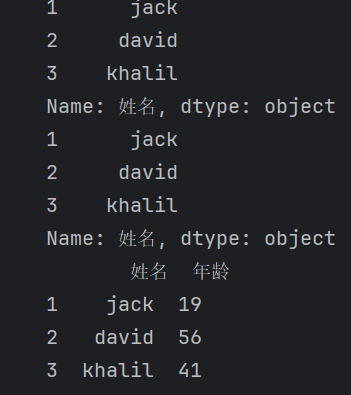
print(df_a['姓名'])
print(df_a.姓名)
print(df_a[['姓名','年龄']])方法一和方法二返回的是列名为“姓名”的Series,只能访问该列数据。方法三返回的是一个DataFrame。将要返回的列的列名加入列表,即可返回需要的列。输出结果如下通过所示:
方法二:使用loc和iloc,at和iat方法
at和iat方法只支持访问单个元素。使用时需要确定要访问元素的行索引和列索引。对于at方法,由于其是显式索引,所以行索引为自定义或默认的索引,列索引为每一列的列名。对于iat方法,由于其是隐式索引,所以行列索引均为要访问元素对应的数组下标。
loc和iloc方法一般用来访问某些行的元素,支持切片。切片方式和Series完全一样。
方法三:随机抽样
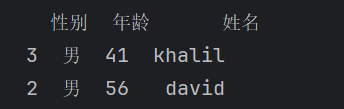
使用sample(n)方法可以随机返回某n行元素。如有以下基于df_a的代码:
print(df_a.sample(2))输入结果如下图所示:
方法四:布尔索引
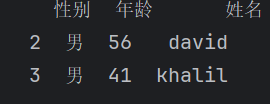
通过对DataFrame某一列或某些列的判断,来找到符合条件的某几条值。中括号内必须要填和DataFrame列规模一致的布尔数组,或是可以转换为布尔数组的布尔表达式。如要找到df_a中年龄大于40且性别为’‘男’’的人的信息,有以下代码:
print(df_a[(df_a.年龄>'40')&(df.性别=='男')])输出结果如下图所示:
④ DataFrame的常用方法
虽然 DataFrame 的许多方法(如 sum()、mean() 等)可以作用于列(类似 Series 方法),但也有一些方法是 DataFrame 专属的,主要用于处理二维结构的特性(如多列交互、行列转换、合并等)。以下是 DataFrame 专属的核心方法:
| 方法 | 功能描述 | 示例 |
|---|---|---|
merge() |
基于共同列或索引合并两个 DataFrame(类似 SQL 的 JOIN 操作) | pd.merge(df1, df2, on='key')(按 key 列内连接) |
concat() |
沿指定轴(行或列)拼接多个 DataFrame 或 Series | pd.concat([df1, df2], axis=0)(纵向拼接,增加行) |
pivot() |
将长格式数据转换为宽格式(重塑数据,基于指定列创建行、列和值) | df.pivot(index='date', columns='category', values='value') |
pivot_table() |
创建透视表(对数据进行分组聚合,支持多重索引) | pd.pivot_table(df, index='A', columns='B', values='C', aggfunc='mean') |
melt() |
将宽格式数据转换为长格式(pivot 的逆操作) |
df.melt(id_vars='id', value_vars=['col1', 'col2']) |
transpose() / T |
行列转置(行变列,列变行) | df.transpose() 或 df.T |
join() |
基于索引合并两个 DataFrame(类似 merge,但更简洁,默认按索引连接) |
df1.join(df2, lsuffix='_left', rsuffix='_right') |
explode() |
将包含列表 / 数组的列拆分为多行(每行对应一个元素) | df.explode('list_column') |
stack() / unstack() |
层级索引转换:stack 将列索引转为行索引(压缩),unstack 反之(展开) |
df.stack()(列→行,数据变窄);df.unstack()(行→列,数据变宽) |
get_dummies() |
将分类变量转换为哑变量(One-Hot 编码) | pd.get_dummies(df, columns=['category']) |
merge_ordered() |
类似 merge,但会对结果按键排序(适用于时间序列等有序数据) |
pd.merge_ordered(df1, df2, on='date') |
compare() |
比较两个 DataFrame 的差异,返回不同值的详细信息 | df1.compare(df2)(显示两表不同的单元格) |
四、DataFrame案例
案例一:学生成绩分析
某班级的学生成绩数据如下:
data = {
    '姓名':['张三','李四','王五','赵六','钱七'],
    '数学':[85,92,78,88,95],
    '英语':[90,88,85,92,80],
    '物理':[75,80,88,85,90]
}
请完成以下任务:
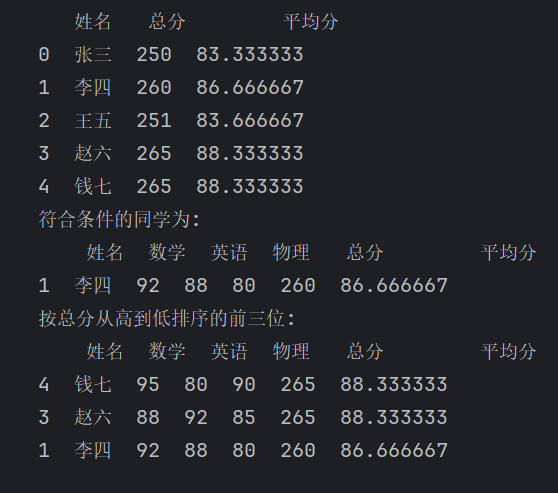
- 计算每位学生的总分和平均分
- 找出数学成绩高于90分且英语成绩高于85分的学生
- 按总分从高到低排序,并输出前三名学生
具体代码如下:
scores = pd.DataFrame(data)
#只需要物理数学英语三列数据
scores_pme = scores[['物理','数学','英语']]
scores['总分'] = scores_pme.sum(axis=1)
scores['平均分'] = scores_pme.mean(axis=1)
print(scores[['姓名','总分','平均分']])
print('符合条件的同学为:\n',scores[(scores.数学>90) & (scores.英语>85)])
print('按总分从高到低排序的前三位:\n',scores.sort_values(by='总分',ascending=False).head(3))实现结果如下:
方法补充:
一些统计类的方法,如sum()、mean()、median()等默认按照列进行统计,若需要按行进行统计,将axis参数设置成1即可。
案例二:销售数据分析
某公司的销售数据如下:
data = {
    '产品名称':['A','B','C','D'],
    '单价':[100,150,200,120],
    '销量':[50,30,20,40]
}
完成以下任务:
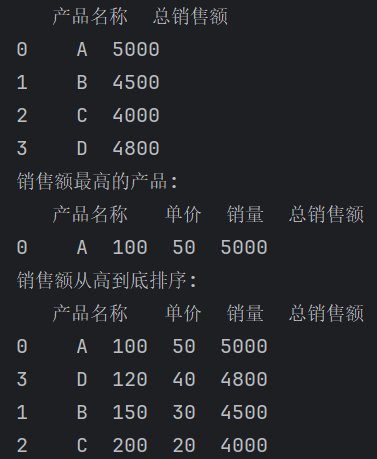
- 计算每种产品的总销售额(销售额 = 单价 * 销量)
- 找出销售额最高的产品
- 按销售额从高到低排序,并输出所有产品信息
具体代码如下:
sells = pd.DataFrame(data)
sells['总销售额'] = sells.单价 * sells.销量
print('总销售额为:\n',sells[['产品名称','总销售额']])
print('销售额最高的产品:\n',sells.nlargest(1,'总销售额'))
print('销售额从高到底排序:\n',sells.sort_values(by='总销售额',ascending=False))实现结果如下:
方法补充:
nlargest(n,columns),返回指定列的最大的n条数据。按照colunms参数中的先后顺序确认优先按照哪一列排序。
nsmallest(n,columns),返回指定列的最小的n条数据。按照colunms参数中的先后顺序确认优先按照哪一列排序。