论文全称:Recurrent Event Network Autoregressive Structure Inference over Temporal Knowledge Graphs
论文作者:Woojeong Jin¹、Meng Qu²³、Xisen Jin¹、Xiang Ren¹
南加州大学(University of Southern California)计算机科学系;² MILA - Quebec AI Institute;³ 蒙特利尔大学(University of Montréal)
发表信息:2020 年自然语言处理顶会 EMNLP 2020(Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing),页码 6669–6683,会议举办时间 2020 年 11 月 16 日 - 20 日
领域定位:时序动态知识图谱(Temporal Knowledge Graph, TKG)外推推理(未来事件预测)领域的经典开创性工作,是首个为 TKG 多步未来预测设计的自回归生成式架构,也是该领域后续研究广泛使用的标杆性基线模型
论文背景
知识图谱(Knowledge Graph,KG)反应了真实世界中实体和之间的关系,在各个领域都发挥着作用。但由于知识图谱本身的性质,其中会存在很多缺失信息,故,知识图谱的补全成为了一个研究问题。但在现实生活中,实体之间的关系会发生变化,故诞生了时序知识图谱(Temporal Knowledge Graph,TKG)。针对时序知识图谱补全的方法目前存在如下几个问题:
- 预测某一时刻的真实事件时,必须知道该时刻上一时刻的真实事件,因此,其不能做连续的预测
- 过去的方法不能处理同一时刻发生的事件,只能假设同一时刻只有一个事件发生
基于上述两点,本文提出了一种能建模并发事件、能无标签连续预测未来的时序图谱模型RE-Net。
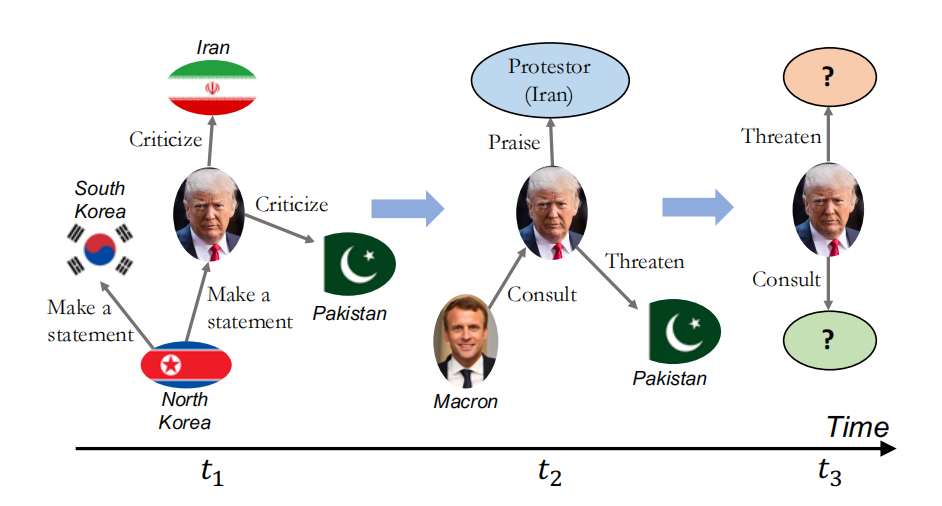
下图为一个时序知识图谱随着事件的变化发生变化的示例图:
论文方法
复发事件编码器总结过去事件序列的信息,邻居聚合器聚合同一个窗口内重复发生事件的信息
四元组表示为\((s,r,o,t)\),或\((s_t,r_t,o_t)\)。一个时序知识图谱基于事件四元组的时间戳升序建模,目标是根据观察到的事件集合\({G_1,…,G_t}\),学习事件的总体分布\(p(G)\)。
方法的核心理念是从序列图中学习时序依赖,从邻居中学习局部结构依赖。
RE-Net定义并发事件的条件概率,其依赖于所有先前的事件。
定义所有事件的联合分布\(G={G_1,…,G_T}\)。推测当前时间步\(G_t\)的概率依赖于前\(m\)个时间步\(G_{t-m,t-1}\),故把联合分布拆分为一序列的条件分布\(p(G_t|G_{t-m:t-1})\)。又推测时间步\(G_t\)中的事件都是相互独立的,故联合分布可以被写为: \[ p(G)=\prod_t\prod_{(s_t,r_t,o_t)\in G_t}p(s_t,r_t,o_t|G_{t-m:t-1}) \]
如果事件之间相互独立,那么各事件的联合概率分布等于各事件的条件概率分布之积。
基于这些概率,按照以下步骤生成三元组:
- 给定所有过去\(m\)个时间步事件\(G_{t-m:t-1}\)
- 首先通过\(p(s_t|G_{t-m:t-1})\)对所有主体实体采样
- 然后依据\(p(r_t|s_t,G_{t-m:t-1})\)生成和主体实体有关的关系\(r_t\)
- 最后凭借\(p(o_t|s_t,r_t,G_{t-m:t-1})\)生成三元组对应的客体
因此,联合分布\(P(G)\)在上式的基础上又可以写作: \[ p(G)=\prod_t\prod_{(s_t,r_t,o_t)\in G_t}p(s_t|G_{t-m:t-1})·p(r_t|s_t,G_{t-m:t-1})·p(o_t|s_t,r_t,G_{t-m:t-1}) \] ### 复发事件编码器(Recurrent Event Encoder)
为了对每个事件参数化表示,RE-Net定义了一系列全局和局部表示。
全局表示\(H_t\)总结了直到时间戳\(t\)的全图全局信息,反应了全局对即将发生的事件的影响。局部表示\(h_t(s),h_t(s,r)\)则更聚焦于和这些实体、关系有联系的实体和关系信息。
编码过程
需要对全局信息\(H_t\),局部信息\(h_t{(s,r)},h_t(s)\)编码,复发事件编码器由三个独立的RNN组成,分别对两个局部信息以及一个全局信息进行编码。具体定义如下: \[ H_t=RNN^1(g(G_t),H_{t-1}) \]
\[ h_t(s,t)=RNN^2(g(N_t^{(s)}),H_t,h_{t-1}(s,r)) \]
\[ h_t(s)=RNN^3(g(N_t^{(s)}),H_t,h_{t-1}(s)) \]
\(N_t^{(s)}\)指的是在事件戳\(t\)时刻和主体实体\(s\)有关的所有事件,\(g(·)\)是邻居聚合器的聚合函数,\(g(G_t)=max(\{g(N_t^{s})\})\)。
解码过程:
RE-Net将\(p(o_t|s_t,r_t,G_{t-m:t-1})\)参数化成: \[ exp([e_s:e_r:h_{t-1}(s,r)]^T·w_{o_t}) \] \(h_{t-1}(s,r)\)是\((s,r)\)在时间戳\(t-1\)时刻获得的局部表示。通过将编码送入多层感知机作为一个线性\(softmax\)分类器,训练参数\(w_{o_t}\),使得模型能够根据已知主体和关系,找到正确的客体。
同理,定义寻找主体和关系的概率如下: \[ p(r_t|s,G_{t-m:t-1}) \propto \exp([e_s:h_{t-1}(s)]^T·w_{r_t}) \]
\[ p(s_t|G_{t-m:t-1}) \propto \exp(H_{t-1}^T·w_{s_t}) \]
通过三个独立的MLP分别训练参数。
邻居聚合器(Neighborhood Aggregators)
①均值池化聚合器
该聚合器仅仅对\(N_t^{(s,r)}\)中的客体元素进行逐元素均值计算。\(N_t^{(s,r)}\)是在\(t\)时刻和主体实体\(s\),关系\(r\),有关系的客体元素\(o\)的集合。该聚合器平等对待所有客体,忽略了每个邻居实体的不同重要性程度。
②注意力池化聚合器
聚合函数定义为\(g(N_t^{(s,r)})=\sum_{o\in N_t^{(s,r)}}\alpha_oe_o\)。其中,\(\alpha_o=softmax(v^Ttanh(W(e_s;e_r;e_o)))\),\(v,W\)是可学习参数。该聚合器可以根据关联程度调整不同邻居实体的权重。
③多关系图聚合器
该聚合器可以合并多关系和多跳实体的信息,聚合器被定义如下: \[ g(N_t^s)=h_s^{(l+1)}=\sigma(\sum_{r\in R}\sum_{o\in N_t^{(s,r)}}\frac{1}{c_s}W_r^{(l)}h_o^{(l)}+W_o^{(l)}h_s^{(l)}) \] 每个节点的初始隐藏表示\((h_o^{(0)})\)被设置成可训练的嵌入向量\((e_o)\)。\(c_s\)是归一化因子。
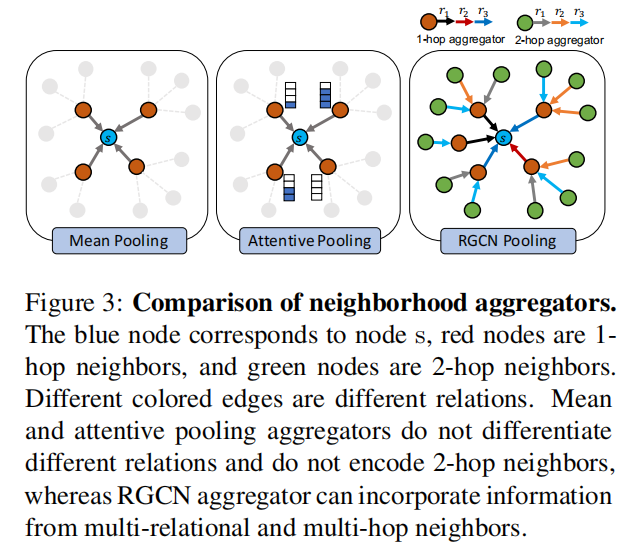
上图为不同聚合器的对比示意图。
下图为RE-Net工作架构示意图,聚合器同时处理局部邻域结构和整体结构,局部信息和全局信息一起送入RNN单元编码,再将编码送入MLP解码,得到预测值: 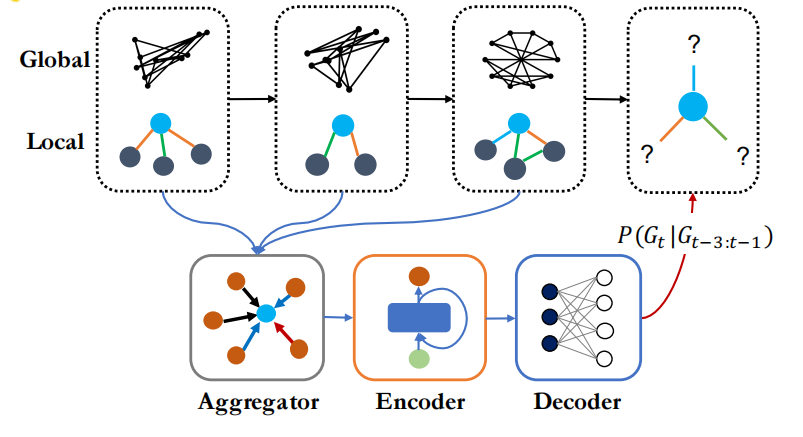
推理过程
元素的推理过程可以看作是一个多类别分类任务,损失函数定义如下: \[ L=-\sum_{(s,r,o,t)\in G}logp(o_t|s_t,r_t)+\lambda_1logp(r_t|s_t)+\lambda_2logp(s_t) \] \(\lambda_1,\lambda_2\)可以根据具体的任务需求调整大小。
模型训练完毕后,假设需要预测在\(t+ \Delta t\)时刻发生的事情,即计算\(p(G_{t+\Delta t}|G_t)\),可以将其看作一个分步推理的过程。具体算法如下:
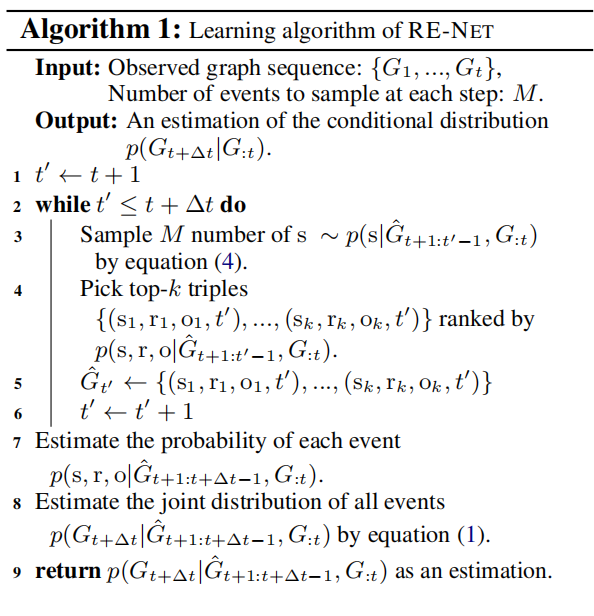
输入过去时间戳的事件序列集合,以及每一步需要采样的实体个数\(M\),输出条件分布\(p(G_{t+\Delta t}|G_t)\)的估计。
从\(t+1\)时刻开始,直到\(t+\Delta t\)进行循环。每次循环有下列步骤:
- 根据\(p(s|\hat G_{t+1:\hat t-1},G_{:t})\),采样\(M\)个最有可能在当前时刻发生的主体实体
- 依据\(p(r|s,\hat G_{t+1:\hat t-1},G_{:t}),p(o|s,r,\hat G_{t+1:\hat t-1},G_{:t})\)选择\(k\)个最有可能在当前时刻发生的事件,作为当前时刻发生的事件集
- 循环,直到\(t+\Delta t\)时刻
\(t+1:t+\Delta t -1\)时刻的事件为算法自回归预测而来
此时已知\(t+\Delta t\)时刻之前的所有已发生事件,可以预测该时刻单个事件发生以及整个图谱发生的概率。
论文实验
共在五个数据集上进行实验,其中三个是基于事件的数据集,两个是带有时间戳的数据集。在生成负三元组时,过滤掉出现在训练集、验证集和测试集的真实三元组。
齐次图指的是图中只有一种关系类型、实体类型的图,如:微信好友关系图
实验对比了静态模型、时序模型、用于齐次图的模型。对于静态模型,将数据集中四元组的时间戳删去,并合并相同三元组,得到一个新的数据集,在此数据集上进行补全。数据集统计图如下所示:
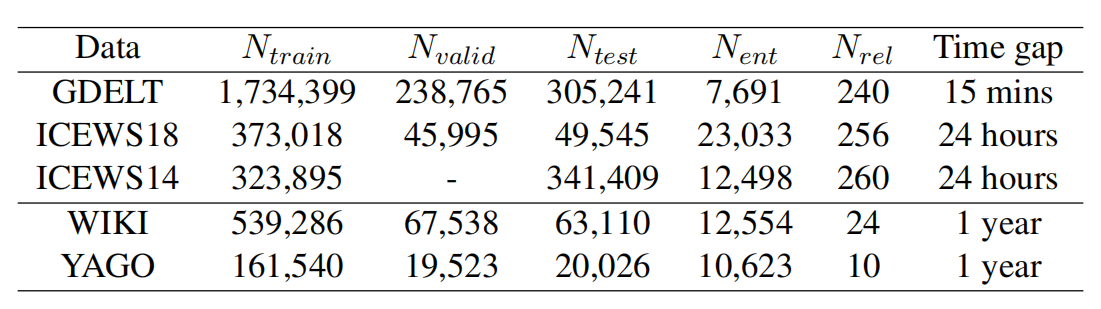
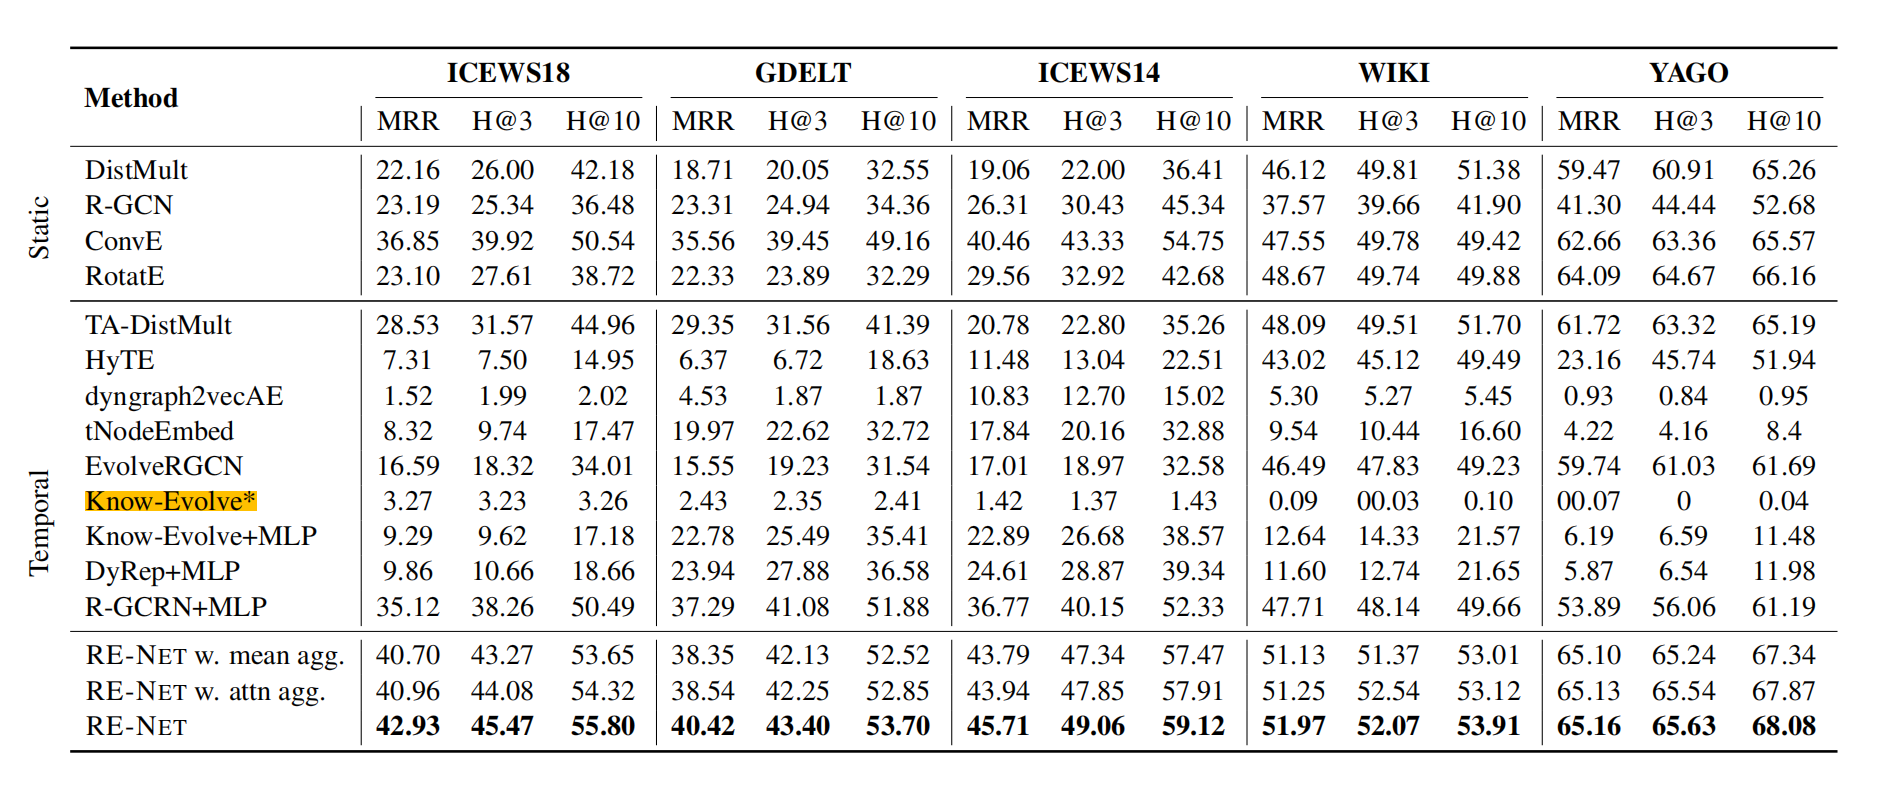
dyngraph2vecAE,tNodeEmbed两个模型用于处理齐次图,故在非齐次图上效果并不显著。Know-Evolve由于自身的模型问题,它无法正确预测并发事件,故表现的很差。总体实验结果图如下所示:
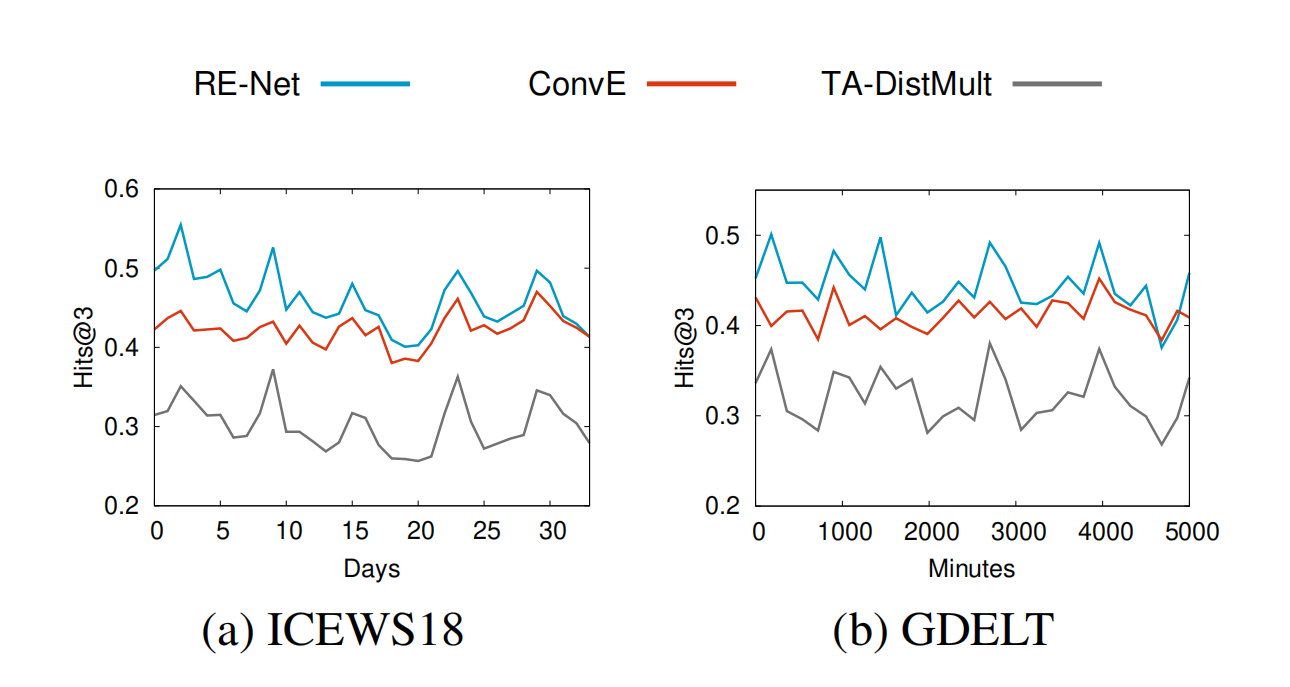
论文还做了在未来时间戳上链路预测的对比实验,随着时间的推移,RE-Net效果将变差,因为时间越久,假设事实就越多。ConvE是静态模型,它不考虑时间戳带来的影响,故其效果相对平稳。具体实验结构如下图所示:
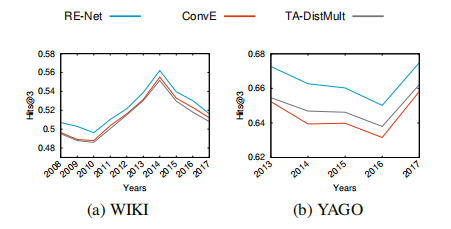
在带有时间戳的两个数据集WIKI和YAGO上的时序链路预测结果如下图所示:
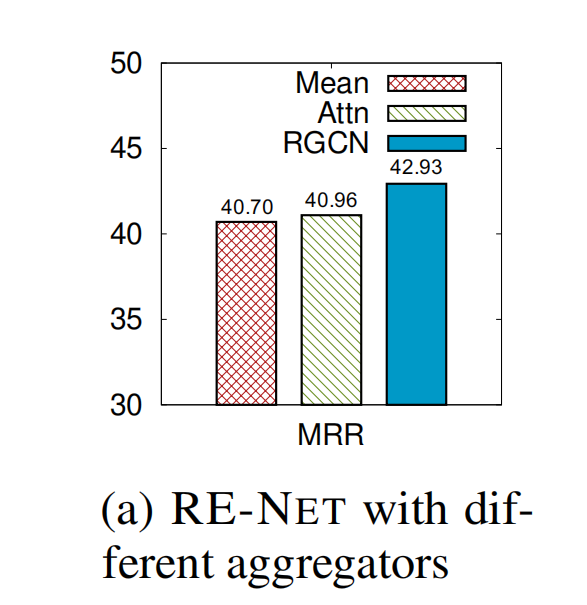
以MRR为评价指标,针对不同聚合器的实验结过如下图所示:
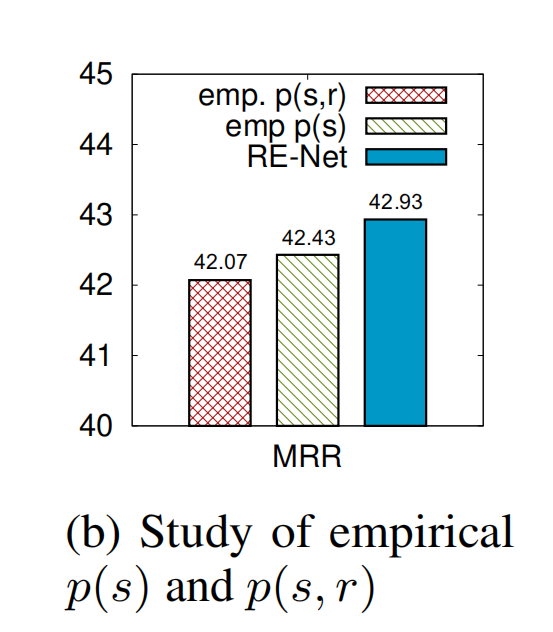
论文还说明了训练\(p(s_t|G_{t-m:t-1})\)和\(p(r_t|s_t,G_{t-m:t-1})\)(简记为\(p(s),p(r)\))的必要性。假设实体和关系是独立的,那么\(p(s_t,r_t|G_{t-m:t-1})=p(s)p(r)\),简写等式左边为\(p(s,r)\)。令\(p_e(s)\)等于包含\(s\)的三元组/总三元组,\(p_e(r)\)等于包含\(r\)的三元组除以总三元组,以MRR为评价指标,所得结果如下图:
消融实验探索了在没有聚合器和没有多步推理情况下RE-Net的能力。另一方面,如果允许RE-Net使用Ground Truth,实验效果会提高,但这是不被允许的,具体实验结果如下图所示:
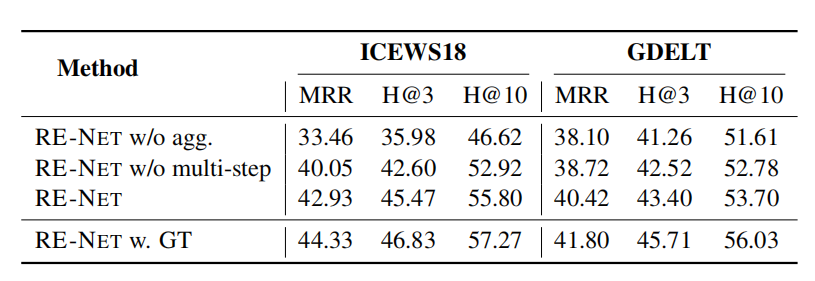
GT指的是在测试集中出现的事实,在预测完某个时间戳之后,将测试集中该时间戳的数据加入训练集
参数敏感性实验
实验探索了历史事件长度,截断的数量k,RGCN的层数,全局表示对最后模型性能的影响,具体实验结果如下图所示:
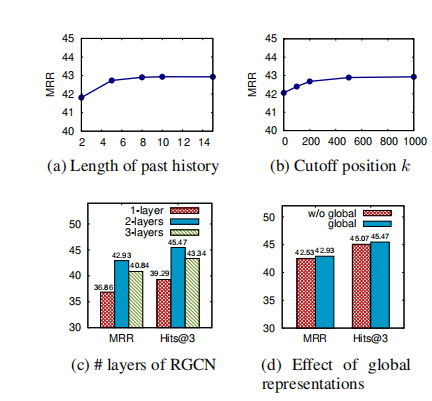
- (a)历史长度指的是,模型需要根据过去多少时间戳的数据进行新事件的预测
- (b)\(k\)指的是算法一中截取的三元组数量
- (c)\(RGCN\)层数指的是聚合器需要聚合目标实体周围实体和关系的跳数
- (d)探索了全局表示对模型的影响
案例分析
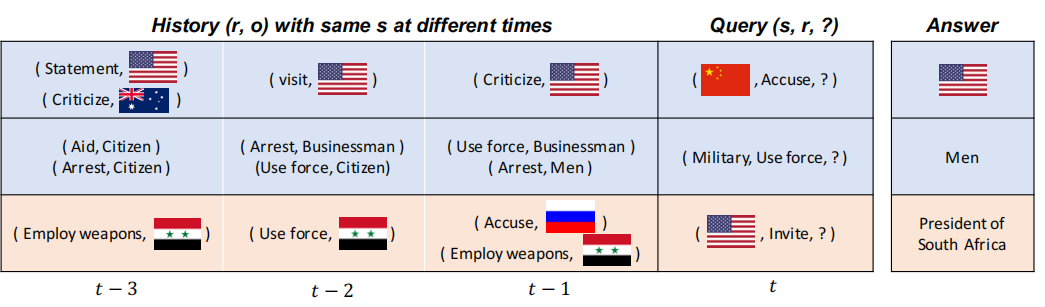
分析RET-Net在何种案例情况下能够准确预测。将案例分为三种情况:
- 待预测主体频繁与同一个客体交互
- 有特定的时序模式
- 与预测事件毫无关联
对于第一种案例,因为China不断与同一客体USA交互,故RE-Net可以正确预测,而静态方法更可能预测在训练集中和关系Accuse有关系的实体。
对于第二种案例,如果过往事件存在某种逻辑上的关系,那么RE-Net也可以正确的捕捉这种关系,并进行预测。
对于第三种案例,待预测客体在先前的事件中完全没有任何规律,故RE-Net在预测该类客体的能力上表现较差。
三个案例的示意图如下图所示:
论文结论
- 定义了所有事件的条件概率分布,因此可以将预测事件转换为时序推理任务
- 如果过往事件对预测事件无帮助,效果可能会不好
- 长时间的知识图谱预测能力较弱
论文总结
论文聚焦于时序知识图谱的未来事件外推预测任务,核心设计启发为两点:
时序维度:历史发生的事件会对未来事件的发生产生关键影响;
结构维度:预测目标事件时,与事件中实体、关系相关的邻域实体和关联关系,会提供关键的结构信息。
基于第一点启发,论文提出了事件的自回归联合概率分布建模,刻画未来时间步事件发生的可能性;同时将联合概率拆解为「主体预测→关系预测→客体预测」的链式条件概率,从实体出发逐步生成完整三元组,天然建模了主体、关系、客体三者的依赖关系,让生成的事件语义关联性更强。基于第二点启发,论文设计了多关系邻域聚合器,用于聚合实体的邻域结构信息、区分不同关系的语义,捕捉同一时间步内并发事件的结构依赖。
该方法解决了 Know-Evolve 等早期方法无法处理同一时刻并发事件、推理时必须依赖测试集真实标签、无法实现多步未来预测的核心痛点,将未来事件预测转化为可端到端学习的自回归时序结构推理任务。
该方法存在两个原生局限:
长时序预测效果会持续衰减:多步预测时,模型会复用前一步自主生成的伪图谱作为历史输入,生成的误差会逐步累积,预测时间步越远,效果越差;
对历史弱关联 / 无关联的事件预测能力差:RE-NET 的预测完全依赖历史事件的规律,当未来事件和历史信息无强关联时,模型无法学习到有效规律,预测效果会显著下降。
\(Fin.\)