论文全称:UniHR: Hierarchical Representation Learning for Unified Knowledge Graph
作者信息:
发表信息:2026 年AAAI CCFA会议
领域定位:知识图谱统一化表示学习
代码仓库:https://github.com/zjukg/UniHR
论文背景
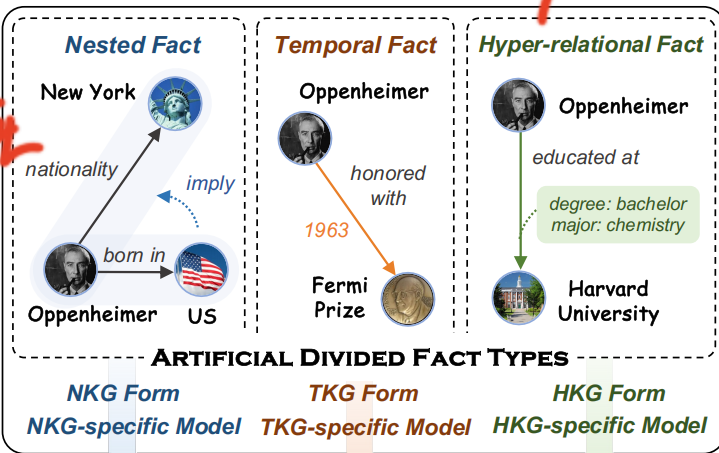
真实世界的知识图谱被广泛应用在各种领域,如问答和自然语言处理等。传统三元组不能充分表示真实世界,因此,某些包含超关系、时序知识和嵌套事实等额外信息的知识图谱被用于建模事件。
- 超关系知识图谱:除了普通三元组以外,在关系上还包含一些额外信息,如:((奥本海默,受教育于,哈佛大学),学位:学士,专业:化学)
- 时序知识图谱:除了普通三元组外,还包含时序信息,如:(勒布朗詹姆斯,效力于,迈阿密热火,[2011-2014])
- 嵌套事实知识图谱:除了普通三元组外,还包含三元组之间的关系,如:((奥本海默,出生于,纽约),蕴含,(奥本海默,国籍为,美国))
三类知识图谱示意如下图所示:
现有研究主要有以下两个问题:
1)这些知识图谱不能反应有多种异构事实的真实场景,只能把它们分离,单个建模。
2)先前基于三元组知识图谱嵌入的方法证明了分层事实语义建模的有效性,但是超越三元组的表示形式较为复杂,这些方法无法实现全面的层级化语义建模,无法泛化到其它事实类型。
因此,提出一种针对具有多关系的真实世界知识图谱的统一的层次表示学习方法是值得研究的。
本文提出UniHR,一种统一层次表示学习框架,由层次数据表示模块(HiDR)和层次结构学习模块(HiSL)组成。
- HiDR负责将不同知识图谱在不丢失信息的情况下转换成统一的三元组结构
- HiSL通过事实内消息传递捕获局部语义信息,再利用事实间消息传递丰富全局结构信息以获得更好的节点嵌入
更新的节点嵌入将会被送入解码器用于链路预测。
论文的贡献可以总结为以下三点:
- 强调了不同知识图谱统一表示,统一学习的重要性
- 提出了第一个统一的层次知识图谱表示学习框架UniHR
- 方法在不同数据集展示了良好的效果
相关工作
- 超关系知识图谱:早期的超关系知识图谱补全只针对局部信息或全局信息。方法要么只关注了事实内交互(一个事实内部的元素)、要么只关注了事实间交互(共享了实体的事实)。最新的方法尝试对该知识图谱进行多层建模,但是针对该知识图谱的分层方法很难泛化到其它类型的事实中。
- 嵌套知识图谱:23年首次被提出,但是现有的方法由于嵌套知识图谱表示的复杂性,很难掌握事实内的语义信息。
- 时序知识图谱:针对该类型图谱的方法聚焦于设计杰出的时间感知模块,如用四阶张量分解+时间正则、几何空间建模单个事实内的方法,和沿着时间轴得到实体领域子图的的建模事实间的方法。没有一个方法可以同时捕捉两个层面。
论文方法
UniHR总体架构如下图所示:
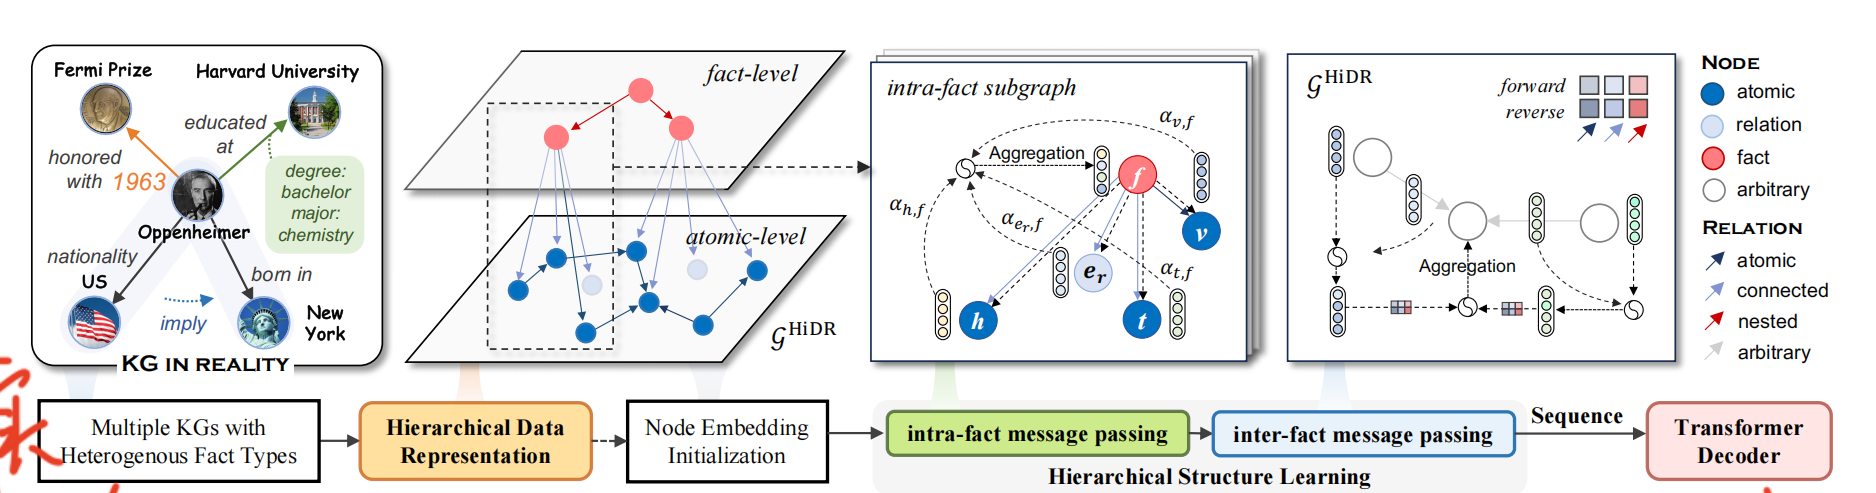
分为以下三步:
1)给定任意类型的知识图谱,记为\(G\),通过HiDR将其转换成\(G^{HiDR}\)
2)\(G^{HIDR}\)将会被HiSL模块编码,以增加特定事实的语义信息和,和整个图中不同事实的结构信息
3)解码阶段,更新后的节点和边嵌入向量被序列化后输入Transformer模块以优化模型性能
Hierarchical Data Representation(HiDR)模块
把实体和关系全都划分成三个类型。
节点的三个类型包含:
- 原子节点:本身存在于知识图谱中的实体节点,记作\(V_a\)
- 关系节点:将关系抽象成节点,记作\(V_r\)
- 事实节点:将三元组事实抽象成节点,记作\(V_f\)
关系的三个类型包含:
- 原子关系:本身存在于知识图谱中的关系和HKG中的value,记作\(R_a\)
- 连接关系:HiDR定义的专属关系,对应关系{has relation,has head entity,has tail entity},记作\(R_c\)
- 嵌套关系:两个事实之间的关系,记作\(R_n\)
由此衍生出来的三种事实类型包含:
- 原子事实:本就存在于知识图谱中的事实,记作\(F_a\)
- 连接事实:对应三元组(f,has relation,r),(f,has head entity,h),(f,has tail entity,t),记作\(F_c\)
- 嵌套事实:两个原子事实\(\alpha,\beta\)之间存在某种关系\(r\),\((\alpha,r,\beta)\)即为嵌套事实,记作\(F_n\)
定义\(G^{HiDR}=\{V^{HiDR},R^{HiDR},F^{HiDR}\}\)
其中,\(V^{HiDR}=V_a \cup V_r \cup V_f,R^{HiDR}=R_a \cup R_c \cup R_n,F^{HiDR}=F_a \cup F_c \cup F_n\)。
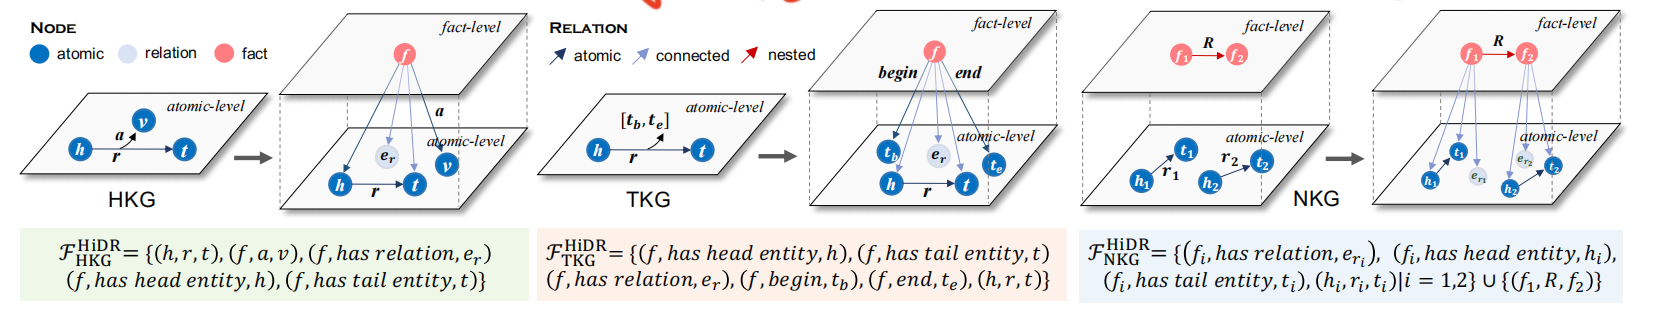
①对于超关系知识图谱:
\(F_c\)除了上述连接事实以外,还包含由事实,及事实上的键值对构成的三元组。具体为(f,k,v)。\(F_n=\varnothing\),因为该类型知识图谱事实之间没有嵌套关系。
②对于嵌套知识图谱:
\(F_c,F_a\)同定义,\(Fn=\{(f_1,R,f_2)|f_i\in F_{NKG}\}\)。
③对于时序知识图谱:
将时序知识图谱转换成特殊的超关系知识图谱,对于每个四元组\((h,r,t,[t_1,t_2])\),先将其转换为\((h,r,t,begin:t_1,end:t_2)\)的类HKG形式,再按照HKG的模式转换成\(G^{HiDR}\)。
各知识图谱转换方式如下图所示:
Hierarchical Structure Learning (HiSL)模块
HiDR定义了大量的额外节点,为了避免引入大量的训练参数,论文设计一个层级结构学习模块(HiSL),分成三个步骤实现:
表示初始化
对于HKG,事实上的键值对k:v,key作为连接关系,value作为原子关系
初始化所有原子实体的嵌入\(H_a\in R^{|v_a| ×d}\)以及所有关系(包含连接关系、嵌套关系)的嵌入\(E\in R^{|R^{HiDR}| ×d}\),再初始化原子关系节点嵌入\(H_r\in R^{|v_r| ×d}\),该嵌入由原子关系嵌入\(E_a\)经过可学习的投影矩阵\(W_r\)变化而来,其中\(E_a\in E\),具体表达式为\(H_r=E_a·W_r\)。
初始化事实节点嵌入\(H_f\)以学习事实内的关键信息,具体公式为: \[ h_f=f_m([h_h;h_r;h_t]) \] \(h_h,h_r,h_t\)是一个事实内头尾实体和关系的嵌入,通过连接操作变成一个维度为\(3d\)的向量。\(f_m\)是一个一层的多层感知机,将该向量维度转换为\(d\)。
对于时序知识图谱的时间节点t,使用Time2Vec将其编码,具体公式为: \[ h_{\tau}=w_psin(f_p(\tau))+f_{np}(\tau) \] \(f_p,f_{np}\)均是一个一层的多层感知机,分别作为周期函数和非周期函数,将一个时间标量转换为\(d\)维向量。\(w_P\)是一个一维的可学习参数,用于缩放周期特征。
事实内消息传递
针对每一个事实,构建一个子图,子图只包含事实节点、在该事实内与事实相连的原子节点、连接的边,旨在学习完整的事实成立条件。
给定初始嵌入,逐层次学习,在学习的过程中,通过注意力机制不断更新事实节点和原子节点:
- 事实节点的更新可以理解成:把各个原子节点打包,聚合所有组成元素的信息,更新完整的事实语义
- 原子节点的更新可以理解成:让各个原子节点获得在该事实下的表示
注意力权重的计算公式为: \[ \alpha_{i,j}^l=\frac{exp(W^l(\sigma(W^l_{in}h^l_i+W^l_{out}h_j^l)))}{\sum\limits_{j'\in N_i}exp(W^l(\sigma(W^l_{in}h_i^l+W^l_{out}h^l_{j'})))} \] \(h_i^l,h_j^l\)为中心实体\(i\)和邻居实体\(j\)在第\(l\)层的嵌入。\(W_{in}^l\)为第\(l\)层的可学习矩阵,类似于Transfomer中将嵌入转换为Q向量的矩阵,\(W_{out}^l\)的作用则是将嵌入转换为K,V向量的聚合。\(W^l\)则是第\(l\)层的一个评分矩阵,用于学习组合的合理性。
个人理解:尽管论文当中子图的所有结点均能当作中心结点,但是对于非事实结点而言,其邻居节点只有事实结点一个结点,故注意力权重得分只有一项且为1,更新的时候也是只考虑该事实带来的语义
注意力得分的计算过程可以理解成:
从中心实体出发,通过两个可学习矩阵,进行向量的变换,得到一个类似于我的身份是xx,我的邻居能给我提供的信息是xx,它的信息是xx的向量,通过\(W^l\)给出评价,再经过\(Softmax\)进行归一化,得到最后的注意力分数。
得到注意力权重后,更新结点表示,公式如下: \[ h_i^l=h_i^l+\sum_{i\in N_i}\alpha^l_{i,j}·W^l_{out}h^l_j \]
事实间消息传递
目的是学习全局结构,丰富结点语义信息,消息传递将会在整张图\(G^{HIDR}\)上执行。
为了不增加要训练的参数,并更好的融合关系和实体信息,使用非参数循环算子\(\phi(·)\),它可以将两个\(d\)维的向量转换为一个\(d\)维向量,公式如下: \[ \phi(h_j,e_r)=h_j\star e_r=F^{-1}((Fh_j)\odot(\overline{Fe_r})) \] \(F,F^{-1}\)分别代表傅里叶变化矩阵及其逆矩阵。通过该操作,可以把关系+实体变成连贯的语义。
为了更好的掌握图的异质性,将边从两个维度进行分类,并分别设置可学习参数:
方向维度:包含两个方向\(\lambda(r)\in\{forward,reverse\}\)。GNN消息传递的方向是从邻居节点到中心节点,如果图谱中关系方向和消息传递方向不一致,即,图谱中的关系方向是中心节点到消息节点,那么该关系对应的方向为\(reverse\)
类型维度:包含三种类型\(\tau(r) \in\{connected\;relation,atomic\;relation,nested\;relation\}\),分别对应了关系的三种类型。
对于方向维度,设置两个可学习参数\(W_{\lambda(r)}\in R^{d×d}\),分别代表正向和逆向,用于学习不同方向关系的贡献;对于类型维度,设置三个可学习参数\(w_t(r)\in R^1\),用于学习三种类型关系的贡献。
通过下式更新实体表示: \[ h_i^{l+1}=\sum_{(r,j)\in N(i)}\sigma(w_{\tau(r)}^l)W^l_{\lambda(r)}\phi(h_j^l,e^l_r)+W^l_{self}h^l_i \] \(N(i)\)是所有与\(i\)相连的节点,\((r,j)\)是对应的关系及节点,\(\sigma\)是\(sigmoid\)函数。通过聚合周围所有实体及关系的信息,再加上自环项保留自身语义信息,实现对节点嵌入的更新。
对于关系表示,每一层也会按照下式更新: \[ e^{l+1}_r=W^l_{rel}e^l_r \] \(W_{rel},W_{self}\)学习的是自己的信息应该保留多少、自己应该怎么变。
链路预测解码器
采用TransFomer的解码器,将更新好的嵌入,用\([M]\)掩盖需要预测的部分,获得最后一层输出的\([M]\)向量,记作\(h_{pre}\),并计算所有候选答案的概率分布。 \[ P=Softmax(f(h_{pre}[E;H])^T)\in R^{|R|+|V|} \] \(P\)代表所有候选实体的分数,\(f()\)是一个一层感知机,用于映射预测向量,\([E;H]\)是所有候选的边和实体的矩阵。
损失函数使用交叉熵函数,具体如下: \[ L=\sum_{t=0}^{|R|+|V|}y_tlogP_t \] \(y_t,p_t\)分别代表第\(t\)类的真实标签和概率。
论文实验
* 代表作者复现所得结果,加粗代表效果最好的模型,下划线代表效果第二好的模型
实验涉及到的数据集统计如下图所示:
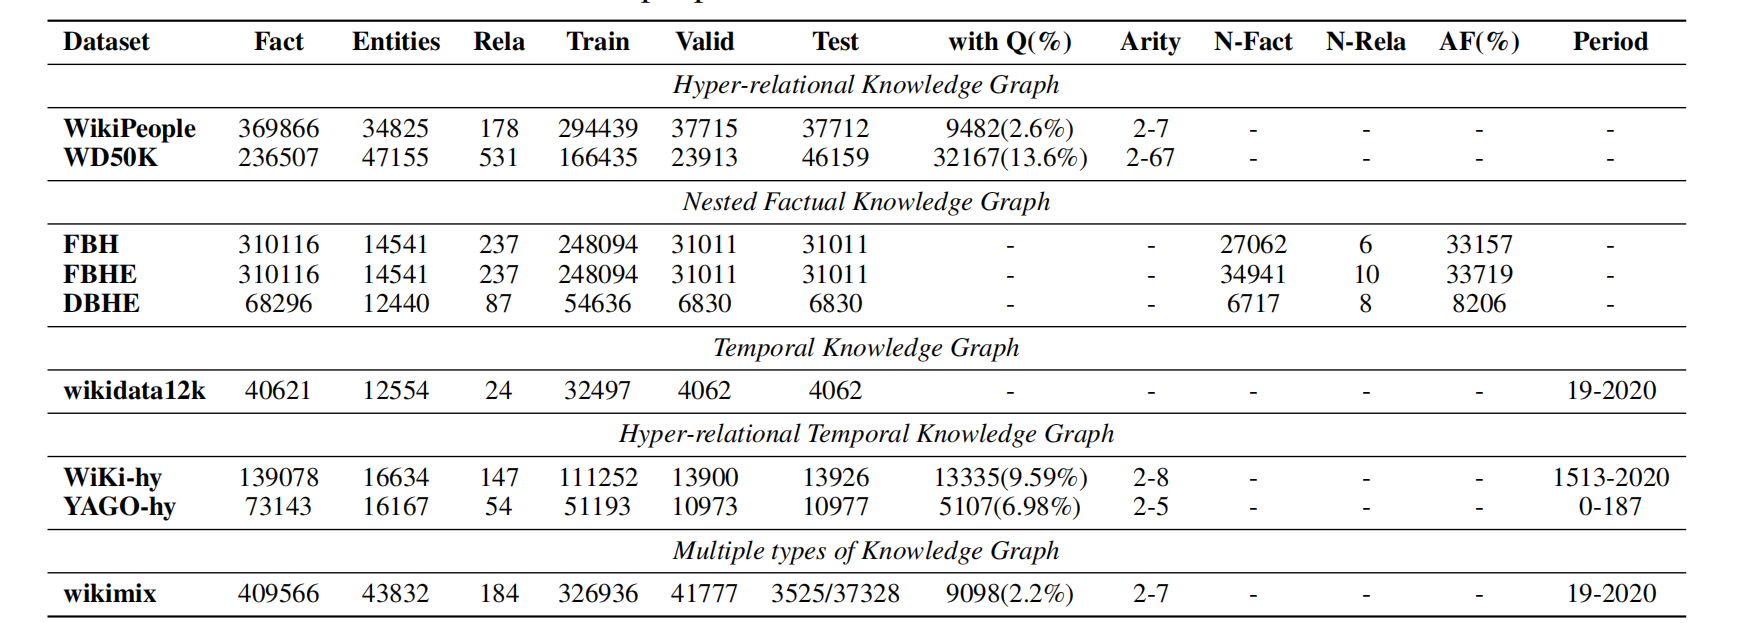
With Q指包含超关系的事实占比;Arity是元数数量,大于2则代表超关系;N-Fact是嵌套进其它事实中的事实数量;N-Rela是嵌套事实的类型;AF指的是嵌套事实拆开后,原子事实的个数。如:F1 =(周杰伦,创作了,F2),F2 =(晴天,收录于,叶惠美),这样嵌套事实就只有F2一条,AF有(周杰伦,创作了,晴天),(晴天,收录于,叶惠美)两条。
实验设置超参数如下图所示:
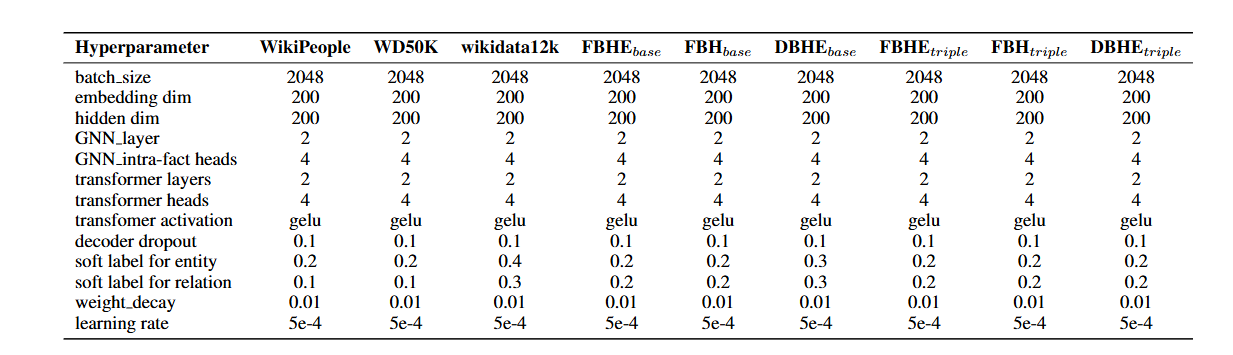
在HKG上的链路预测
在HKG上的预测结果如下图所示:
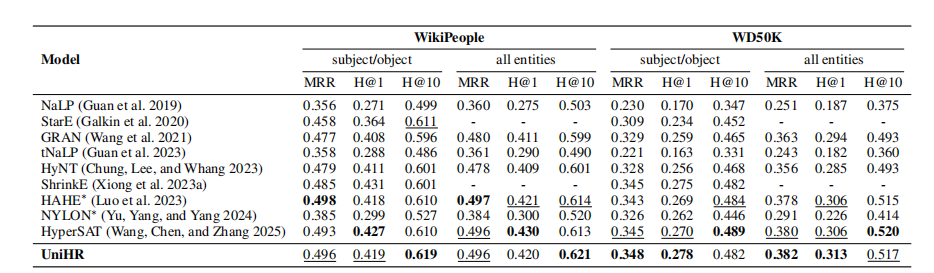
HKG是超关系知识图谱,某些事实包含额外的键值对,任务包括预测传统三元组实体、预测键值对实体。
StarE构建专门的GNN,将键值对当作辅助语料信息,故天生不支持键值对实体的预测。
ShrinkE则将目标实体限定在一个框内,键值对的作用仅仅是用来缩框,故也不支持键值对实体的预测。
在NKG上的链路预测
在NKG上的预测结果如下图所示:
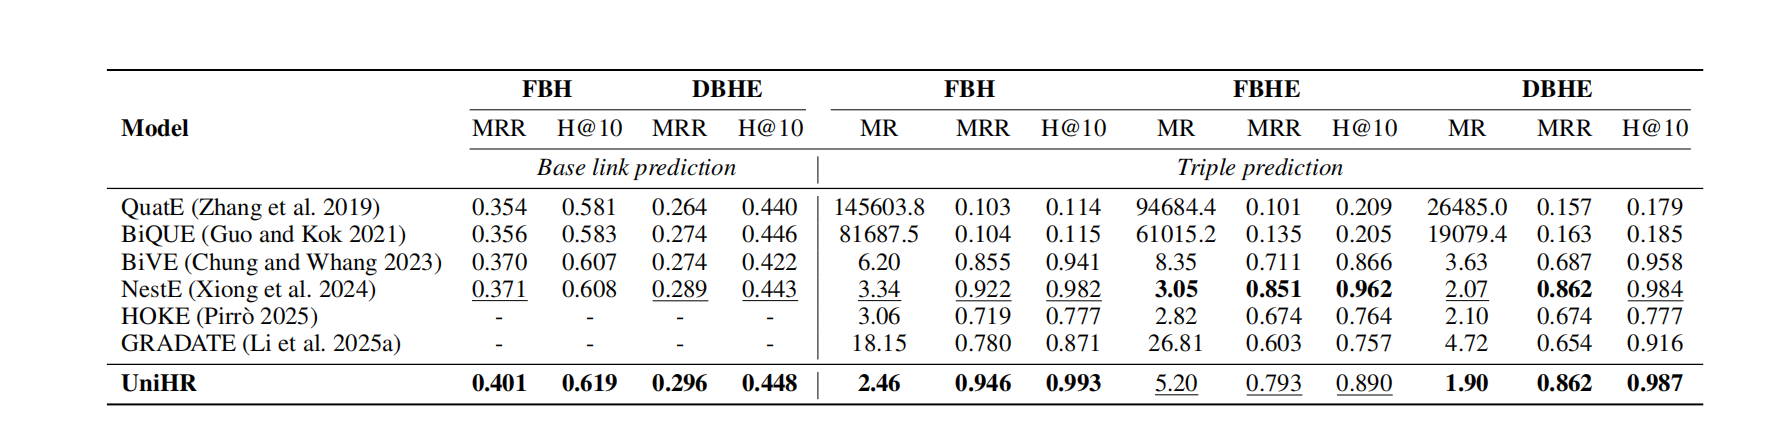
NKG是嵌套知识图谱,某些事实中包含额外的嵌套事实,任务包括预测传统三元组、预测缺失的嵌套三元组。
QuatE和BiQUE面向标准三元组,故在带有嵌套事实的知识图谱的三元组预测任务中的MR极高,该任务需要预测的对象包括一整条三元组。
HOKE和GRADATE则是聚焦于将嵌套知识图谱进行原子拆分,再进行链路预测,而非针对预测缺失的嵌套三元组。
在TKG上的链路预测
在TKG上的预测结果如下图所示:
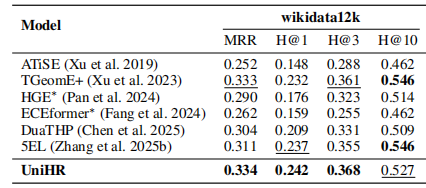
TKG是时序知识图谱,过去的方法侧重于将时间戳融入实体的嵌入,让实体掌握一定的时序信息。UniHR则是直接将时间信息也作为一个实体进行嵌入,说明结构信息对于时序知识图谱而言也很重要。
消融实验
消融实验探讨了不把事实初始化为可学习节点、不把关系初始化为可学习节点、不做事实内学习、不考虑关系类型权重、不考虑方向权重、不做事实间学习这五种情况,具体实验结果如下图所示:
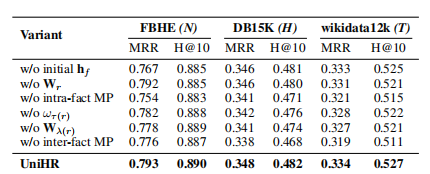
可以看到,关系节点的实体化仅仅起到一个辅助作用,但是事实节点的初始化对NKG的预测影响较大,因为NKG的预测任务中包括完整的三元组预测。
其它实验
①在HTKG上的链路预测
论文提出的方法由于具有较强的统一化表示能力,故在混合知识图谱WiKi-hy和YAGO-by对模型进行测试。这两个知识图谱的事实包含时序以及键值对,具体的实验结果如下图所示:
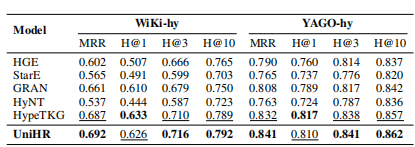
UniHR也具有可竞争的表现
②联合学习
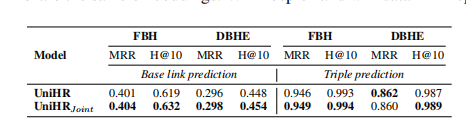
对NKG的两个任务进行联合学习:相比于分任务单独计算损失函数并更新模型参数,此方式让模型两种任务的损失函数合并,并更新参数,实验结果如下图所示:
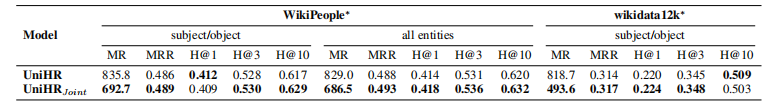
对知识图谱进行联合学习:让模型直接在混合知识图谱上学习,该图谱包含基本三元组事实、带时序事实、带超关系的事实等。实验结果如下图所示:
相较于单独学习,联合学习对模型的能力有所提高,直观表现图如下图所示:
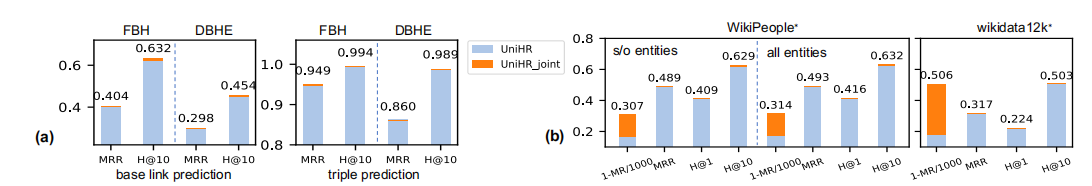
橙色代表联合学习比单个学习多出来的效果。
同时,联合学习可以使相同类型的实体嵌入更紧凑,使不同类型的实体嵌入簇边界更明显,这使得模型能够更好的学习实体的表示,实体嵌入可视化图如下:
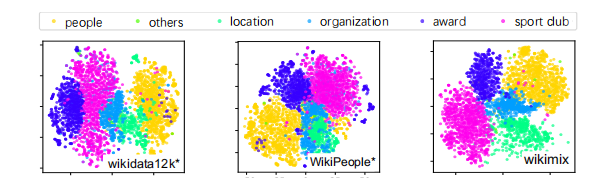
③模型效率分析
UniHR的参数量和训练时间相较于其它模型都更少,具体对比图如下:
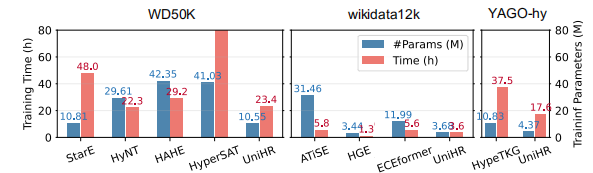
④解码器分析
采用ConVE的解码器,对嵌套知识图谱采用两种输入模式的打分函数,打分函数公式如下: \[ vec(\sigma([\tilde{h_h};\tilde{e_r}]*\varphi)) \]
- \(s_f\)代表输入的三元组为传统的(h,r,t)形式,对底层三元组打分
- \(s_h\)代表输入的三元组为(f,has head entity,h),(f,has tail entity,t)形式,可以对嵌套三元组打分
如果不设置专门的打分函数,ConVE无法理解嵌套事实。如需要打分的三元组为\(f = (F_1,r,F_2)\),\(F_1,F_2\)为两个嵌套事实,\(F_2\)为预测的补全项。那么:
- \(s_f\)可以对\((F_1,r,F_2)\)进行打分
- \(s_h\)可以对\((f,has\;tail\;entity,F_2)\)打分。
具体实验结果如下图所示:
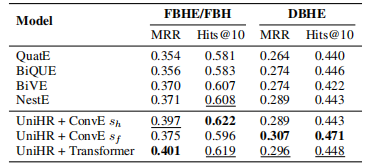
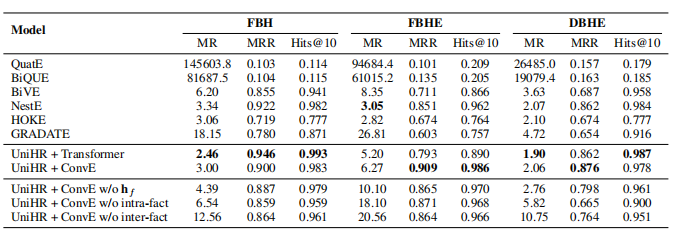
不同解码器对比及消融实验结果如下图所示:
论文结论
- 提出一种统一的分层知识图谱表示框架,该框架由HiDR、HiSL组成
- 实验表明在不同数据集以及复杂场景下,该模型均有可竞争性的表现
论文总结
论文主要聚焦于多维度知识图谱统一表示,下一步工作:
- 复现该论文,尤其是事实内消息传递的框架
- 考虑将结构间加结构内事实融入时序知识图谱结构中,借鉴这篇论文的事实间传递规则,使得时序知识图谱能够学到事实内语义,下一篇论文聚焦于事实间传递的时序知识图谱,看看能否做融合
代码结构
代码由数据集和五个主要文件组成:
NKG数据集:DBHE、FBH、FBHE,包含原子三元组,词汇表由两个特殊编码[PAD]、[MASK],关系,实体和原子事实构成
HKG数据集:wikipeople、wd50k,词汇表由两个特殊编码[PAD]、[MASK]、关系、实体构成,key作为关系,value作为实体
TKG数据集:wikidata12k,词汇表由两个特殊编码[PAD]、[MASK]、实体和时间戳构成
五个主要文件:
- run.py:训练/测试入口
- reader.py:数据读取、样本构造、batch组织
- graph.py:把训练事实构造成全局图(HIDR/HiSL用)
- transformer.py:模型主体:全局图编码 + 局部Transformer解码
- evaluation.py:filtered evaluation 和指标计算
运行入口在run.py,初始定义数据集信息,包括以下参数:
| 属性名 | 默认值 | 含义 |
|---|---|---|
| dataset | wd50k(HKG) | 数据集 |
| vocab_size | 47688 | 词汇表大小 |
| vocab_file | ./data/wd50k/vocab.txt | 词汇表文件路径 |
| train_file | ./data/wd50k/train+valid.json | 训练集文件 |
| test_file | ./data/wd50k/test.json | 测试集文件 |
| ground_truth_file | ./data/wd50k/all.json | 包含所有元组的文件,过滤用 |
| num_workers | 1 | DataLoder多线程读取线程数 |
| num_relations | 531 | 候选关系数 |
| num_ent | 0 | TKG中除去时间实体以外的原始实体数 |
| max_seq_len | 63 | 被序列化后的最大长度 |
| max_arity | 32 | 元数,主三元组算两个元,(k:v)算一个元 |
| nest_meta | False | 是否把事实节点当作预测答案 |
| num_entities | args.vocab_size - args.num_relations - 2 | 所有除掩码、关系以外的实体数量 |
| temp | False | TKG标识 |
从main()出发,程序流程如下:
#定义vocabulary类
  vocabulary = Vocabulary(
     vocab_file=args.vocab_file,
     num_relations=args.num_relations,
     #包含时间和具体实体
     num_entities=args.num_entities,
     #纯实体数量
     num_ent = args.num_ent)
- vocab_file 为存放词汇表的路径
- num_relations 为关系数量
- num_entities 为词汇表中除去[MASK]、[PAD]两个特殊掩码以及关系数量后,其余实体的数量
- num_ent 为纯实体数量,针对TKG,在num_entities的基础上再减去时间实体
调用入口run.py -> reader.py
#获取数据集
train_examples, _ = read_examples(args.train_file, args.max_arity)
test_examples, _ = read_examples(args.test_file, args.max_arity)调用reader.py的read_examples()方法(以默认的HKG数据集wd50k为例),数据结构类似于
N代表参与该事实的实体数,故一个三元组的实体数N为2
{"N": 2, "relation": "P1981", "subject": "Q482436", "object": "Q20644794"}
{"N": 2, "relation": "P31", "subject": "Q8150", "object": "Q159821"}
{"N": 2, "relation": "P725", "subject": "Q210311", "object": "Q20630994"}
{"N": 4, "relation": "P2293", "subject": "Q12174", "object": "Q18052481", "P459": ["Q1098876", "Q23190853"]}方法中定义两个数据结构examples、total_instance用来存放转换后的example和总实例长度。
对每一行,先提取基本的三元组和元数N。定义auxiliary_info存放超关系,初始化为None。
if arity > 2:
    auxiliary_info = collections.OrderedDict()
    # store attributes in alphabetical order
    for attribute in sorted(obj.keys()):
        if attribute in ("N", "relation", "subject", "object"):
            continue
        # store corresponding values in alphabetical order
auxiliary_info[attribute] = sorted(obj[attribute])如果元数大于2,说明该图谱为超关系知识图谱,定义auxiliary_info为一个有序字典,先按照key排序,如果当前key为基本三元组的key,则跳过不处理。对于每一个key,再排序其中的value(一个key对应多个value)。最后得到的auxiliary_info类似于:
{
    "degree": ["bachelor", "master"],
    "major": ["chemistry", "physics"]
}如果元数不足最大元数max_arity,说明这是一条符合要求的数据
if arity <= max_arity:
    example = NaryExample(
        arity=arity,
        head=head,
        relation=relation,
        tail=tail,
        auxiliary_info=auxiliary_info)
    examples.append(example)
    #元数减2为key,value的对数,每一对长度为2,加上初始的三元组长度 3 得到当前实例长度
total_instance += (2 * (arity - 2) + 3)将其作为example加入列表,并加上当前实例长度至总实例长度。
最后返回的example列表包括每一条数据的(元数,头实体,关系,尾实体和键值对字典)。
同时方法还对超过最大元数的数据进行了过滤。
返回出口reader.py -> run.py
回到run,py的main(),获得了过滤后且有序的数据后,为训练集和测试集分别创造reader.py的MultiDataset类:
调用入口run.py->reader.py
#max_seq_len为最大序列长度
train_dataset = MultiDataset(vocabulary, train_examples, args.max_arity, args.max_seq_len)
test_dataset = MultiDataset(vocabulary, test_examples, args.max_arity, args.max_seq_len)MultiDataset类初始化方法如下,具体代码左右用注释表示:
def __init__(self, vocabulary: Vocabulary, examples, max_arity=2, max_seq_length=3):
    #实例列表
    self.examples = examples
    #vocabulary类
    self.vocabulary = vocabulary
    #允许的最大元数
    self.max_arity = max_arity
    #允许的最大序列长度
    self.max_seq_length = max_seq_length
    #调用将实例转换为特征的方法
    self.features = convert_examples_to_features(
        examples=self.examples,
        vocabulary=self.vocabulary,
        max_arity=self.max_arity,
        max_seq_length=self.max_seq_length)
    self.multidataset = []
    #拼接特征
    for feature in self.features:
        feature_out = [feature.input_ids] + [feature.input_mask] + \
        [feature.mask_position] + [feature.mask_label] + [feature.mask_type]
self.multidataset.append(feature_out)初始化过程中调用了reader.py的convert_examples_to_features()方法:
调用入口reader.py->reader.py
#convert_examples_to_features()方法
def convert_examples_to_features(examples, vocabulary, max_arity, max_seq_length):
    """
    Convert a set of NaryExample into a set of NaryFeature. Each single
    NaryExample is converted into (2*(n-2)+3) NaryFeature, where n is
    the arity of the given example.
    """
    max_aux = max_arity - 2
    assert max_seq_length == 2 * max_aux + 3, \
        "Each input sequence contains relation, head, tail, " \
        "and max_aux attribute-value pairs."

    features = []
feature_id = 0方法先判断当前的输入序列是否为最大序列,定义两个数据结构features、feature_id分别存放特征和特征id。
遍历examples中的每一个example,对于每一个example
① 得到原始的输入和掩码位,定义四个列表,分别用来存放key、key的掩码位、value、value的掩码位:
#基本三元组
hrt = [ example.head, example.relation, example.tail ]
#基本三元组掩码位
hrt_mask = [1, 1, 1]

#key,value
aux_q = []
#key,value掩码位
aux_q_mask = []

#辅助信息用
aux_values = []
#辅助信息用
aux_values_mask = []
② 如果有超关系,把超关系展平为[k1,value1,k1,value2,k2,value3]的形式:
if example.auxiliary_info is not None:
    for attribute in example.auxiliary_info.keys():
        for value in example.auxiliary_info[attribute]:
            #将key对应的所有value都加入到aux_q 并将掩码位设置为1
            aux_q.append(attribute)
            aux_q.append(value)
            aux_q_mask.append(1)
            aux_q_mask.append(1)
③ 最大元数为max_arity,减去主三元组的元数2后,留给key,value的元数为max_aux,对应的序列长度为2max_aux。如果当前实例的key和value长度不足2max_aux,则全用[PAD]补全剩余位置,同时掩码位置0:
#不够最大位置的输入用[PAD]补全
while len(aux_q) < max_aux*2:
aux_q.append("[PAD]")
aux_q.append("[PAD]")
aux_q_mask.append(0)
aux_q_mask.append(0)
assert len(aux_q) == max_aux*2
④ 整合原始输入和原始掩码位(三元组+超关系组合):
#原始输入序列是 hrt加上key value 和 [PAD]
orig_input_tokens = hrt + aux_q
#原始掩码是非[PAD]部分全为1
orig_input_mask = hrt_mask + aux_q_mask
assert len(orig_input_tokens) == max_seq_length and len(orig_input_mask) == max_seq_length
⑤ 对于每一条实例,将刚才处理的输入信息转换为模型输入的特征:
# generate a feature by masking each of the tokens
for mask_position in range(max_seq_length):
    #如果当前输入的token是PAD,则不做掩码处理
    if orig_input_tokens[mask_position] == "[PAD]":
        continue
        #当前token在词汇表中的索引
        mask_label = vocabulary.vocab[orig_input_tokens[mask_position]]

        #偶数位置是实体,奇数位置是关系
        mask_type = 1 if mask_position % 2== 0 else -1

        #切片记录原始所有输入的Token
        input_tokens = orig_input_tokens[:]

        #将当前位置的Token变成[MASK]
        input_tokens[mask_position] = "[MASK]"

        #把输入的Token 变成各Token 在词表文件中的索引
        input_ids = vocabulary.convert_tokens_to_ids(input_tokens)

        assert len(input_tokens) == max_seq_length and len(input_ids) == max_seq_length

        #创建一个特征类
        feature = NaryFeature(
            #当前特征的id 每个特征唯一
            feature_id=feature_id,

            #当前实例的id 每个实例唯一
            example_id=example_id,

            #把当前的位置变成MASK,赋值给feature的input_tokens
            input_tokens=input_tokens,

            #把token变成索引,赋值给feature的input_ids
            input_ids=input_ids,

            #原始的可以将token变为MASk的位置
            input_mask=orig_input_mask,

            #当前将token变为MASK的位置
            mask_position=mask_position,

            #当前token在词汇表中对应的索引
            mask_label=mask_label,

            #当前token的类型
            mask_type=mask_type,

            #当前实例的元数
            arity=example.arity)

        #将特征加入特征列表,一个实例对应其 序列长度 个特征
        features.append(feature)
        feature_id += 1
一条实例经过处理后,每个位置都可以被MASK替代,故一条实例会对应多条特征,每条特征包含的信息如上。
返回出口reader.py->reader.py
回到MultiDataset类,将每一条特征(经过掩码处理后)做如下拼接:
#拼接特征
for feature in self.features:
    feature_out = [feature.input_ids] + [feature.input_mask] + \
    [feature.mask_position] + [feature.mask_label] + [feature.mask_type]
self.multidataset.append(feature_out) MultiDataset类还有如下两个方法:
#获取当前拼接后数据集的长度 (和特征数相同)
def __len__(self):
    return len(self.multidataset)
#获取对应的拼接特征
def __getitem__(self,index):
    x = self.multidataset[index]
    batch_data = prepare_batch_data(x, self.vocabulary, self.max_arity, self.max_seq_length)
return batch_data在get_item()方法中,还会调用reader.py的prepare_batch_data()方法,
调用入口reader.py -> reader.py
def prepare_batch_data(inst, vocabulary: Vocabulary, max_arity, max_seq_length):
    # inst: [input_ids, input_mask, mask_position, mask_label, query_type]
    #输入的token 索引
    input_ids = np.array(inst[0]).astype("int64")
    #有效的掩码位置
    input_mask = np.array(inst[1]).astype("int64")
    #当前掩码位置
    mask_position = np.array(inst[2]).astype("int64")
    #当前掩码token的索引
    mask_label = np.array(inst[3]).astype("int64")
    #需要查找到token类型
    query_type = np.array(inst[4]).astype("int64")
input_mask = np.outer(input_mask, input_mask).astype("bool")方法先获取相关信息,再利用outer()方法,判断哪些token直接可以进行注意力,将input_mask变成一个n*n的矩阵。
outer()方法的具体的运算规则如下 \[ input\_mask[i][j]=input\_mask[i]*input\_mask[j] \] 也就是只有两个对应位置都是1时,生成的二维矩阵的对应位置才会为1,代表两个token之间可以进行注意力机制的运算。
构造一个关系类型矩阵,记录一条特征中每个位置的实体,和其它位置的实体:
edge_labels = []
max_aux = max_arity - 2
#头实体和其它实体\关系的关系类型
edge_labels.append([0, 1, 2] + [3,4] * max_aux )
#关系和其它实体\关系的关系类型
edge_labels.append([1, 0, 5] + [6,7] * max_aux )
#尾实体和其它实体\关系的关系类型
edge_labels.append([2, 5, 0] + [8,9] * max_aux )
#每一个key,value和h,r,t的关系分别是[3,6,8]和[4,7,9]
for idx in range(max_aux):
    edge_labels.append([3,6,8] + [11,12] * idx + [0,10] + [11,12] * (max_aux - idx - 1))
    edge_labels.append([4,7,9] + [12,13] * idx + [10,0] + [12,13] * (max_aux - idx - 1))
根据待寻找的类型(实体)构造候选对象集合,并将其与注意力可行表、关系类型矩阵一并返回。
#得到一个关系相关的二维矩阵
edge_labels = np.asarray(edge_labels).astype("int64")
mask_output = np.zeros(len(vocabulary.vocab)).astype("bool")
# if vocabulary.num_entities == vocabulary.num_ent:
#候选的集合
if query_type == -1:
    mask_output[2:2+vocabulary.num_relations] = True
    else:
        mask_output[2+vocabulary.num_relations:] = True

return input_ids, input_mask, mask_position, mask_label, mask_output, edge_labels, query_type
返回出口reader.py->reader.py
至此reader.py的所有方法均执行完毕,MultiDataset类创建完毕。返回run.py。
返回出口reader.py->run.py
至此已经获得了包含特征的数据集,需要开始建立图结构:
if args.dataset in ["FBHE", "FBH", "DBHE"]:
        train_atomic_examples, _ = read_examples("/".join(args.train_file.split("/")[:3])+"/train.json", args.max_arity)
        print(f'num_train:{len(train_atomic_examples)}')

        #词组的大小 减去 关系的数量 减去 两个特殊的编码 减去 训练原子实例 得到实体数量
        #纯实体数量
        args.num_entities = args.vocab_size - args.num_relations - 2 - len(train_atomic_examples)

        #不含时间 所以纯实体数量就是实体数量
        args.num_ent = args.num_entities
        print(f'num_entities: {args.num_entities}')

        triple_train, graph_gat, graph, r, edge_norm, selected,is_atomic = build_graph(vocabulary, train_atomic_examples, args.hyperedge_dropout, device, args)
    else:
triple_train, graph_gat, graph, r, edge_norm, selected,is_atomic = build_graph(vocabulary, train_examples, args.hyperedge_dropout, device, args)如果数据集是NKG,则还需要进行如下额外的处理:
重新读取训练集实例,获得NKG中原子事实的实例
NKG的词汇表中还包含原子事实,故实体数还需要减去原子事实的数量
NKG不包含时间实体,故直接将num_ent赋值成处理后的实体数量
将vocabulary、实例、失活率、args作为参数,调用graph.py的build_graph方法。
调用入口run.py->graph.py
def build_graph(vocabulary, examples, hyperedge_dropout, device, args):

    #随机抛弃一部分实例 抛弃总实例数 × dropout个实例
    selected = int((1 - hyperedge_dropout) * len(examples))
    #random.shuffle(examples)

    #随机选一部分数据
    examples = examples[:selected]
    #三元组训练列表
    triple_train = []

    for example in examples:
        #将example转换成 词汇表中各类型中的索引
        triple_train.append([vocabulary.convert_tokens_to_ids([example.head])[0]-2-args.num_relations,
		vocabulary.convert_tokens_to_ids([example.relation])[0]-2,
        vocabulary.convert_tokens_to_ids([example.tail])[0]-2-args.num_relations])
        #边的起点
        s_gat = []
        #边的终点
        t_gat = []

        #构建HIDR
        #边的起点
        s = []
        #边的终点
        t = []
        #边的关系,指向实体
        r = []
        #是否原子节点
is_atomic = []build_graph()方法执行以下步骤:
① 抛弃一部分实例,并对剩下的实例逐条处理,对于每一条实例,先将其头、尾、关系做转换后,以三元组的形式加入triple_train列表中,转换规则如下:
- vocab.txt的顺序为,两个特殊掩码 -> 关系 -> 实体 -> 时间 或 两个特殊掩码 -> 关系 -> 实体 -> 事实,对于HKG,key算作关系,value算作实体
- 先获得待转换实体在词汇表中的索引。对于关系类型:索引 - 2,得到的是该关系在所有关系类中的索引;对于实体类型:索引 - 2,得到的是该实体在所有实体类中的索引
② 对每一个事实构建六个列表,作用分别如下:
s_gat和t_gat仅存放fact和其它实体之间的关系
- s_gat:存放图中的头实体
- t_gat:存放图中的尾实体
- s :HiDR图的头实体
- t:HiDR图的尾实体
- r:HiDR图的关系
- is_atomic:该关系是否为原子关系,即是否存在原来的知识图谱中的关系
③ 处理普通正向关系,将普通正向关系加入图中,在图中索引位置被重新定义,顺序为实体 -> 关系 -> 事实:
for hyperedge, example in enumerate(examples):

        #事实的编号 新定义 在实体和关系后面
        s_gat.append(hyperedge+args.num_entities+args.num_relations)
        #头实体的编号
        t_gat.append(vocabulary.convert_tokens_to_ids([example.head])[0]-2-args.num_relations)

        #事实的编号 新定义 在实体和关系后面
        s_gat.append(hyperedge+args.num_entities+args.num_relations)
        #关系的编号 新定义 在实体后面
        t_gat.append(vocabulary.convert_tokens_to_ids([example.relation])[0]-2+args.num_entities)

        #事实的编号 新定义 在实体和关系后面
        s_gat.append(hyperedge+args.num_entities+args.num_relations)
        #尾实体编号
        t_gat.append(vocabulary.convert_tokens_to_ids([example.tail])[0]-2-args.num_relations)

        #事实子图的起点是事实
        s.append(hyperedge+args.num_entities+args.num_relations)
        #事实子图的终点是头实体
        t.append(vocabulary.convert_tokens_to_ids([example.head])[0]-2-args.num_relations)
        #关系类型编号
        r.append(args.num_relations*2)
        #非原子关系
        is_atomic.append(0)

        #事实子图的起点是事实
        s.append(hyperedge+args.num_entities+args.num_relations)
        #事实子图的终点为关系
        t.append(vocabulary.convert_tokens_to_ids([example.relation])[0]-2+args.num_entities)
        r.append(args.num_relations*2+1)
        is_atomic.append(0)

        #事实子图的起点是事实
        s.append(hyperedge+args.num_entities+args.num_relations)
        #事实子图的起点是尾实体
        t.append(vocabulary.convert_tokens_to_ids([example.tail])[0]-2-args.num_relations)
        r.append(args.num_relations*2+2)
        is_atomic.append(0)

        #把原始三元组加入到图中
        s.append(vocabulary.convert_tokens_to_ids([example.head])[0]-2-args.num_relations)
        t.append(vocabulary.convert_tokens_to_ids([example.tail])[0]-2-args.num_relations)
        r.append(vocabulary.convert_tokens_to_ids([example.relation])[0]-2)
        is_atomic.append(1)
④ 处理超关系,将正向超关系加入图中
#处理超关系
if example.auxiliary_info:
    for k,v in example.auxiliary_info.items():
        k_id = vocabulary.convert_tokens_to_ids([k])[0]-2
        v_id = vocabulary.convert_tokens_to_ids(v)
        for i in range(len(v)):
            s_gat.append(hyperedge+args.num_entities+args.num_relations)
            t_gat.append(v_id[i]-2-args.num_relations)
            for i in range(len(v)):
                s.append(hyperedge+args.num_entities+args.num_relations)
                t.append(v_id[i]-2-args.num_relations)
                r.append(k_id)
                is_atomic.append(0)
处理完后,得到的每一个实例对应的的列表包含如下元素:
- s_gat:当前处理的事实新索引,每一轮只有一个值
- t_gat:当前处理的事实的 头实体、为实体、关系,以及超关系的值的新索引
- s :一张HiDR图中所有头实体的新编号,包含fact,三元组原本的头实体
- t:一张HiDR图中所有尾实体的新编号,包含实体,关系,value,三元组原本的尾实体
- r:一张HiDR图中所有关系类型的新编号,包含三种新关系,key,三元组原本的关系
- is_atomic:该关系是否为原子关系,即是否存在原来的知识图谱中的关系
\((s[i],t[i],r[i],is\_atomic[i])\)代表HiDR图中的一条边。
⑤ 处理逆关系,逻辑和正关系一致,只不过首尾互换位置
⑥ 生成两个dgl图,一个是无关系类型图,一个是带信息的图
#无关系类型图 用于GAT 自己学习注意力
graph_gat = dgl.graph((s_gat, t_gat), num_nodes=selected+args.num_entities+args.num_relations)
#带信息的图 适合关系感知
graph = dgl.graph((s, t), num_nodes=selected+args.num_entities+args.num_relations)
node_norm = comp_deg_norm(graph, -1)
edge_norm = node_norm_to_edge_norm(graph,node_norm)
return torch.tensor(triple_train), graph_gat.to(device), graph.to(device), torch.tensor(r), torch.tensor(edge_norm), selected, torch.tensor(is_atomic)

#给每个节点算归一化权重
def comp_deg_norm(graph, power=-1):
    graph = graph.local_var()
    print(f'graph_num_nodes:{graph.number_of_nodes()}')
    print(f'graph_num_edges:{graph.number_of_edges()}')

    in_deg = graph.in_degrees(range(graph.number_of_nodes())).float().numpy()
    norm = in_deg.__pow__(power)
    norm[np.isinf(norm)] = 0
    return torch.from_numpy(norm)

#将每个节点计算得到的归一化权重挂到对应节点上
def node_norm_to_edge_norm(graph, node_norm):
    graph.ndata['norm'] = node_norm
    graph.apply_edges(lambda edges: {'norm': edges.dst['norm'] * edges.src['norm']})
    norm = graph.edata.pop('norm').squeeze()
    return norm
最后返回:
- triple_train:训练事实的编号/三元组信息
- graph_gat:GAT图
- graph:普通消息传播图
- r:边的关系类型
- edge_norm:每条边的归一化权重
- selected:fact节点数量
- is_atomic:是否原子事实标记
返回出口graph.py->run.py
主程序开始定义模型Transformer,代码如下:
调用入口run.py -> transfomer.py
model = Transformer(args.nest_meta,args.dataset,is_atomic,triple_train, graph_gat, graph, r, edge_norm, selected, args.num_entities, args.num_relations, args.vocab_size, args.local_layers, args.global_layers, args.hidden_dim, args.local_heads, args.global_heads, args.use_global, args.local_dropout, args.global_dropout, args.decoder_activation, args.global_activation, args.use_edge, args.remove_mask, args.use_node, emb_time).to(device)需要传递的参数可以分为4大类:数据相关、模型结构、控制开关、时间建模。
Transformer模块包含如下参数:
- local_layers:Transformer层数
- hidden_dim:隐藏层维度
- local_heads:多头注意力头数
- local_dropout:失活率
- decoder_activation:激活函数
一个带[MASK]的fact序列进入解码器,每个token都会被表示成一个向量,hidden_dim决定了这个向量的长度,也就是token的表达能力。如,有一个句子有七个token,那么每个token都会变成(1,hidden_dim)维度,最后得到的输入矩阵维度为(7,hidden_dim)。
随后输入矩阵一起做线性变化,同时得到每个token的Q,K,V。Q 代表我要找什么样的信息,K 代表我能提供什么样的信息,V 代表我能提供的信息。多头注意力指的是有多少个注意力头,即投影到多少子空间。每个子空间通过该空间的Q,K,V得到attention输出。每个注意力头注意到的东西都不同,最后通过拼接,形成每个token的attention输出。
local_layers为Transformer的层数,决定上述的操作需要进行几次。
GNN模块包含如下参数:
- global_layers:GNN层数,执行多少次
- global_heads:GAT头数,类似Transformer的多头注意力机制
- global_dropout:失活率
- global_activation:激活函数
消融实验模块包含如下参数:
- use_gloabal:是否使用GNN
- use_edge:是否使用边信息
- use_node:是否在局部 Transformer 的 attention 投影中区分节点/位置角色信息
- remove_mask:控制局部 attention 中某些 mask 约束是否移除
其余模块包含如下参数:
- nest_meta:NKG中是否将事实作为可预测部分
- emb_time:TKG的时间数值
Transformer结构如下
 def __init__(self, nest_meta, dataset, is_atomic, triple_train, graph_gat, graph, r, edge_norm, selected,ent_num: int,rel_num: int, vocab_size: int, local_layers: int, global_layers: int, hidden_dim: int,
local_heads: int, global_heads: int, use_global: bool, local_dropout: float, global_dropout: float,
  decoder_activation: str, global_activation: str, use_edge: bool, remove_mask: bool, use_node: bool, emb_time, bias=True, times=2) -> None:
        super().__init__()
        #参数 判断事实是否能作为预测项
        self.nest_meta = nest_meta
        #token维度
        self.hidden_dim = hidden_dim
        #transformer的层数
        self.layers = nn.ModuleList()
        for _ in range(local_layers):
            self.layers.append(TransformerLayer(hidden_dim, local_heads, local_dropout, decoder_activation, use_edge, remove_mask, use_node, bias, times=times))
        #输入层
        self.input_norm = nn.LayerNorm(hidden_dim)
        self.input_dropout = nn.Dropout(p=local_dropout)
        #输出层
        self.output_norm = nn.LayerNorm(hidden_dim)
        #输出激活函数
        self.output_act = nn.GELU()
        self.output_linear = nn.Linear(hidden_dim, hidden_dim)
        #偏置
        self.output_bias = torch.nn.parameter.Parameter(torch.zeros(vocab_size))
        #查表操作,取其中一行
        self.edge_query_embedding = nn.Embedding(14, hidden_dim // local_heads, padding_idx=0)
        self.edge_key_embedding = nn.Embedding(14, hidden_dim // local_heads, padding_idx=0)
        self.edge_value_embedding = nn.Embedding(14, hidden_dim // local_heads, padding_idx=0)
        self.init_params()
        #GNN层
        self.globl = Global(emb_time, nest_meta, vocab_size, dataset, is_atomic, triple_train, graph_gat, graph, r, edge_norm, selected, ent_num, rel_num, hidden_dim, use_global, global_layers, global_heads, global_dropout, global_activation)
调用入口Transformer() -> Transformerlayer()
for循环定义了Transformer解码器的层数,每一层均添加一个Transformerlayer,消融实验主要在该层进行,Transformerlayer层如下:
class TransformerLayer(nn.Module):
    def __init__(self, hidden_dim: int, heads: int, dropout_prob: float, activation: str, use_edge: bool, remove_mask: bool, use_node: bool, bias=True, times=2) -> None:
        super().__init__()
        self.norm_attention = nn.LayerNorm(hidden_dim)
        self.attention = MultiHeadAttention(hidden_dim, heads, dropout_prob, use_edge, remove_mask, bias, use_node)
        self.dropout = nn.Dropout(dropout_prob)
        self.norm_ffn = nn.LayerNorm(hidden_dim)
        self.ffn = FeedForward(hidden_dim, hidden_dim * times, hidden_dim, activation)
调用入口Transformerlayer() -> MultiHeadAttention()
每层Transformerlayer均有一层MultiHeadAttention多头注意力层,多头注意力层如下:
class MultiHeadAttention(nn.Module):
    def __init__(self, hidden_dim: int, heads: int, dropout_prob: float, use_edge: bool, remove_mask: bool, bias: bool, use_node: bool) -> None:
        super().__init__()
        #判断维度是否能除尽头数
        assert hidden_dim % heads == 0
        #每一头的维度
        self.dim = hidden_dim // heads
        #头数
        self.heads = heads
        #获取q,k,v矩阵
        self.query = PrepareForMultiHeadAttention(hidden_dim, heads, bias, use_node)
        self.key = PrepareForMultiHeadAttention(hidden_dim, heads, bias, use_node)
        self.value = PrepareForMultiHeadAttention(hidden_dim, heads, True, use_node)
        self.pos = PrepareForMultiHeadAttention(hidden_dim, heads, True, use_node)
        #softmax层
        self.softmax = nn.Softmax(dim=-1)
        self.output = nn.Linear(hidden_dim, hidden_dim)
        self.dropout = nn.Dropout(p=dropout_prob)
        #消融实验
        self.use_edge = use_edge
        self.remove_mask = remove_mask
        self.scale = 1 / math.sqrt(self.dim)
        # trasformer-xl
        self.r_w_bias = nn.Parameter(torch.Tensor(heads, self.dim)) # u
        self.r_r_bias = nn.Parameter(torch.Tensor(heads, self.dim)) # v
调用入口MultiHeadAeetntion() -> PrepareForMultiHeadAttention()
每层多头注意力层中又有一层PrepareForMultiHeadAttention(),为多头注意力做准备,具体如下:
class PrepareForMultiHeadAttention(nn.Module):
    def __init__(self, hidden_dim: int, heads: int, bias: bool, use_node: bool) -> None:
        super().__init__()
        self.heads = heads
        self.use_node = use_node

        if self.use_node is True:
            #可训练参数为hidden_dim * hidden_dim + hidden_dim个,目的是学习每个token的映射
            #如映射到k空间 q空间 vko
            self.layer_s=nn.Linear(hidden_dim,hidden_dim)
            self.layer_r=nn.Linear(hidden_dim,hidden_dim)
            self.layer_o=nn.Linear(hidden_dim,hidden_dim)
            self.layer_a=nn.Linear(hidden_dim,hidden_dim)
            self.layer_v=nn.Linear(hidden_dim,hidden_dim)
        else:
self.linear = nn.Linear(hidden_dim, hidden_dim, bias=bias)PrepareForMultiHeadAttention()的前向传播流程如下:
def forward(self, x : torch.Tensor):
    #shape为 batch*seq_len*hidden_dim
    shape = x.shape[:-1]

    if self.use_node is False:
        x = self.linear(x)
    else:
        device=x.device
        #0代表batch_size 1代表一条三元组被扩展后的维度 2代表hiddendim
        max_seq_len=x.size(1)
        #主体的掩码
        mask_s = torch.tensor([1]+[0]*(max_seq_len-1)).to(device)
        #关系的掩码
        mask_r = torch.tensor([0,1]+[0]*(max_seq_len-2)).to(device)
        #客体的掩码
        mask_o = torch.tensor([0,0,1]+[0]*(max_seq_len-3)).to(device)
        #key的掩码
        mask_a = torch.tensor([0,0,0]+[1,0]*int(((max_seq_len-3)/2))).to(device)
        #value的掩码
        mask_v = torch.tensor([0,0,0]+[0,1]*int(((max_seq_len-3)/2))).to(device)

        #mask_s[:,none]把实体的掩码变成二维的
        x_s=self.layer_s(torch.mul(x,mask_s[:,None].expand(-1,x.size(-1))))
        x_r=self.layer_r(torch.mul(x,mask_r[:,None].expand(-1,x.size(-1))))
        x_o=self.layer_o(torch.mul(x,mask_o[:,None].expand(-1,x.size(-1))))
        x_a=self.layer_a(torch.mul(x,mask_a[:,None].expand(-1,x.size(-1))))
        x_v=self.layer_v(torch.mul(x,mask_v[:,None].expand(-1,x.size(-1))))

        x=(x_s+x_r+x_o+x_a+x_v)

        return x.reshape(*shape, self.heads, -1)
如果use_node=False,代表不区分节点类型,所有节点共用一个线性层;如果区分节点类型,则对每个不同类型的实体采用不同的线性层。mask_s[:,none]把实体的掩码变成二维的,从1× max_seq_len变成max_seq_len×1,刚好对应每个token的位置,再利用expand将其扩展为max_seq_len×hidden_dim维度,与原token嵌入逐元素相乘,最后只留下头实体token,其余位置均为0。
对于其它操作同理。不同类型的实体分别进入不同的线性层,将结果相加,便是最后的x。
最后,将x变换成多头注意力所需要的形状,与多头注意力的头数有关。例如,最开始的输入为[24,7,256],头数为4,那么最后的输出将会变成[24,7,4,64],这代表在最开始:
- batch_size = 24,即有24条数据
- max_seq_len=7,代表每一个三元组都会被扩展为7个token
- hidden_dim=256,代表每个token维度为256
但是最后需要把一个256维度的token分为4个64维度的token用于多头注意力机制。
至此PrepareForMultiHeadAttention()传播完毕。
返回出口 PrepareForMultiHeadAttention() -> MultiHeadAttention()
返回MultiHeadAttention(),该模型中还有一个getmask()方法,具体如下:
def get_mask(self, graph: torch.Tensor):
    return graph.unsqueeze(1).repeat(1, self.heads, 1, 1)
该方法将图信息扩展到多头,如果两个实体之间有关系,在图中对应位置置为1,否则为0。
该方法最后返回的是一个大小为[batch_size,head,max_seq_len,max_seq_len]的扩展图。
MultiHeadAttention()的前向传播流程如下
在该层中,query,key,value的输入均为相同的X,大小均为[batch_size,max_seq_len,hidden_dim]。
前向传播过程中,首先调用query(query),key(key),value(value)获得每个token在每个注意力头空间下的q,k,v矩阵:
#如果使用边的信息
 def forward(self, *, query: torch.Tensor, key: torch.Tensor, value: torch.Tensor,
         graph: torch.Tensor, edge_key: torch.Tensor, edge_value: torch.Tensor, edge_query: torch.Tensor):
        # query/key/value: (batch, seq_len, hidden_dim)
        # graph: (batch, kinds, query, key)
        #shape是批次大小 * max_seq_len
        shape = query.shape[:-1]
        #获得q
        query = self.query(query)   # (batch, seq_len, head, hidden)
        #获得k
        key = self.key(key)         # (batch, seq_len, head, hidden)
        #获得v
        value = self.value(value)   # (batch, seq_len, head, hidden)
        #seq_len为扩展后的最大token长度
seq_len = query.size(1)如果在进行多头注意力的过程中不使用边的信息,那么做的就是普通的Transformer:
#不使用边的信息
 else:
        #得到不同token的注意力分数
        scores = torch.einsum("bqhd,bkhd->bhqk", query, key)
        #将得分进行缩小,防止数值过大使softmaxs失效
        scores *= self.scale
        #获得head份mask信息
        mask = self.get_mask(graph)
        #消融开关
        if self.remove_mask is True:
            for i in range(3,seq_len,2):
                if i==3:
                    mask[:,:,i:(i+2),(i+2):]=False
                elif i==(seq_len-2):
                    mask[:,:,i:(i+2),3:i]=False
                else:
                    mask[:,:,i:(i+2),(i+2):]=False
                    mask[:,:,i:(i+2),3:i]=False
         scores = scores.masked_fill(mask == 0, -100000)
         attn = self.softmax(scores)
         attn = self.dropout(attn)
         x = torch.einsum("bhqk,bkhd->bqhd", attn, value)
x = x.reshape(*shape, -1)torch.einsum()在做点积,输入的query和key的维度均为[batch_size,max_seq_len,head,dim],做点积后输出的维度应该为[batch_size,head,max_seq_len,max_seq_len],输出的结果为不同token之间的注意力分数。类似于: \[ Scores = Q·K^T \] 如果remove_mask = True,那么不同键值对间的关系将置为False,代表不同键值对之间将互不可见。
三个分支代表含义为:
- 如果\(i=3\),说明其为第一个键值对,那么它将无法看到所有其之后的键值对
- 如果\(i=seq\_len-2\),说明其为最后一个键值对,那么它将无法看到所有其之前的键值对
- 其余情况则设置为,既不能看见之前的键值对,也不能看见之后的键值对
scores将不可见的位置设置为-100000,对最后一维经过softmax后,不可见位置将几乎不会影响attention分数。
scores维度为[batch_size,head,max_seq_len,max_seq_len],对最后一维进行softmax,指的就是在某条数据的某个注意力块中,每个token和其它token的注意力权重。
得到权重后,再做一次内积,每个token得到的就是带有对其它token注意力的新的嵌入。
如果使用边信息,在计算注意力得分的时候将会把边的结构也一起考虑进去:
if self.use_edge is True:
    #将边的结构一起考虑进去
    scores = torch.einsum("bqhd,bkhd->bhqk", query, key) + torch.einsum("bqhd,bqkd->bhqk", query, edge_key) + torch.einsum("bkqd,bkhd->bhqk", edge_query, key) + torch.einsum("bkqd,bqkd->bqk", edge_query, edge_key).unsqueeze(1)
    scores = scores * self.scale
    mask = self.get_mask(graph)
    if self.remove_mask is True:
        for i in range(3,seq_len,2):
            if i==3:
                mask[:,:,i:(i+2),(i+2):]=False
            elif i==(seq_len-2):
                    mask[:,:,i:(i+2),3:i]=False
            else:
                    mask[:,:,i:(i+2),(i+2):]=False
                    mask[:,:,i:(i+2),3:i]=False
    scores = scores.masked_fill(mask == 0, -100000)
    attn = self.softmax(scores)
    attn = self.dropout(attn)
    x = torch.einsum("bhqk,bkhd->bqhd", attn, value) + torch.einsum("bhqk,bqkd->bqhd", attn, edge_value)
    x = x.reshape(*shape, -1)
具体的四个得分含义如下:
- query,key:普通的token之间的注意力权重
- query,edge_key:token到对应token的边的类型的权重
- edge_query,key:让边关系本身也参与判断,判断是否该边是否应该关注对应的token
- edge_query,edge_key:边和边之间的匹配程度
最后在更新x时,x不但带有各token之间经注意力权重加权后的信息,还带有边结构信息。
返回出口MultiHeadAttention() -> Transformerlayer()
回到Transformerlayer,此时完成了多头注意力的聚合嵌入,该模块的前向传播方法如下:
def forward(self, x: torch.Tensor, graph: torch.Tensor, edge_key: torch.Tensor, edge_value: torch.Tensor, edge_query: torch.Tensor):
    attn = self.attention(query=x, key=x, value=x, graph=graph, edge_key=edge_key, edge_value=edge_value, edge_query=edge_query)
    x = self.norm_attention(x + self.dropout(attn))
    ff = self.ffn(x)
    x = self.norm_ffn(x + self.dropout(ff))
return xattn得到嵌入,经过残差+归一化后得到新的X,将新的X进行前向传播后,再进行一次残差+归一化,得到该层的X。
返回出口Transformerlayer() -> Transformer()
Transformer()中还有还有一层Global()用来更新全局嵌入。
调用入口Transformer() -> Global()
Global()的初始化如下:
class Global(nn.Module):
    def __init__(self, emb_time, nest_meta, vocab_size, dataset, is_atomic, triple_train, graph_gat, graph, r, edge_norm, selected, ent_num, rel_num, dim, use_global, num_layers, heads, dropout, activation):
        #控制NKG是否将事实当作可预测结果的元素
        self.nest_meta = nest_meta
        #词汇表大小
        self.vocab_size = vocab_size
        #训练三元组
        self.triple_train = triple_train
        #给GAT用的图
        self.graph_gat = graph_gat
        #给compGCN用的图
        self.graph = graph
        #token的维度
        self.dim = dim
        #每条边的类型
        self.edge_type = r
        #边的归一化系数
        self.edge_norm = edge_norm
        self.dataset = dataset
        #边是不是atomic
        self.is_atomic = is_atomic
		#用到的事实数量
        self.selected = selected
        #TKG中的纯实体数量
        self.ent_num = ent_num
        #关系数量
        self.rel_num = rel_num
        self.emb_time = emb_time
        super(Global, self).__init__()
        self.layers0 = nn.ModuleList()
        self.layers1 = nn.ModuleList()
        #构建num_layers 图传播层 每层都由一层GAT和一层CompGCN组成
        #GAT负责聚合邻居节点信息,将邻居信息加权聚合
        #CompGC负责将关系信息加入传播 同时更新关系嵌入
        for _ in range(num_layers):
            self.layers0.append(GATv2Conv(dim, dim // heads, num_heads=heads,allow_zero_in_degree=True, feat_drop=dropout))
            self.layers1.append(CompGCNCov(dim, dim, torch.tanh, bias = 'False', drop_rate = dropout, opn = 'corr',ent_num = self.ent_num,rel_num=self.rel_num))
self.num_layers = num_layers先初始化基本的参数,每一层GNN都由一层GAT和一层CompGCN组成:
- GAT是不带信息的图,仅仅自己捕捉邻居之间的关系,将邻居信息加权聚合。
- CompGCN则将关系信息加入传播,同时更新关系的嵌入
初始化定义关系节点信息和转换矩阵权重:
#初始化节点构造参数
#关系节点嵌入
self.rel_node_emb = nn.Parameter(torch.Tensor(dim, dim))
nn.init.normal_(self.rel_node_emb, mean=0, std=0.02)
self.W1 = nn.Parameter(torch.Tensor(dim, dim))
nn.init.normal_(self.W1, mean=0, std=0.02)
self.W2 = nn.Parameter(torch.Tensor(dim, dim))
nn.init.normal_(self.W2, mean=0, std=0.02)
self.W3 = nn.Parameter(torch.Tensor(dim, dim))
nn.init.normal_(self.W3, mean=0, std=0.02)

self.special_embedding = nn.parameter.Parameter(torch.Tensor(2, dim))
nn.init.normal_(self.special_embedding, mean=0, std=0.02)
如果处理的是时序知识图谱,则还需要额外对时间轴进行处理:
## temporal
if emb_time != None:
        self.num_time = emb_time.shape[0]
        # 计算最小值和最大值
        min_val = emb_time.min(dim=0, keepdim=True).values
        max_val = emb_time.max(dim=0, keepdim=True).values
        # 执行最小-最大归一化
        self.emb_time = (emb_time - min_val) / (max_val - min_val + 1e-6)  # 加上一个小常数以避免除零

        self.t1 = nn.Linear(in_features=1, out_features=dim)
        self.t2 = nn.Linear(in_features=1, out_features=dim)
        self.t1_weight = nn.Parameter(torch.randn(1))
        self.t2_weight = nn.Parameter(torch.randn(1))
    else:
self.num_time = 0 对每个时间进行归一化。t1,t2负责将时间变成一个dim维度的向量,t1_weight,t_weight,则是两个时间权重。
如果允许将事实作为预测结果,那么实体的嵌入将被冻结,不再更新,模型转而学习结构信息;如果不允许事实作为预测结果,那么将允许更新实体的嵌入:
if not nest_meta:
    	#更新实体的嵌入,但是TKG里时间实体单独建模
        self.ent_embedding = nn.parameter.Parameter(torch.Tensor(ent_num-self.num_time, dim))
        nn.init.normal_(self.ent_embedding, mean=0, std=0.02)
        self.rel_embedding = nn.parameter.Parameter(torch.Tensor(rel_num*2+6, dim))
        nn.init.normal_(self.rel_embedding, mean=0, std=0.02)
    else:
        #如果是TKG,将时间一并加入,不更新嵌入,学习整体的结构
        self.ent_embedding = nn.parameter.Parameter(torch.Tensor(ent_num, dim),requires_grad=False)
        nn.init.normal_(self.ent_embedding, mean=0, std=0.02)
        self.rel_embedding = nn.parameter.Parameter(torch.Tensor(rel_num*2+6, dim))
        nn.init.normal_(self.rel_embedding, mean=0, std=0.02)
事实的嵌入由三个头实体、尾实体、关系分别经过线性变化后求和得来,等价于论文提到的拼接后经过一层多层感知机:
def get_fact_emb(self, triple_train, rel_emb, ent_emb):
    # triple_train #[num_selected,3]
    fact_emb = []
    sub_emb = ent_emb[triple_train[:,0]]
    r_emb   = rel_emb[triple_train[:,1]]
    obj_emb = ent_emb[triple_train[:,2]] # [num_selected,dim]
    fact_emb = torch.matmul(sub_emb,self.W1) + torch.matmul(r_emb,self.W2) + torch.matmul(obj_emb,self.W3) # [num_selected,dim]
return fact_embGlobal()的前向传播流程如下:
def forward(self):
    #处理实体,如果有时间实体额外处理
    if self.emb_time != None:
        emb_time = torch.sin(self.t1_weight * self.t1(self.emb_time)) + self.t2_weight * self.t2(self.emb_time)
        ent_embedding = torch.cat((self.ent_embedding,emb_time),dim=0)
    else:
        ent_embedding = self.ent_embedding
     #处理关系
    rel_embedding = self.rel_embedding.to(ent_embedding.device)
     #如果开启了全局图学习
    if self.use_global is True:
          #把关系嵌入变成关系节点嵌入
         x_r = torch.matmul(self.rel_embedding,self.rel_node_emb) # [num_rel*2,dim]
         #x_r = self.rel_embedding
         #得到事实嵌入
         fact_emb = self.get_fact_emb(self.triple_train,x_r,self.ent_embedding)
         #fact_emb = torch.zeros(self.triple_train.shape[0], self.dim).to(ent_embedding.device)
         #获得所有实体嵌入
         ent_embedding = torch.cat((ent_embedding, x_r[:self.rel_num], fact_emb), dim = 0)  # embedding of entities
         #每一层GNN做两次传递
         for i in range(self.num_layers):
         	tmp = self.layers0[i](self.graph_gat, ent_embedding).reshape(ent_embedding.shape[0], -1)
            tmp = self.activate(tmp)
            ent_embedding = ent_embedding + tmp
            tmp1, tmp2 = self.layers1[i](self.graph, ent_embedding, rel_embedding, self.edge_type, self.edge_norm, self.is_atomic)
            tmp1 = self.activate(tmp1)
            tmp2 = self.activate(tmp2)
            ent_embedding = ent_embedding + tmp1
            rel_embedding = rel_embedding + tmp2
     if self.dataset not in ["FBHE","FBH","DBHE"]:
         return torch.cat([self.special_embedding, rel_embedding[:self.rel_num], ent_embedding[:self.ent_num]], dim=0)
     elif self.nest_meta:
         return torch.cat([self.special_embedding, rel_embedding[:self.rel_num], ent_embedding[:self.ent_num], ent_embedding[self.ent_num+self.rel_num:]], dim=0)
     else:
return torch.cat([self.special_embedding, rel_embedding[:self.rel_num], ent_embedding[:self.ent_num], torch.zeros(self.vocab_size-self.ent_num-self.rel_num-2,self.dim).to(ent_embedding.device)], dim=0)如果该图为TKG,则先使用time2vec将时间编码成向量。
如果开启了全局图学习,那么所有的实体嵌入将包括实体嵌入、关系嵌入、事实嵌入。对于每一层GNN,先利用GAT学习实体之间的关系,利用残差更新实体嵌入后,再利用CompGc学习全图结构,利用残差更新实体和关系嵌入,并返回嵌入值。
返回出口Global() -> Transformer()
Transformer()的前向传播流程如下:
def forward(self, input_ids, input_mask, mask_position, mask_output, edge_labels):
    embedding = self.globl().to(input_ids.device)
    x = torch.nn.functional.embedding(input_ids, embedding)
    x = self.input_dropout(self.input_norm(x))
    #不同token之间的关系变成了一个向量
    edge_query = self.edge_query_embedding(edge_labels)
    edge_key = self.edge_key_embedding(edge_labels)
    edge_value = self.edge_value_embedding(edge_labels)

    #解码过程
    for layer in self.layers:
        x = layer(x, input_mask, edge_key, edge_value, edge_query)
    #此时每一个token都包含了对应的上下文,取出掩码位置
    x = x[torch.arange(x.shape[0]), mask_position]
    x = self.output_linear(x)  # x(batch_size, hiddem_dim)
    x = self.output_act(x)
    x = self.output_norm(x)
    y = torch.mm(x, embedding.transpose(0, 1)) + self.output_bias
    y = y.masked_fill(mask_output == 0, -100000)
return y从layer的for循环开始,对应论文里提到的用transformer来找到[MASK]并预测结果,以更新参数。
取出包含图结构信息、上下文信息的[MASK]token,经过线性层,激活函数和归一化后,得到最后预测的结果。
将其与所有候选实体做点积,判断实体之间的相似度,并屏蔽不合法的预测结果,返回预测的分数。
返回出口Transformer.py -> run.py
在主入口完成对模型的训练,测试后,保存模型,整个流程结束。
代码模块对应
论文里提到的构建HiDR图对应到代码的bulid_graph()方法
论文里HiSL的事实内消息传播对应到代码里GNN的GAT层
论文里HiSL的事实间消息传播对应到代码里GNN的CompG层
论文里的链路预测解码器对应到代码里的Transformer,个人理解,这个Transformer起到了让[MASK]学习上下文知识的作用,可以换成其它解码器
\(Fin.\)