- 论文全称:Inductive Reasoning for Temporal Knowledge Graphs with Emerging Entities
- 论文作者:
- 发表信息:ICLR 2026 Poster
- 领域定位:Temporal Knowledge Graph, Inductive Learning
- 代码仓库:仓库链接
论文背景
时序知识图谱可以定义如下:
假设有一条时间轴\(\tau\),沿着时间轴有一系列时间刻度\(t\),对于每个\(t\),都存在由多条三元组构成的知识图谱\(G_t\),由所有\(G_t\)组成的图谱则称作在跨度为\(\tau\)的时序知识图谱。传统的时序知识图谱存在以下问题:真实世界在图谱中被当作是闭合的,即,在进行预测时,会默认测试集的实体在训练的过程中出现过,但是这与真实世界是不符合的。如,当有一个国家选取产生了新的总统,这个总统在时序知识图谱过去的信息中是不存在的,换言之,该实体在训练过程中由于缺乏历史交互监督信号,因此没有得到很好的嵌入表示,导致最后在预测、推理涉及到这些实体的四元组时,传统模型效果会大打折扣。如下例,当奥巴马首次就任美国总统时,由于不存在其历史交互,故预测其第一次国事访问将会边的非常困难,上述提到的实体为本文提出的新兴实体中的一部分。
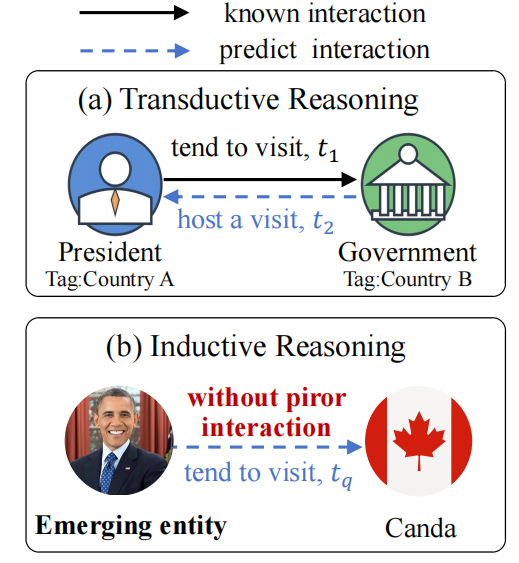
对新兴实体的定义如下:
在时间轴\(\tau\)上的时刻\(t\),如果某个实体\(\epsilon\)在\(t\)时刻之前没有参与任何事件,即,该实体在\(t\)时刻第一次出现,则称\(\epsilon\)为\(t\)时刻的新兴实体。
论文需要解决的问题为:当一个实体为新兴实体,即过去不存在与该实体有关的事件,模型应该如何在这种情况下对涉及到的事实进行很好的预测。
作者认为该研究是极其必要的,因为按照定义,时序知识图谱中的新兴实体数量占所有实体数量的比例高达25%。作者提出一个叫做表示坍缩的概念,用于描述不同实体间的向量区分度。表示坍缩的值越低,代表实体之间越不存在区分度;表示坍缩的值越高,代表实体之间越存在区分度。下图代表已见实体和新兴实体经过训练后在向量空间中表示的区分度:
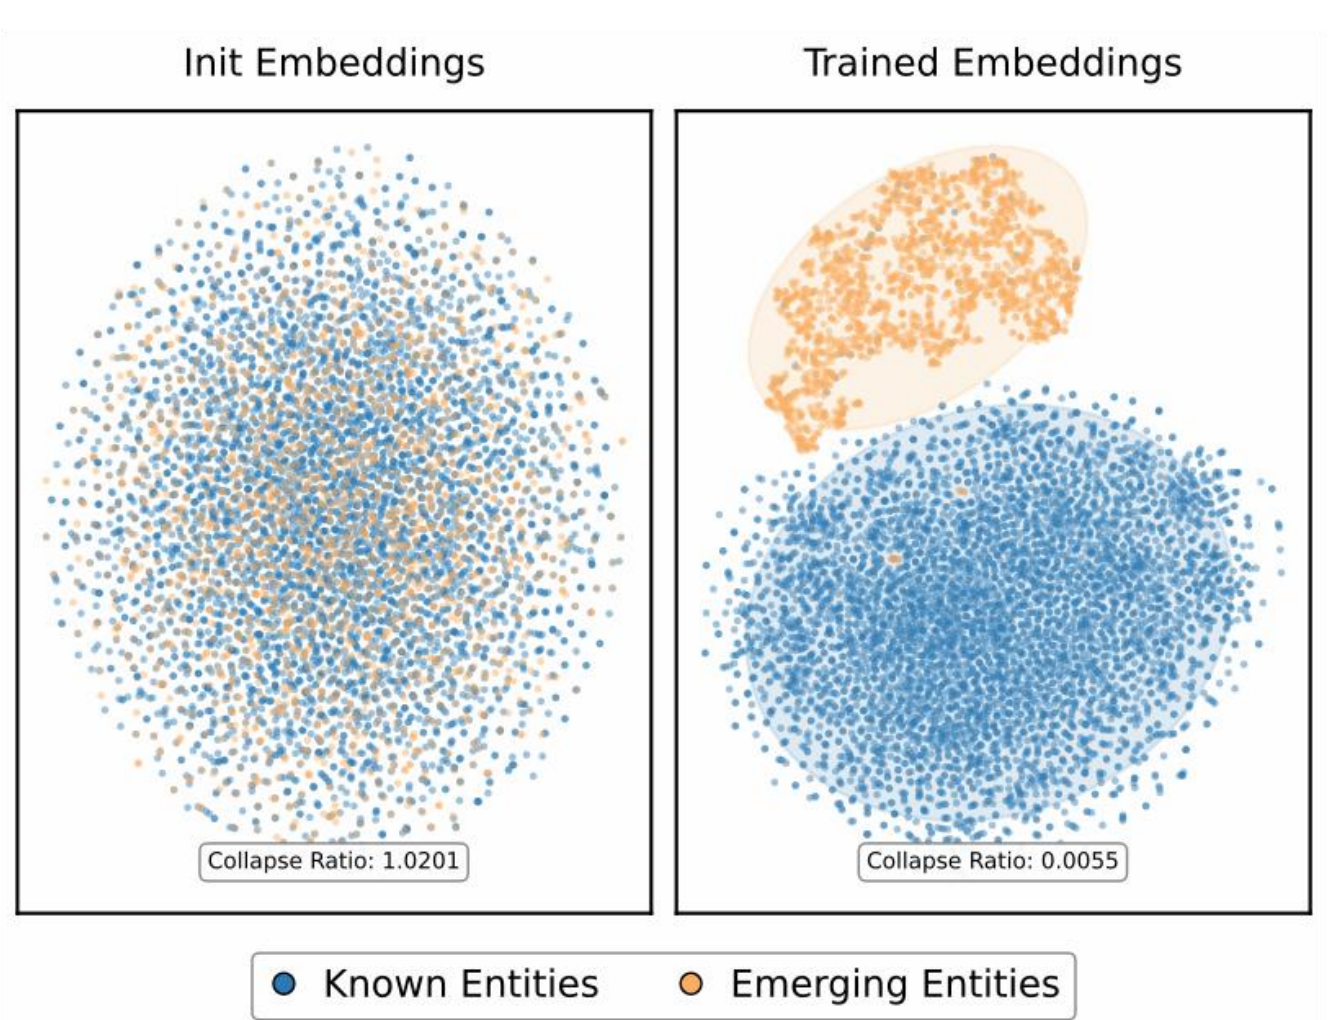
- 对于经过训练的实体,其嵌入在向量空间中往往呈更分散的趋势
- 对于新兴实体,由于缺乏历史交互监督信号,无法对齐进行训练,故其嵌入在向量空间中往往呈更为紧凑的趋势
论文方法
模型总体架构如下:
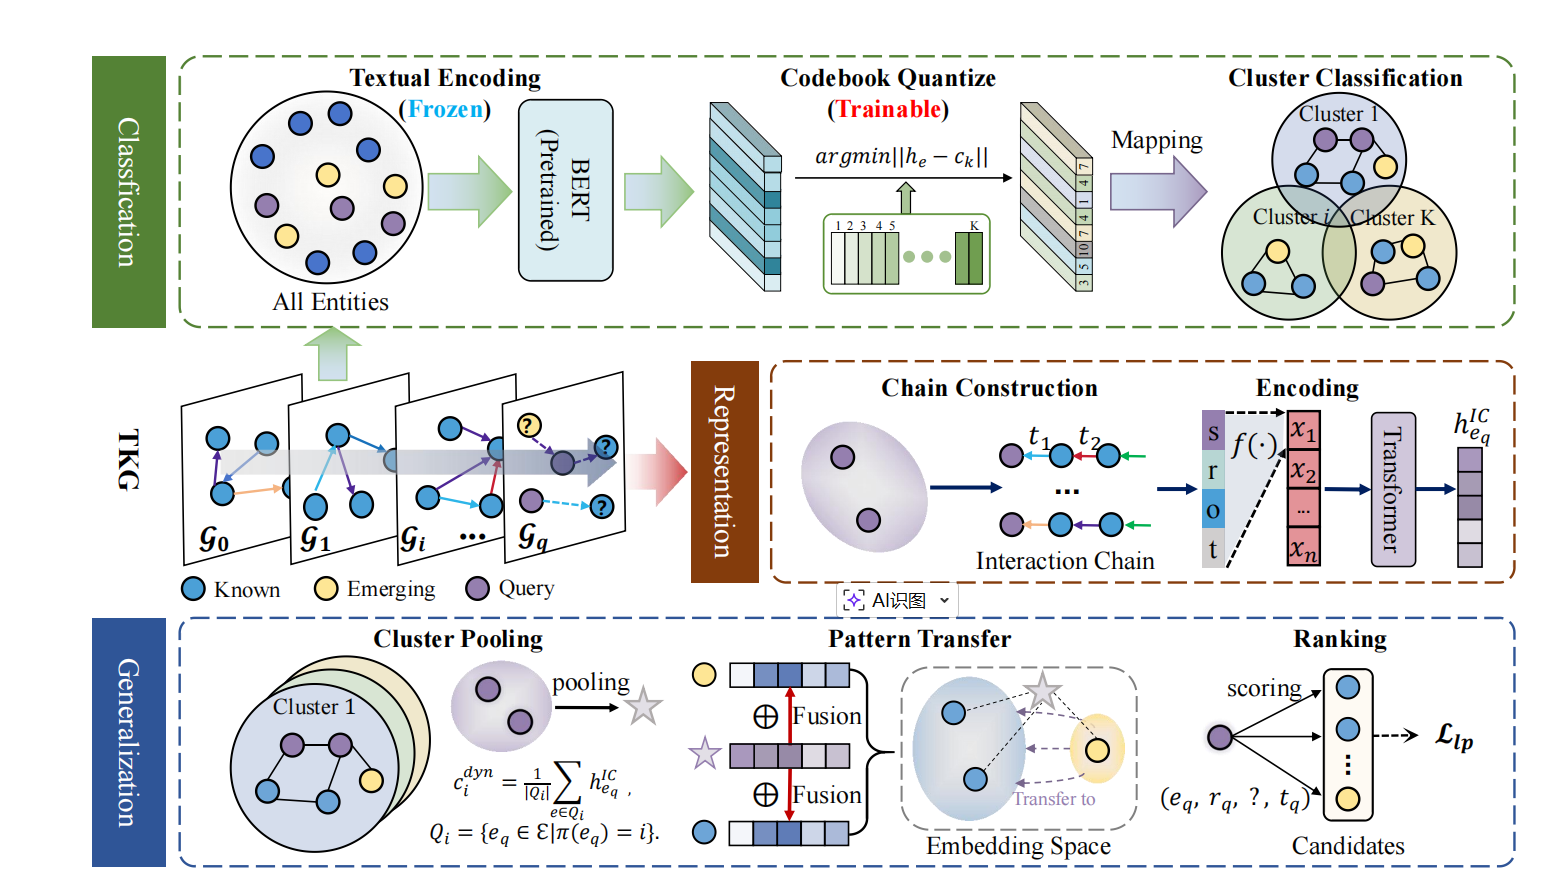
作者提出三个模块:
1)码本映射:将实体映射到对应的簇,每个簇都有一个中心表示向量。损失函数的优化目标在于拉近实体和簇中心表示之间的距离。
2)交互链编码:抽取待预测的query的历史交互链,形成编码。这个编码的作用在于从当前时刻之前抽取和当前时刻待预测四元组中关系相似的事实。编码可以直观理解为,在面对类似的事实时,实体过去是怎么做的。再将这些编码在簇内做平均,最后得到的编码可以类似理解为,在面对不同事实时,这个簇是怎么做的。
3)时序模式迁移:让新兴实体学到每个簇的时序模式,使得新兴实体在没有历史监督信号的前提下获得时序表示
码本映射模块
codebook自动将实体分为k个簇,每个簇都有一个中心嵌入,这个中心嵌入是可学习的。对于每一个实体e,根据下式将其分配到对应的簇中: \[ \pi(e)=argmin_k||h_e-c_k||{_2^2} \] 对于每一个簇,训练的目的是为了让簇中心和实体之间的向量距离更接近,故分两部分进行优化。
第一部分,固定簇中心的向量,让簇中的实体尽可能靠近簇中心,对应下式: \[ L_{cb}=||sg[h_e]-c_{\pi(e)}||{_2^2} \] 第二部分,固定实体的向量,让簇中心尽可能靠近簇中的各个实体,对应下式: \[ L_{commit}=||h_e-sg[c_{\pi(e)}]||{_2^2} \] 码本映射模块的总损失函数为: \[ L_{codebook}=\alpha L_{cb}+\beta L_{commit} \]
交互链编码模块
对于每一个待查询四元组\(q = (e_q,r_q,?,t_q)\),首先根据四元组中的实体\(e_q\)获得其历史交互链,步骤如下:
① 查询过去T个时间步内,\(e_q\)参与的所有历史事件,无论作为主体或者客体
② 从这些历史事件中选择K个拥有和\(r_q\)最相似的关系的事实,公式如下: \[ C{_q^{(k)}}=TOPK_i(sim(h_{r_q},h_{r_i}),C_q) \] \(C{_q^{(k)}}\)是一系列的四元组。
③ 将这些四元组中的主体、关系、客体、事实发生距今的时间进行拼接,得到每个四元组对应的事实序列。
④ 将事实序列送入Transformer编码器,获得每个事实对交互链的权重,公式如下: \[ \alpha_i=\frac{exp(w^Ttanh(W_hh_i+W_qh_{r_q}))}{\sum_jexp(w^Ttanh(W_hh_j+W_qh_{r_q}))} \] 最后得到的单个待查询四元组的交互链编码如下: \[ h_{eq}^{IC}=\sum_{i=1}^n\alpha_ih_i \]
时序模式迁移模块
这一步主要运用到了迁移学习的思想,对于新兴实体,由于缺乏历史交互监督信号,故无法对齐进行训练,获得很好的表示。尽管每个实体在最开始时会给一个基本的初始嵌入,但该嵌入不足以将新兴实体进行区分。此模块的主要目的就是将富历史的同类实体行为模式迁移到新兴实体,帮助新兴实体获得更好的表示,具体步骤如下:
① 对于每个簇,将每个实体的交互链做平均,得到簇的动态原型,公式如下: \[ c_k^{dyn} = \frac{1}{|Q_k|}\sum_{e\in Q_k}h_e^{IC} \] ② 每一个实体都会将其静态嵌入(由一个bert文本编码器给出)和簇的动态原型链接,得到一个类似于包含簇和实体信息的向量\(Z_e\),公式如下: \[ z_e=[h_e||c_{\pi(e)}^{dyn}] \] ③ 通过一个类似评分器的映射函数\(\Psi(·)\),得到迁移向量,该向量作用类似于反映应该将簇的多少信息迁移到实体的嵌入中,公式如下: \[ w_e=\Psi(z_e),\tilde h_e =h_e+w_e·c_{\pi(e)}^{dyn} \]
评分和优化部分
本文采用了ConvTransE的打分函数,给出对每一个候选四元组的评价,公式如下: \[ \phi(e_q,r_q,e_o,t) = \sigma(f(\tilde h_{e_q},h_{r_q},\tilde h_{e_o})) \] 预测部分的损失函数为: \[ L_{lp}=-\sum^T_{t=1}\sum_{(e_q,r_q,e_o,t_q)\in F_t}\sum_{e\in \epsilon}y_{t_q}^elog\phi(e_q,r_q,e,t) \] 最后的总损失函数为: \[ L = L_{lp}+\lambda L_{codebook} \] 模型的优化目标为每个实体最后的嵌入、迁移向量、codebook的分类能力等相关指标。
论文实验
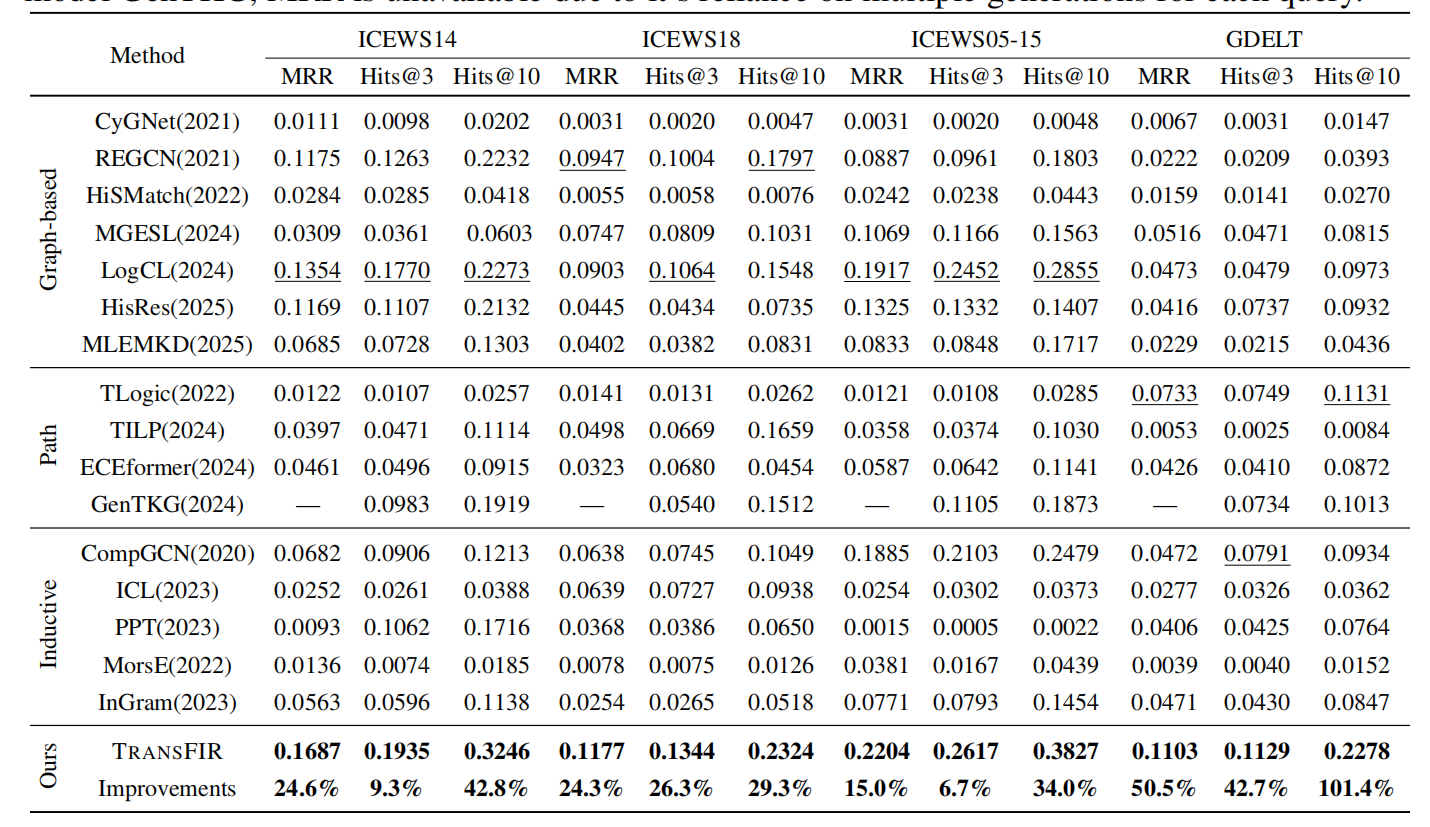
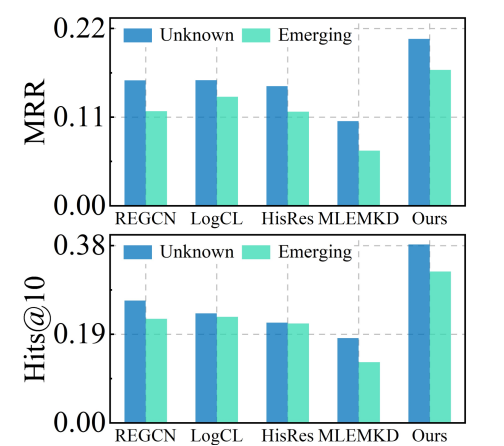
涉及到新兴实体的四元组推理结果如下图所示:
经过训练后,模型的表示坍缩如下图所示:
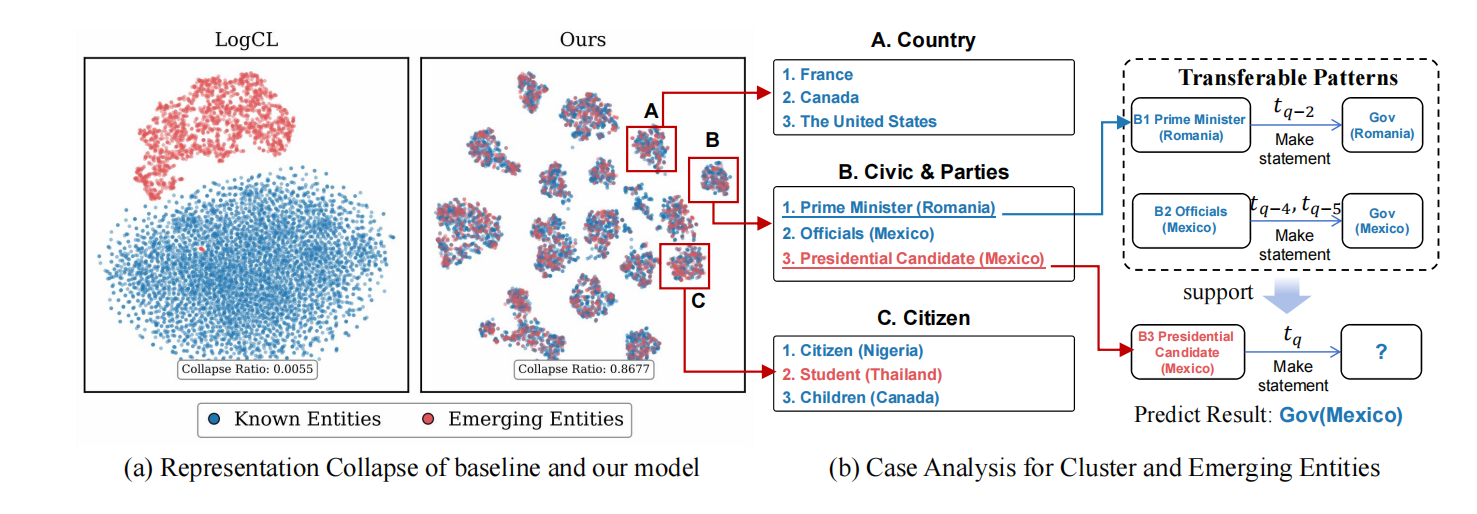
可以发现在向量空间中,不同类型的实体在经过训练后被聚合在了一起,说明达到了分类器要求的让每个簇和簇内实体表示更接近的效果。
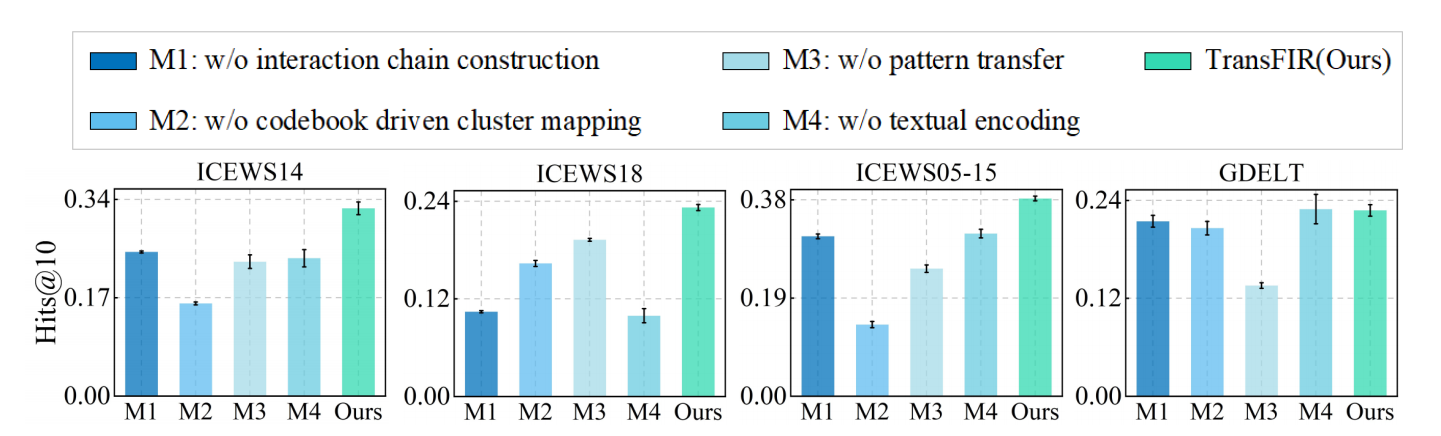
消融实验结果如下图所示:
有些实体可能在训练集中没出现过,在训练集中却多次出现。该类实体从第二次在测试集中出现起,就已经具备了一定的信息,将这类实体定义为未知实体,针对未知实体和新兴实体的实验结果如下图所示:
论文总结
论文提出了一种针对新兴实体的嵌入的方法,通过迁移学习的方式,让新兴实体也能获得一定的语义表示。但是目前论文存在以下缺陷:
论文在进行簇的交互链聚合时,仅仅只是做了一个简单的平均,没有考虑到不同交互链类别的情况。
如:对于某个时刻t,簇A中的实体a对应的query与政治相关,故其根据规则得到的交互链也理应与政治相关;簇内另一个实体b对应的query与娱乐相关,论文中的方法不加区分的进行平均,效果可能不会那么好。
这一部分可以考虑根据实体簇的中心向量加上Transformer判断哪些交互链更应该被保存。
如:簇A对应的是政治任务,那么和政治相关的交互链在嵌入时更应该占大头。
论文目前只对实体进行了分簇,也许可以考虑再针对关系进行分簇。
\(Fin.\)