- 论文全称:DAGE: Decay-Aware Graph Extrapolation for Temporal Knowledge Graph Reasoning
- 论文作者:
- 发表信息:论文发表于 Information Fusion 2026,SCI一区TOP,影响因子15.5
- 领域定位:时序知识图谱、时序衰减、路径式时序知识图谱补全
- 论文PDF:DAGE: decay-aware graph extrapolation for temporal knowledge graph reasoning - ScienceDirect
- 代码仓库:仓库链接
论文背景
时序知识图谱的补全任务可以分为两种分别是内推和外推。
- 内推旨在在已知的时间片段里补全缺失的事实
- 外推旨在通过过去已有的事实预测在未来时刻发生的事实
本文主要聚焦于时序知识图谱补全的外推任务,具体形式如下图所示:
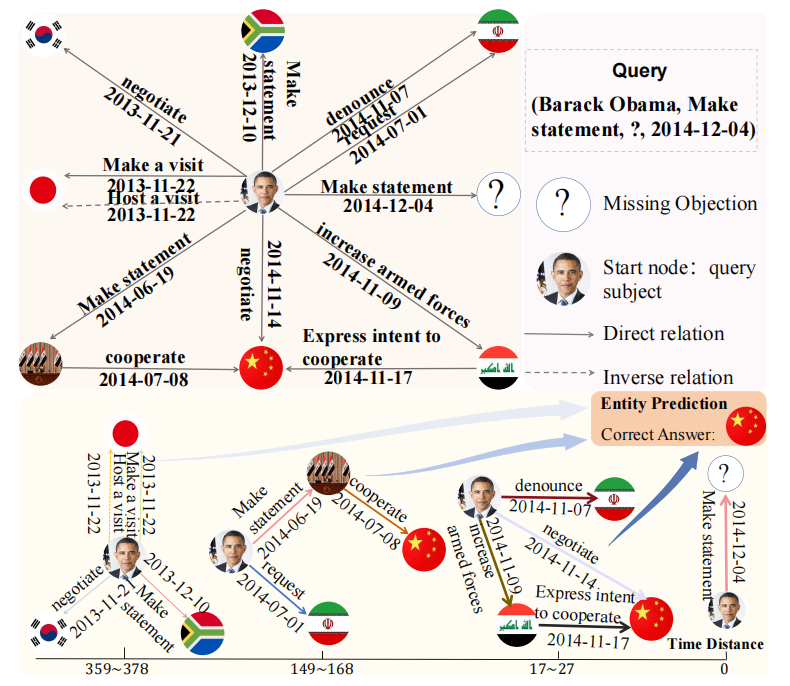
当前Query的事件为(Barack Obama,Make statement,?,2014-12-04)。其中2014-12-04为未来的时间。如时间轴所示,外推任务就是要通过时间轴上过去与当前实体相关的事件,预测在未来该实体可能发生的事件。
针对外推任务,主流的方法有两种,分别是:
- 嵌入式:嵌入式通过动态调整、学习实体和关系的嵌入,使实体在各时刻拥有良好的向量表示,以帮助模型做出正确的预测。该方法擅长捕捉复杂模式,但是其可解释性较差
- 路径式:在过去的时间片段中找到与当前Query中实体相关的事件路径并形成推理链,通过推理链来帮助模型推理、补全未来发生的事件。该方法具有较高透明度,但是未能充分考虑时间带来的影响,即,很久之前发生的事件对模型判断当下事件的发生,极有可能会起到噪声、干扰作用
现有方法要么压根就未考虑时间对关系演变带来的影响;要么就仅仅是对关系简单做了一个处理,将时间信息粗糙的融入进关系中。
基于此,作者提出本论文DAGE方法,本文的贡献可以总结为以下三点:
- 设计了一种层次化时间窗口,该窗口通过构建时间窗口衰减图,以减少冗余的时序路径。同时,通过限制高阶邻居的窗口大小来捕捉时间衰减影响
- 设计一种衰减感知模块来平衡不同时序路径上的事件对待预测事件的影响
- 通过大量的实验说明该方法的可行性
论文方法
模型总体架构
模型总体架构如下图所示:
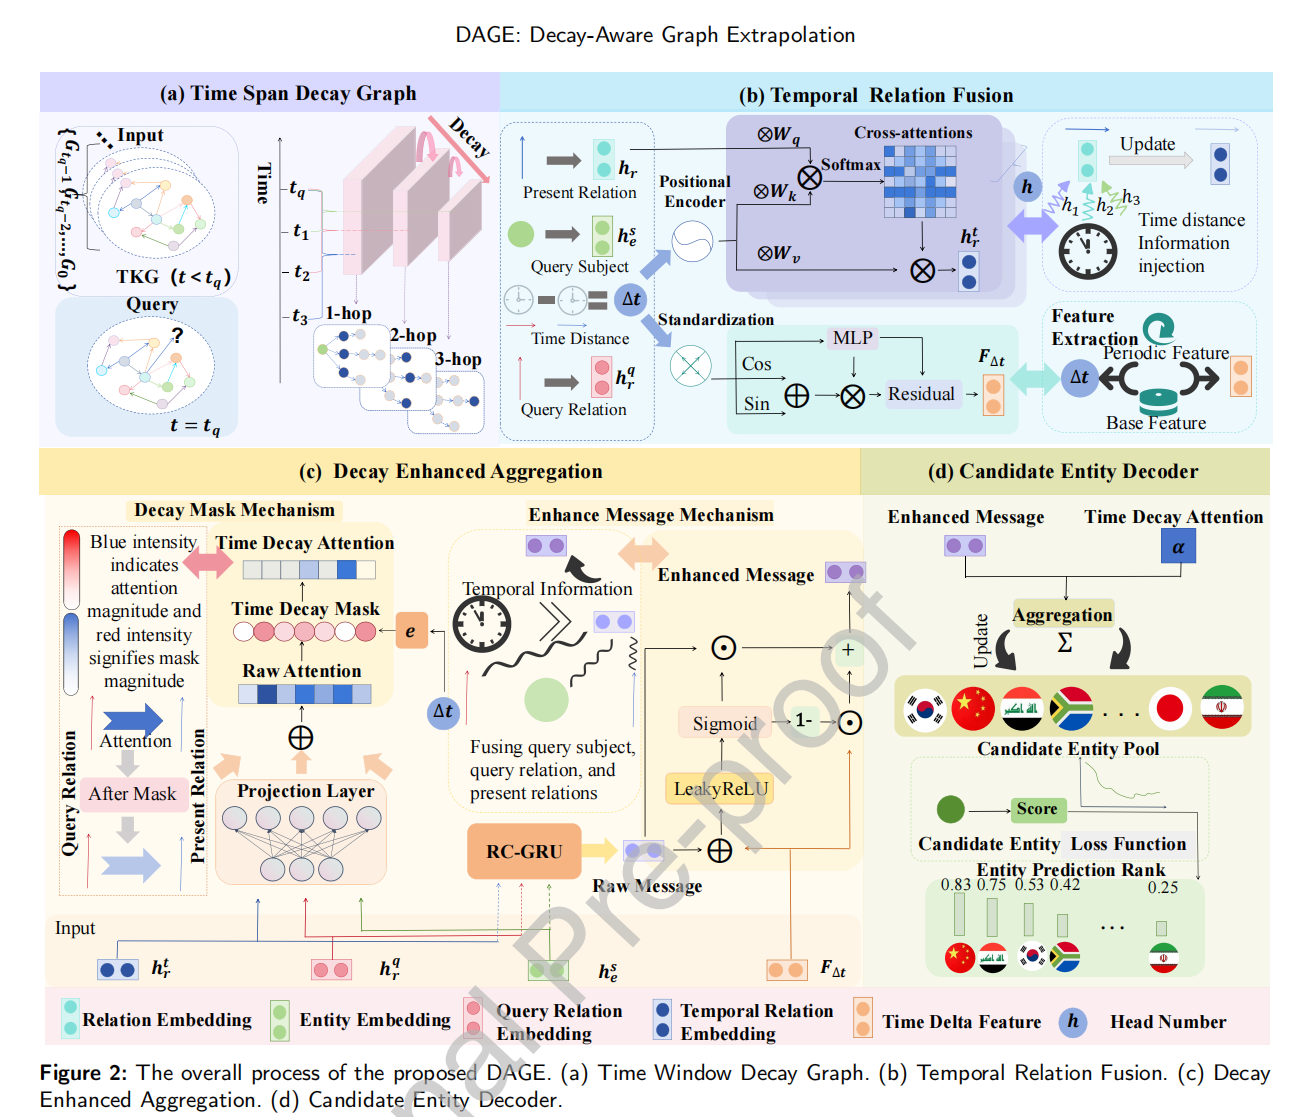
模型分为四个模块,具体对应如下:
- 模块a):生成时间窗口衰减图
- 模块b):进行时序关系融合
- 模块c):进行时序增强结合
- 模块d):候选实体解码
后文一一总结四个模块。
时间窗口衰减图
传统的TR-Directed Graph指的是从头实体出发,按照时间戳的顺序严格构造路径的带有时间和关系层次图。只要路径上的时间是严格的从远到近,那么这条路径就是合法的。但是这会导致某些距离当前时间过于遥远的事件也被同等纳入推理链中,从而影响模型的推理的效果。
本文提出的时间窗口衰减图(TWD-Graph)旨在解决这个问题,具体思想为,不同的层使用不同大小的时间窗口。
假设当前Query为(A,r,?,\(t_q\)),其中,\(t_q\)在所有已知时间之后,TWD-Graph的构建步骤如下所示。
从待查询实体A出发,从过去的所有时序子图(时序范围[\(t_0,t_{q-1}\)])找到所有与A相连的实体,作为TWD-Graph的第二层。
从第二层出发,在一个衰减的时间窗口内,找到所有和第二层实体相连的实体,时序范围为\([t_q-\Delta_l,t_q]\)。其中,\(\Delta_l=\alpha\Delta_{l-1}\),\(\Delta_l\)代表第\(l\)层允许的时间跨度,它有上一层的允许时间跨度乘上时间衰减率\(\alpha\)得来。
直观理解为,层数越高,说明从头实体到当前实体经历了越多的中间实体,这类实体在大跨度时间内找到的事实对当前Query并无太大的意义,故更应该限制其查询事件的时间范围。
\(\alpha\)的作用可以理解为,控制哪些事实可以进入路径中。
- \(\alpha\)越大,高阶窗口收缩越快,更多的事实将出现在合法窗口中,使得路径数量更多、范围更广
- \(\alpha\)越小,高阶窗口收缩越慢,更少的事实将出现在合法窗口中,使得路径数量更少、范围更小
时间关系融合
该模块主要作用是让关系融入时间的特征,同时对时间进行进一步的增强表示,使其获得周期性以及非线性特征。具体分为以下三个步骤:
时间距离指的是每一个事实发生的事件与待查询query的时间之差,具体公式为:\(\Delta t=t_q-t\)
时间距离编码
对每一个时间距离利用正余弦函数进行向量嵌入,使得时间距离在表示上具有周期性,具体公式如下: \[ T=\begin{cases}sin(\Delta t/10000^{j/d_t}),if\ j = 2i,\\cos(\Delta t/10000^{(j-1)/d_t}),if\ j = 2i + 1\end{cases} \] 其中,\(j\)代表嵌入的维度,偶数维度对应公式第一项,奇数维度对应公式第二项。\(d_t\)代表嵌入的时间维度。
动态特征融合
这一步将关系和时间距离融合,使得关系获得带有时间距离信息的表示,具体为,对于每一个初始关系\(r\),在不同的事实中,其发生的时间\(t\)也大概率不相同,因此,其与待查询query的时间\(t_q\)之间的时间距离\(\Delta t\)也大概率不同。初始关系的嵌入为\(h_r\),其时间距离的嵌入为\(T_{\Delta t}\),论文中用到了类似Transformer的思想,由关系嵌入\(h_r\)提供\(Query\),时间距离\(T_{\Delta t}\)提供\(Value、Key\),并利用多头注意力机制,使得关系中融入时间注意力的信息。论文中具体的公式如下:
- 对于每一个注意力头:
\[ head_i=Softmax(\frac{(W_i^rh_r)(W_i^th_t)^T}{\sqrt d_k})·(W_i^vh_t) \]
其中\(d_k\)是注意力头的维度,三个\(W_i\)矩阵类似于将时间和关系投影到对应空间的矩阵。
虽然论文当中用了一个\(Softmax\),但是看原文描述,这个\(h_t\)貌似是唯一的,其指代时间距离的嵌入表示。也就是说,这个公式的前一项只有一个元素,经过\(Softmax\)后值固定为1,真正起到作用的只有后面时间对应的Value项,源码貌似也佐证了这一点,故公式表达可能存在一定的错误。
- 对于更新后的关系: \[ h^t_r=h_r+\frac{1}{h}\sum^h_{i=1}head_i \]
其中\(h_r^t\)为更新后的,带有时间距离信息的关系嵌入表示。
时间-距离特征挖掘
时间不仅仅具有一定的周期性,如:三十天为一个月,三百六十五天为一年,时间还具有一定的非线性关系,如:某个时间有突发事件,会让该时间变得更有意义。故本模块的作用是给不同的时间距离赋予如上特性。针对归一化后的时间距离\(\Delta t^,\)(具体未提到是如何进行归一化的),分别让其具有周期性和非线性特征,具体公式如下:
- 周期性:
\[ t_p = \mu_2\odot[sin(\theta\ \odot\ \mu_0\Delta t^,+\beta)+cos(\theta\ \odot\ \mu_1\Delta t^,+\beta)] \]
- 非线性:
\[ t_b= \sigma_0(\mu_4(\sigma(\mu_3\Delta t^, + b_1)+b_2)) \]
将两个特性得到的嵌入融合,得到最后的时间差嵌入如下: \[ F_{\Delta t}=\lambda(t_b\odot t_p)+(1-\lambda)t_b \]
衰减增强聚合
一个TWD-Graph的结构大致如下图所示:
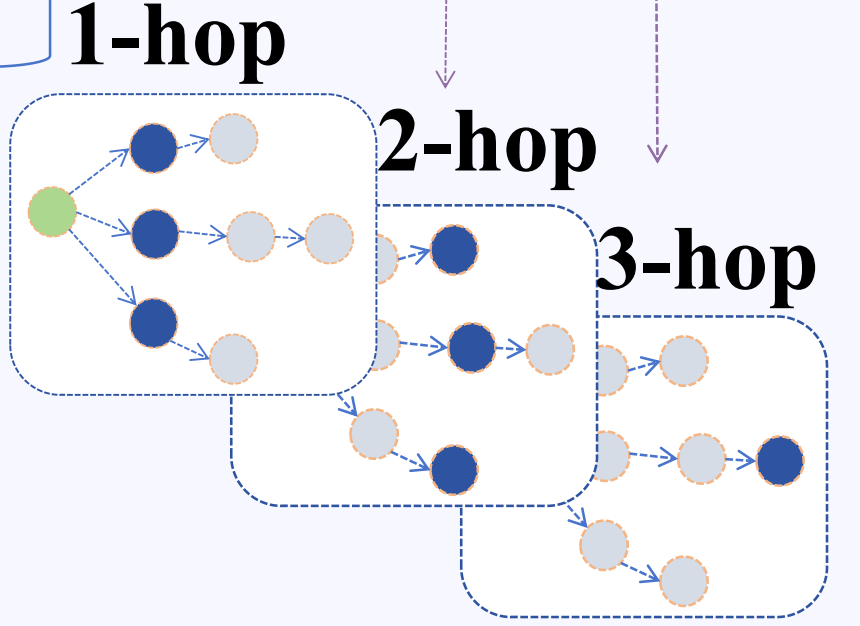
从Query的实体出发,该层记为第一层,衰减增强聚合模块的步骤针对第二层及之后的所有实体。
该模块将信息经过传递,聚合到实体中,以获得实体的嵌入,具体分为四个步骤,分别如下:
消息生成
针对每一层的每一条边,首先构建一个初始消息,\(Z^{l-1}=[h_e^{l-1};h_r^t;h_r^q]\),该消息由上一层实体的嵌入、融合时间的关系嵌入、待查询关系嵌入组成。再利用GRU对消息进行处理,使得消息在传递的过程中能够融入上一层的状态,具体公式如下: \[ g_u^l,g_f^l=\sigma_0(W_u^lZ^{l-1}+b^l_u),\sigma_0(W_f^lZ^{l-1}+b^l_f), \]
\[ h^l_c=\sigma_2(W_c^lh_r^t+g^l_f\odot h_e^{l-1}+b^l_c) \]
其中,\(g_u^l,g_f^l\)分别为更新门和遗忘门,用于控制需要保留多少的信息;\(h_c^l\)为每一层的隐藏状态,由遗忘门控制。
最后每一层传递的消息为: \[ m^l_{raw}=(1-g_u^l)\odot h_c^{l-1}+g_u^l\odot h_c^l \]
消息增强
每一层传递的消息还未能和时间进行进一步的融合,由于关系只考虑到了时间的周期性,而未考虑到时间的非线性等特征,这也导致当前的消息可能只融合了微弱的时间信息,因此,需要进一步对传递的消息融入时间以增强其信息,门控\(g^l_m\)掌握了时间信息和消息结构信息之间的关系,其具体公式如下: \[ g_m^l=\sigma_0(\mu_6\sigma_3(\mu_5[m_{raw}^l;F_{\Delta t}]+b_3)+b_4), \] 增强后的消息嵌入如下: \[ m^l_{enhanced}=g^l_m\odot m^l_{raw} +(1-g_m^l)\odot F_{\Delta t} \] 其中\(\mu_5,\mu_6,b_3,b_4\)为可学习参数。
注意力编码
针对图中的每一个实体\(e_o\),以及其入度边\((e_s,r_t)\),利用图注意力机制计算每一个入度实体对其的贡献,具体公式如下: \[ c^l=\sigma_0(W_4^l\sigma_1(W^l_1h^s_e+W^l_2h^t_r+W^l_3h^q_r)) \] 得到不同实体的贡献后,用\(Softmax\)对贡献进行归一化,具体公式如下: \[ a^l_{raw}=\frac{exp(c^l)}{\sum_{e_s,r_t\in\mathcal{N}(e_o)}exp(c^l)} \] \(\mathcal{N}(e_o)\)为和当前实体相连的所有实体、边的集合,\(W^l_1,W^l_2,W^l_3,W^l_4\)为可学习参数。
衰减掩码
对于每一个实体,加入时序信息后,由于越久以前发生的事对当今的影响可能越小,所以某些消息从结构上看其贡献可能较大,但若考虑时间因素,其影响将会减小。因此,对上一小节得到的注意力分数,还需要再进行衰减掩码的处理,该掩码的作用就是模拟人的近因效应,即,越近发生的事对人的影响越大,门\(g_a^l\)控制原始消息和衰减消息之间的关系,其具体公式如下: \[ g_a^l=\sigma_0(W^l_5 \begin{bmatrix}a^l_{raw}\\e^{-\gamma\Delta t}\end{bmatrix}+b_5) \] 更新后的注意力权重如下: \[ a^l_{masked}=g^l_a.a^l_{raw}+(1-g^l_a).a_{raw}^l.e^{-\gamma\Delta t} \] 其中,\(\gamma\)代表时间距离衰减率,\(e^{-\gamma\Delta t}\)代表时间距离衰减掩码。
候选实体解码
前面的模块获得了每一个候选实体的增强消息\(m^l_{enhanced}\)以及与其相连实体对其的贡献\(a^l_{masked}\)。对于每一个候选实体在第\(l\)层的表示\(h^{l-1}_{e_o}\),其由聚合后的消息以及其在第\(l-1\)层的表示共同经过GRU函数得到。聚合后的消息具体如下: \[ H^l_{e_o}=W^l_6\sum_{e_o,r_t\in\mathcal{N}(e_o)}a^l_{masked}m^l_{enhanced} \] 实体在第\(l\)层的嵌入为: \[ h_{e_o}^{l}=GRU(h^{l-1}_e,\frac{H^l_{e_o}}{\sqrt{i_{e_o}}}) \] 最后候选实体的得分函数为: \[ score(e_0)=W_7h_{e_o}^{l} \] 对于没有出现在图中的实体,其会被模型认为与Query中的实体无关,故得分为0。
同时补充一种论文没提到的情况:论文中提到,候选实体的第\(l\)层嵌入,但是按照论文中的公式,图中的每一个实体都会获得一个嵌入,但是并不是每个实体都会出现在第\(l\)层,即图的最后一层。论文并没有提到这个问题,但是代码的实现方式为,对于任意层的所有实体,其都会有一个自环操作将其连接到下一层,使其最后能够顺利到达第\(l\)层,具体如下: \[ (entity,selfloop,entity) \] 如果某个实体从其首次出现的层开始自环,且在后续的层又出现过一次,那么代码将会进行一个去重的操作,最后只会保留一个该实体的嵌入,去重操作类似于将自环边和正常关系边看作是该实体的两条入度边,并计算传递的消息、增加消息、实体贡献、衰减后贡献,并计算聚合后的消息,通过GRU函数得到其唯一嵌入。
模型的损失函数如下: \[ \mathcal{L}=\sum_o-score(e_o)+log(\sum_{o'}exp(score(e_{o'}))) \] 其中\((e_q,r_q,e_o,t_q)\)代表正向事实,\((e_q,r_q,e_{o'},t_q)\)代表其它事实。损失函数的目的就是让正向事实的得分足够高,让其它事实的得分低。
论文实验
论文实验主要回答六个问题,分别是:
- RQ1:DAGE和其它的知识图谱外推方法比起来表现如何?
- RQ2:消除一些提出的模块对DAGE的影响有多大?
- RQ3:超参数配置是如何影响DAGE的?
- RQ4:DAGE在时间上的泛化能力如何?
- RQ5:DAGE在真实世界中的能力是怎么体现的?
- RQ6:DAGE和其它模型相比,推理效率如何?
RQ1:模型一共在四个数据集上进行实验,数据集信息如下图所示:
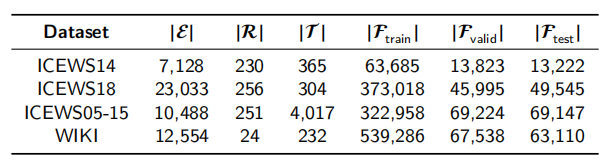
模型的结果如下图所示:
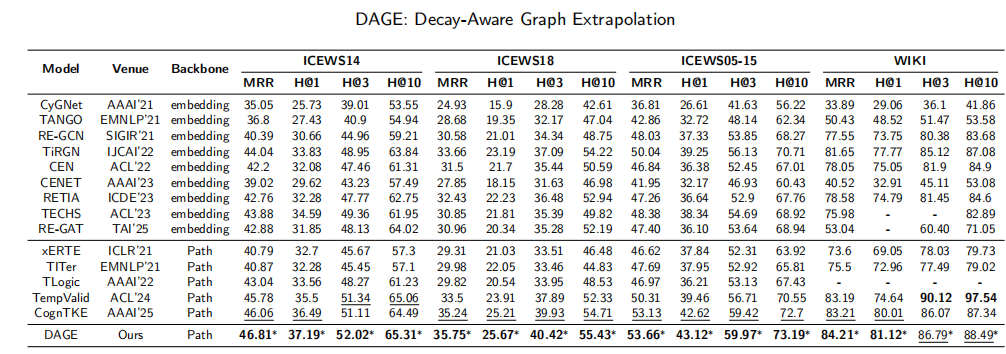
可以看到DAGE的数据达到了sota的级别。
RQ2:消融实验结果如下图所示:
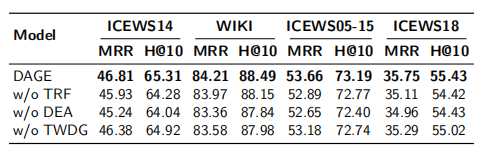
观察消融实验结果可知,每个模块对模型的预测能力都起到了作用,如果没有TRF和DEA两个模块,模型的性能掉的相对多些,这两个模块恰好为融入了时间信息的模块,说明融入时间信息对TKGC的任务极其重要。但是消除TWDG模块对模型的影响没有那么大,该模块仅仅是对路径做了一些初步的筛选,使得一些无意义的事实被过滤,但是由于有无该模块效果都差不多,且该模块剪枝是统一标准、硬性的,故能否考虑使用一些软衰减,让更多事实加入路径,并让各路径事实的信息衰减在DEA中完成。
RQ3:超参数对模型的影响结果如下图所示:
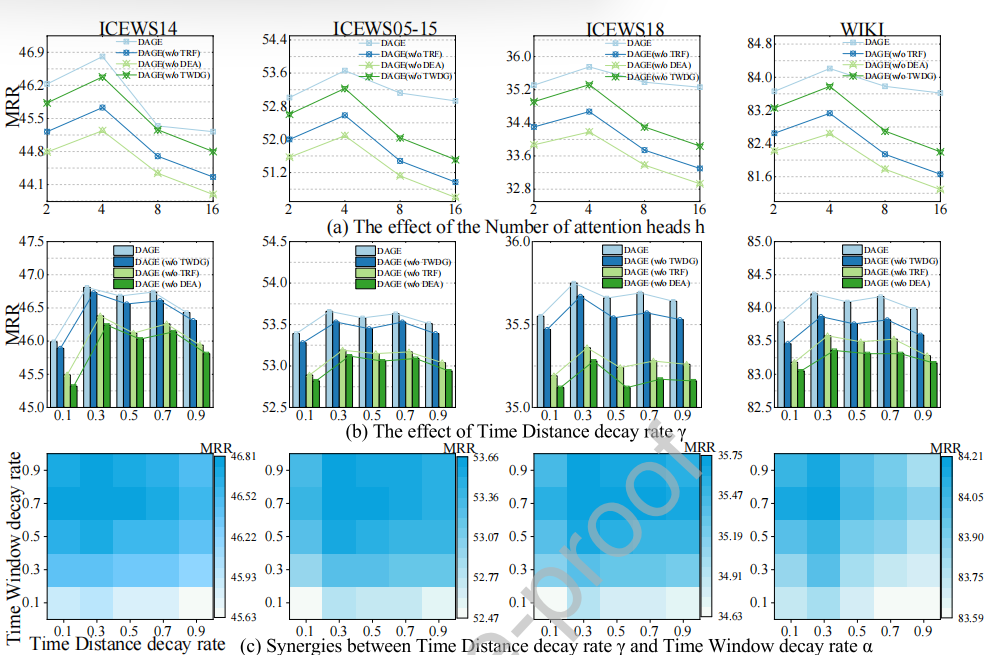
从超参数的结果可以发现,时间衰减率在0.3和0.7的时候效果都很好,但是在0.1的时候效果不是很好,说明考虑时间衰减的影响是合理的。当时间衰减率在0.3时,消息并未过多考虑时间衰减,主要还是本身的消息占主导。当时间衰减率到0.5时,模型效果明显下降。到0.7时,模型效果再次上升,它控制消息衰减的速度,但具体的衰减效果还需要其与\(\Delta t\)共同决定。
RQ4:模型的时间泛化能力结果如下图所示:
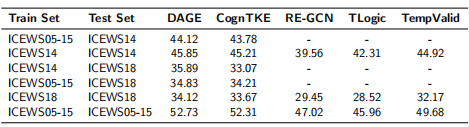
RQ5:案例分析示意图如下所示:
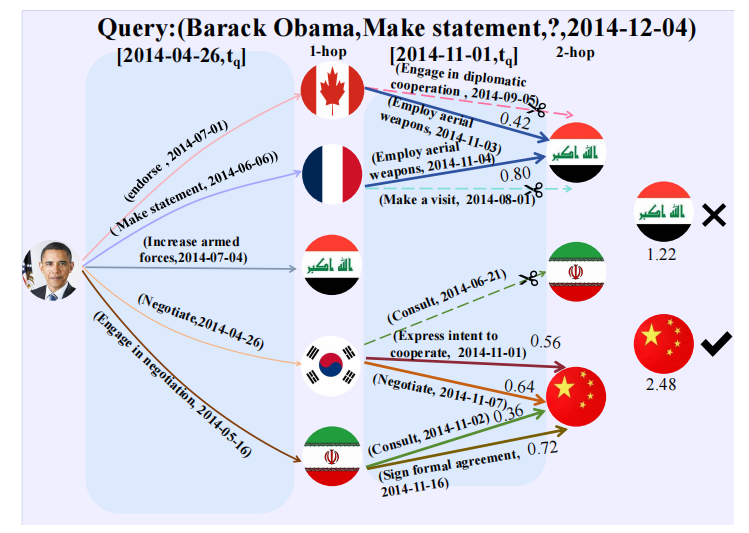
当预测的Query为\((Barack\ Obama,Make\ statement,?,2014-12-04)\)时,模型先按照上述方法构建一个TWG-Graph,对于超过时间窗口的事实,模型将直接进行剪枝。图中也体现了,一个实体可能会存在多条入度边的特点,一个局部通过注意力机制生成消息的示意图如下所示:
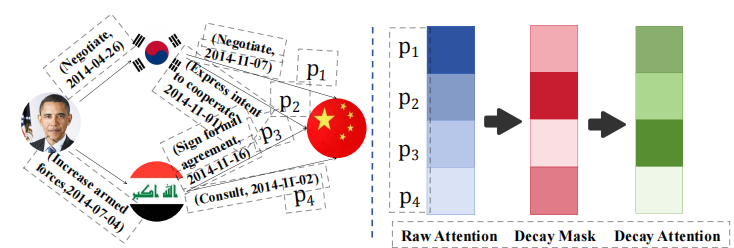
但是这张案例分析图并未体现出算法中每一层实体的自环,故图看起来与具体的实现不太相符,且不太完善。
RQ6:模型训练时长图如下图所示:
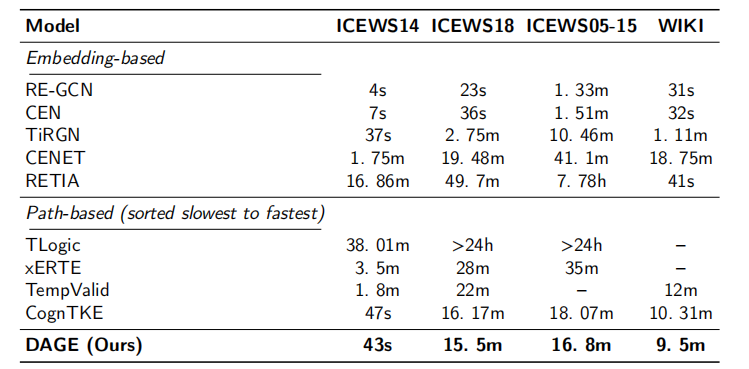
可以看到,DAGE在基于路径的方法中,训练时长最短,说明提前筛选出一些无用的路径对训练存在一定程度的帮助。
论文总结
论文目前只支持预测客体实体,可以进一步扩展到预测主体实体和关系。
多维度总结这篇论文,可以概括如下:
- 论文提出时序衰减这个概念,指的是随着时间距离的不断增大,消息的影响力也应该相对的打一个折扣。这个想法从理论角度出发是可行且有意思的,而且确实符合人的认知。
- 论文提出的DAGE是一种基于路径的时序知识图谱外延方法,关键在于如何寻找路径,以及如何将时间融入进关系,如何将衰减的特征融入进传递的信息。论文的做法为:
- 在构建子图的过程中,减少高阶邻居的时序窗口,让经过了很多中间过程才到达的实体尽可能在最近的时间寻找关系。但是消融实验证明,这个模块哪怕删除也没对最后的模型起到太大的影响,相反,筛选反而可能会由于因子\(\alpha\)控制不当,导致删除某些有用的路径,故该模块可能可以从每一层固定删除一些窗口变成非固定但软衰减一些窗口。
- 对每个时间距离进行周期性的嵌入,再将该具有周期性特征的时间嵌入融入进关系中,得到融入时间信息的关系嵌入。这点思路可行,但是实现有点问题。作者的想法是,不同的时间距离对同一个关系的表示可能会有一些影响,故用了一个类似于Transformer的公式,由关系的嵌入提供Query,时间距离的嵌入提供Key和Value。以此来判断每个时间距离对该关系应该保留多少信息。但是公式使用了一个\(Softmax\)函数,对于每个时间的关系,其时间距离也是唯一的,因此\(Softmax\)函数中只有一项,故得到的结果也应该恒为1,也就是说,最后时间信息还是全部被嵌入进了关系中,并未起到筛选的作用。该公式去除\(Softmax\)函数,或者将\(Softmax\)函数换成一个门控函数,来实现过滤的效果。
- 继续对时间进行一个周期性和非线性的增强,并将该增强用于后续模块。该模块对时间的处理貌似过于繁琐,既然在后面也需要增强时间,为什么在前面对关系进行嵌入时,就不直接使用增加后的时间嵌入呢?或许可以将该模块移动到前面,再用该模块得到的时间嵌入用于与关系融合。
- 消息传递过程,从头实体出发,逐层向下传递消息,消息由(源实体,融入时间的关系,待查询实体)组成,通过门控函数得到初始消息,再将该消息与时间融合,得到带有时序特征的消息。既然消息可以融入时间的周期性和非线性,那关系也更理应融合时间的这两个特性。由于一个实体可能存在多条入度边,对于每一层,先计算每条边对其的初始贡献,以及每条边的衰减率,将衰减率与初始贡献相乘,得到最后的贡献。将该贡献乘上对应边带来的消息并求和,得到实体在该层获得的消息,与上一层嵌入经过一个GRU函数,得到新的嵌入。思路没有问题,但是实现的过程中使用了大量的门控函数,可能会略显繁杂。
对这篇论文方法的修改也许可以按如下方式进行:
- 构建时序衰减子图不再按照每一层固定一个时间窗口进行,而是受到,相似的实体可能会具有一定的相似度这一思想的启发,先生成一个计算实体相似度的模块,对于高相似度实体,允许其查找的时间窗口更大;对于低相似度实体,其被允许查找的时间窗口将更小,每个实体只允许查找一遍。这个做法将每层不加考虑的固定剪枝变成了根据相似度进行剪枝。
- 调整模块结构,不再先对关系进行周期性处理,直接删除该模块,并将生成\(F_{\Delta t}\)的模块上移,用该模块生成的时间距离嵌入与关系嵌入融合。
- 减少公式复杂性,公式用了大量的门控函数,每个门控函数是否都真的有必要,以及门控函数是否能被替换成其它函数,都是值得思考的问题。
以上为对这篇论文的总结与思考。
\(Fin.\)