从一篇基于知识图谱的医学影响分析推理的综述入手:
Knowledge Graph Based Reasoning in Medical Image Analysis: A Scoping Review,发表于2024年,作者单位为西北工业大学。
综述主要从知识图谱(Knowledge Graph,KG)入手,说明KG在该领域的作用,并回顾医学影响分析在过去的发展以及未来的可研究方向
背景:电脑硬件和人工智能不断的发展使得计算机辅助诊断(Automated Computer-aided diagnosis,CAD)变得越来越重要,KG在过去已经在各个领域上发挥了至关重要的作用,因此,尝试将KG和CAD联合有助于解决相关的医学类问题。
引言及背景介绍
专家系统的诞生
专家系统(Expert System)指的是通过不断学习领域的相关知识,从而达到该领域专家的一种系统。依赖于机器学习和深度学习以及大量数据集训练出来的模型具备很强的黑盒性,专家系统相较于模型能更好的按照逻辑输出一条答案链,因此,对于CAD来说,专家系统是更具有逻辑性、可解释性的。
图像扫描设备
图像扫描主流有三个设备,分别是:
- ultrasound(US):该设备的成像效果依赖于设备的质量以及扫描医生的技术,但是门槛是最低的
- X-ray,computed tomography(CT):该设备生成的图像质量更稳固且精准,但是该设备更为昂贵且含有辐射
- Magnetic Reso nance Imaging (MRI):该设备生成的图像质量更高,且没有辐射,但是该设备十分昂贵
从扫描来的图像中提取公共特点并做分类是计算机视觉中图像处理的任务。因此,出现了很多利用机器学习的方法来对医学图像进行处理,如迁移学习、多模态等等,但是这些方法在本质上都具有黑盒的特性,无法很好解释答案从何而来,于是,领域专家系统被应用,该系统可以基于语义网络,知识图谱等。
知识图谱于2012年被Google重新定义,其目标是组织全世界产生的大规模数据。随着人工只能以及电脑硬件的不断发展,知识图谱也迎来了黄金发展期,因此,本综述尝试探索知识图谱与智能医学图像的结合。
知识图谱的发展
知识图谱指的是由多个三元组(或更复杂的元组)组成的图结构,一条三元组由头实体、尾实体以及关系构成。由于知识图谱天生存在内容的不准确性、内容的缺失等问题,故如何构造一个准确、完整的知识图谱成为了一个研究方向,该方向被称为知识图谱补全(Knowledge Graph Completion,KGC)或链路预测(Link Prediction)。
实现KGC最基本的方法为基于规则的方法,通过两条甚至更多条规则的约束,得到一个缺失的三元组。如:
(肿瘤,边界,不清晰) ∧ (肿瘤,形状,不规则) ⇒ (肿瘤,病理性质,恶性)
规则可以通过专家系统构建。
KGC 的主要任务是基于知识图谱中已有实体、关系和结构信息,预测图谱中缺失或未知的事实。
KGC经历了如下几个阶段。
第一阶段:以TransE为代表的平移模型
该类模型通过在空间中表示头实体和关系,利用\(h+r = t\)来预测尾实体。数据集中本就存在的三元组被称作正三元组,为现实世界中真实发生的事实,为了让模型能够正确区分真实事件和虚假事件,数据集会被人为替换头尾实体,以构建一个个负三元组,模型在学习的过程中需要让正三元组的得分尽可能高,让负三元组的得分尽可能低。后续的平移模型通过将实体、关系映射到两个不同的空间后再进行平移,以实现对实体和关系的区分。
第二阶段:以RESCAL为代表的张量分解模型
平移模型更像是从头实体经过平移得到尾实体,张量分解模型将整个知识图谱看作由“头实体 × 关系 × 尾实体”构成的三维张量,每一个候选三元组对应张量中的一个元素或格子,不同的模型通过不同的打分函数以区分新预测事实的标签是否应该为1,即预测的事实是否成立。
第三阶段:图神经网络模型
图神经网络(Graph Neural Network, GNN)更注重图的结构信息,实体和关系在每一层中通过学习结构信息以更新嵌入,到最后图中的嵌入更具有全局性。但是图中不同部分对实体和关系的影响可能不一致,因此在GNN中引入卷积操作可以得到图卷积网络(Graph Convolutional Network, GCN)。普通 GCN 主要是根据邻接矩阵和度矩阵进行归一化聚合,再通过共享的权重矩阵更新节点表示,但是在GCN中,不同的关系并未被区分,于是引入多关系图卷积网络(R-GCN)。R-GCN 在聚合邻居节点信息时,为不同关系类型引入关系特定的权重矩阵,从而区分不同关系语义对节点表示更新的影响。
第四阶段:大语言模型(Large Language Model,LLM)阶段(发展中)
利用LLM强大的自然语言处理能力,通过类似于问答,路径推理等形式,让大语言模型给出预测的答案。基于LLM的KGC在形式上分为两种,第一种是微调,通过微调大语言模型,让其更加适配某项任务;第二种是不微调,而是更为专注于提示词,通过提示词让大语言模型直接输出问题的答案。
知识图谱与医学影像结合的方法以及不足
由于CAD的快速发展,将现有医学知识以可嵌入的形式辅助计算机诊断是极为重要的。知识图谱作为一种结构化知识的表达方式,可以很好承担这一项任务。但在医学领域中,核心数据大多是以图像的形式出现的,如各种CT扫描图像,这类数据并非结构化数据,因此在处理前还需要利用深度学习模型**提取其中的一些特征,再将其转换为结构化数据。
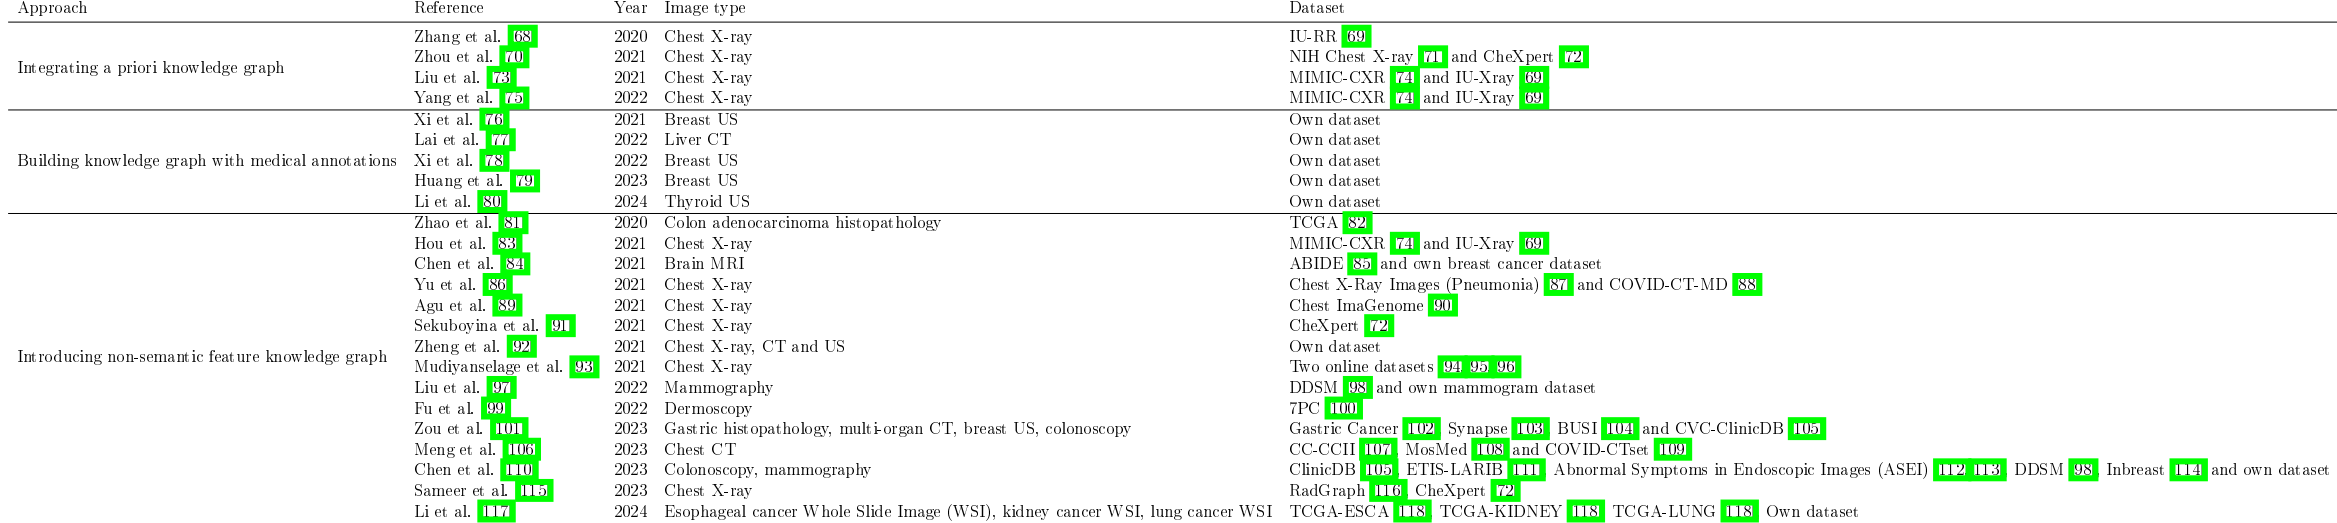
知识图谱与医学影像结合的方式主要分为三种,分别是融入先验知识图谱、医学标注知识图谱、非语义特征知识图谱。近年来各论文的方法如下表所示:
融入先验知识图谱:
该方向中的知识图谱为提前构建,且可能经过预训练,模型仅仅将知识图谱当作一个辅助信息用于协助自身判断。例如:模型事先知道(边界不清,提示,恶性风险高),(形状不规则,提示,恶性风险高),(纵横比大于1,提示,恶性风险高),如果此时有一个经过模型提取信息的病例提示,图像中存在一个边界不清、形状不规则、纵横比大于1的结节,那么模型会根据借助知识图谱对该病例进行判断。该方法相比之下可能不那么黑箱,但是其可解释性依旧较弱。
医学标注知识图谱:
该方法的知识图谱为人工构建,医生先通过标注的方法,对某些医学图像或者病例进行标注,如对于乳腺超声BI-RADS,医生会先标注病灶的大小、边界、形状、回声等特性,再利用这些标注构建一个知识图谱。如:(患者A,具有,病灶1),(病灶1,形状,不规则),(病灶1,回声,低回声)等等。当有新的患者也具有病灶,且知道病灶的一些特性,那么模型就可以根据标注得来的知识图谱进行推理,判断该病灶属于恶性或是良性。
非语义特征知识图谱:
这一类知识图谱和传统的知识图谱不一致,相比于每一个节点和关系都具有清晰语义的知识图谱,这类知识图谱的节点可能由经过CNN后图像的每一个Patch、图像嵌入的每一个维度等构成,关系则可能是每一个维度之间的相关性等等。这类方法将病例的一些更细粒度的特征抽象成图结构,利用GCN等学习该类病例的特征,当有新的病例出现时,模型可以根据已学到的知识判断其属于哪一种病状。
三类方法的大致流程图如下图所示:
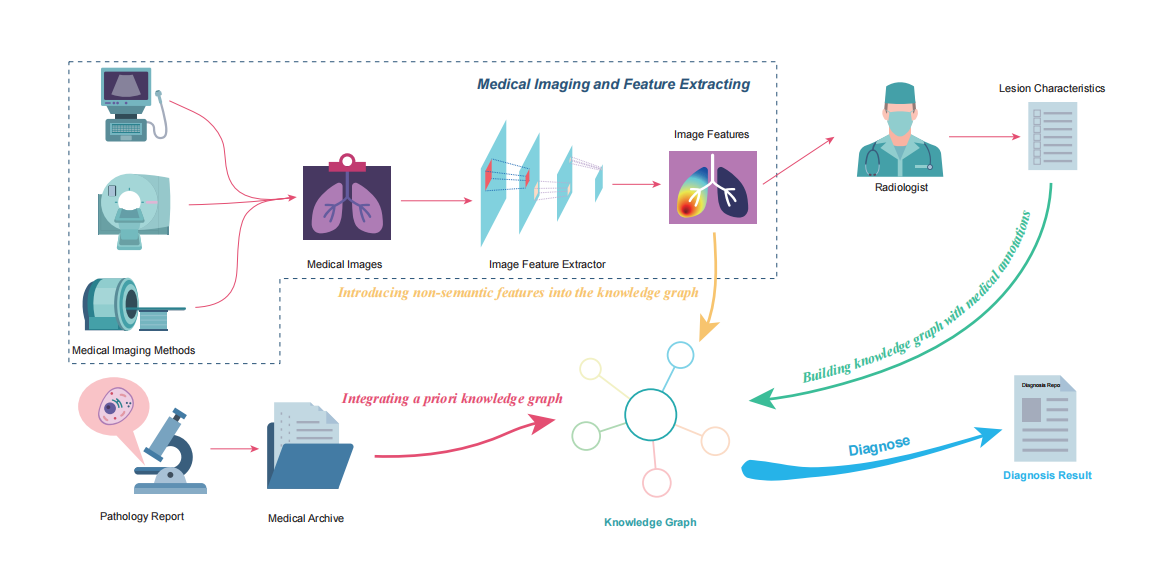
这三类方法各有各的缺点,对于第三类非语义特征知识图谱,具体流程是人为定义一种构图方式,模型通过这种方式提取图中的特征以构建一个非传统意义上的知识图谱,并通过学习该图来实现对新病例的泛化。但是这种方法具有非常强的黑盒性,模型通过提取到的特征学习,但是无法解释到底学到了什么信息,这对于医学这种需要极强可解释性兜底的领域来说是没那么容易接受的。
对于融入先验知识图谱和医学标注知识图谱,这两类方法的思想其实都是通过知识图谱辅助模型进行判断。但是这类方法存在几个问题:
第一:这些方法用到的知识图谱大多是静态的图谱,没有处理患者的多次检查、病灶的随访变化、疾病进展等时间信息,因此可以引入将时序知识图谱与智能医学图像结合以用于计算机辅助诊断的方向。
第二:这些方法的可泛化能力较弱,仅仅能某些特定的领域。如在肺部领域构建了知识图谱并用于辅助模型诊断后,如需在脑部领域辅助模型诊断,则需要重新构建知识图谱。
第三:这些方法对数据质量的要求极高,如果数据中存在某些明显的噪声,那么会在极大的程度下影响构建的图谱的质量,从而影响模型的判断。
三类方法的优缺点对比分别如下图所示:
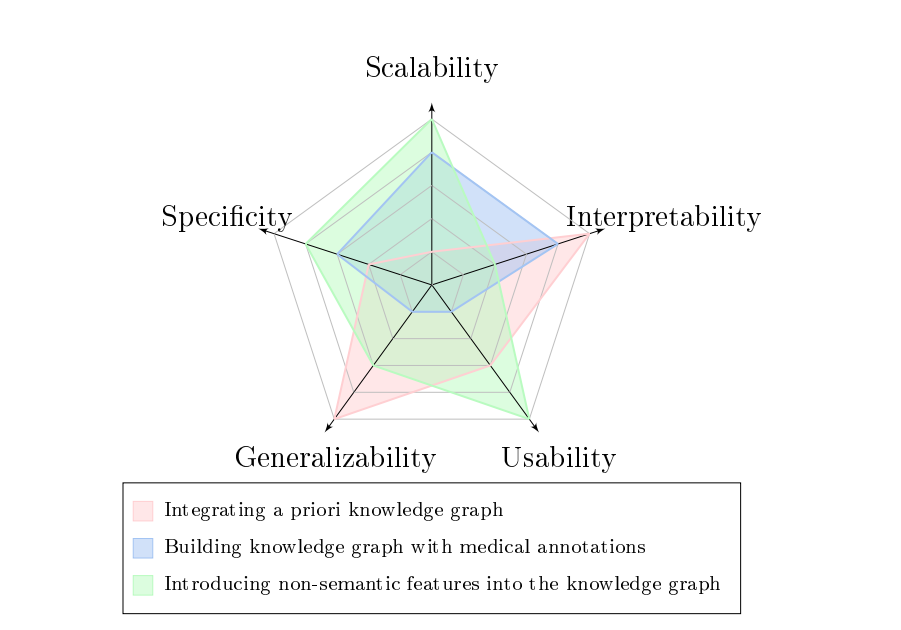
可解释性表示模型推理过程和结果能够被人类理解的程度;可扩展性表示模型整合新数据的能力;特异性表示模型在特定任务上的表现,通常指某篇研究论文中针对目标疾病诊断任务的性能;泛化性表示模型迁移到其他数据来源或其他疾病类型数据集时的表现;可用性表示除原研究者之外的其他用户,例如其他研究团队或工业界用户,使用和部署该模型所需付出的努力。
对研究未来的展望
作者认为研究可以分为四个方向,分别针对可解释性、小规模知识图谱、跨语义通用知识图谱、与大语言模型结合。四个方向可以分别从如下方式入手:
可解释性:当前方法的上游任务为从医学图像或是其它医学相关知识中提取特征,下游任务为利用知识图谱辅助模型进行推理训练。下游任务在知识图谱的帮助下具有一定的可解释性,但是上游任务的特征提取可解释性较弱,如果可以让知识图谱介入上游任务,那么方法的可解释性将更强。
小规模知识图谱:数据的不足一直为医学领域的一大痛点,相比于需要大规模数据集进行训练的深度学习模型,小规模数据集构建的知识图谱具有更强的可解释性和语义性,从而降低对大规模数据集的依赖。但是现在仍然缺乏一种通用的构建小规模知识图谱的范式,且由于知识图谱规模过小,极有可能存在过拟合或欠拟合的问题。如果可以将知识图谱用于上游任务中,那么模型的性能也会变得更好。
跨语义通用知识图谱:当前知识图谱聚焦于某一个领域,而非跨语义的,如前文提到的肺部知识图谱和脑部知识图谱,两者之间会存在一些共性,但是区分到具体的细节病灶上又略有不同,因此需要构建一个跨语义通用的知识图谱,该知识图谱目标是结合多领域的知识,以具有极强的泛化能力。
与大语言模型结合:利用大语言模型强大的自然语言处理能力以及推理能力,对知识图谱进行嵌入、补全,使得知识图谱的具有更高的质量。同时,大语言模型也可用作多模态,同时处理图像、文本等信息。
论文写作框架
第一部分:介绍现有医学方法,说明当前一共有哪三种医学影像和知识图谱结合的方法,列出不同方法的缺陷,重点强调知识图谱是静态的,没有将患者病情动态的变换纳入进知识图谱的考虑中,从而引出时序知识图谱(Temporal Knowledge Graph,TKG)的概念。
第二部分:介绍TKG的发展脉络,类似于这篇综述,系统介绍TKG旨在解决什么问题,当前一共有哪些TKG方法,TKG的任务种类,并主要将外推部分带入,说明外推任务为更适合和医学图像结合的一类任务。
第三部分:系统介绍将TKG引入医学影像可以解决什么问题,针对文中提到的两类方法,用TKG进行改良可以带来什么效果,并提出一种大致框架(此处补一个提取的流程图),以构建时序知识图谱。
第四部分:总结与展望。
\(Fin.\)